用自然语言告诉 AI 要什么,看效果,不满意就再说一句,这种 Vibe Coding 的方式已经能在几天内做出一个能用的产品。但产品真的有人用、流量涌进来以后,事情往往会变得不一样。
2026 年 3 月,有两篇文章把这个问题摆到了台面上:Every 的 CEO Dan Shipper 复盘了他纯 Vibe Coding 做出的文档编辑器 Proof 上线后反复崩溃的经过;Val Town 创始人 Steve Krouse 随后写了一篇《Reports of code's death are greatly exaggerated》,回应“代码已死”的说法。
这篇文章适合正在用 Claude Code、Codex 这类工具写项目,想知道 Vibe Coding 的局限在哪、什么项目可以放心交给 AI、什么项目必须自己看懂代码的开发者。下面依次讲 Proof 的经历、Steve Krouse 的观点、Vibe Coding 适用和不适用的场景,以及几条可以直接用上的做法。
Proof 上线后发生了什么
Dan Shipper 不是编程新手,他写了好几年 AI 编程专栏。Proof 是一个面向 Agent 的协作文档编辑器,他一边管理一家二十多人的公司,一边几乎全程用 Vibe Coding 做出了这个产品。
按他在文章里给出的数字:
- 最初的提交从 1 月初开始,后来从 macOS 应用改成纯 Web 版,上线的这个版本大约只做了 10 天;
- 仓库有大约 1600 次提交、600 多个 PR、约 14 万行代码;
- 作为对比,2020 到 2024 年间全职开发者每年提交次数的中位数是 417 次。
他主要用的是 OpenAI 的 Codex 桌面应用,后期还用上了 Codex 的子代理:一个子代理负责把最新修复推上线,一个盯新的报错,一个去写最高优先级问题的修复,再由一个编排者统一管理(子代理的用法可以参考 Codex 子代理,让主线程保持干净并行处理任务)。
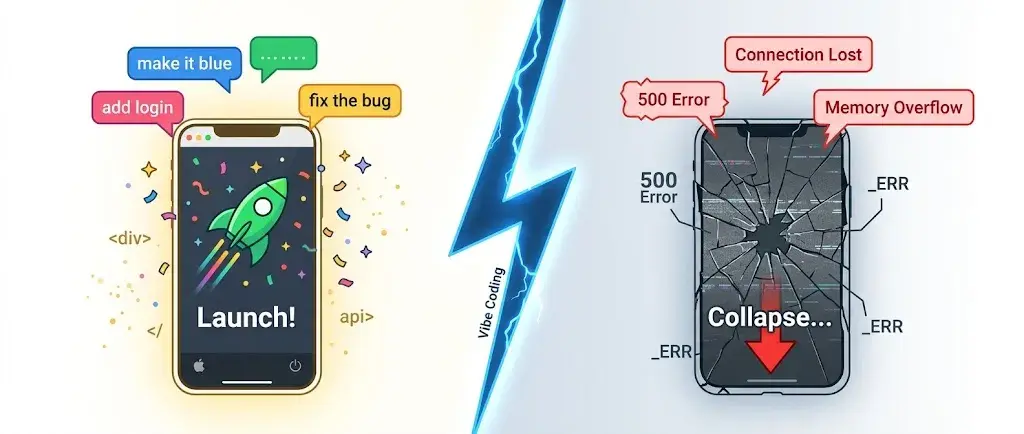
上线后,用户在一天内创建了 4000 多份文档,应用却整天莫名崩溃。凌晨 4 点,他还在看着 Codex 一遍遍排查埋在他自己都看不懂的代码深处的 bug。大约一周后,Proof 才基本稳定下来。
他的结论是:能用 Vibe Coding 写出来的东西,也能用 Vibe Coding 修好,只是不一定修得快。
Dan Shipper 总结的三个瓶颈
Dan 在复盘里列出了 AI 编程模型目前还做不好的几件事,这几条比“爆火后崩了”本身更值得记下来:
- 只修局部,不找根因。 模型倾向于修眼前这个报错,而不是先退一步找根本原因。没人引导的话,代码库会变成一堆互相打架的热修复。
- 不一定知道最佳实践。 Proof 基于 Yjs 和 Hocuspocus 这两个开源协作编辑库,他用了一周才意识到 Yjs 的最佳实践并不在模型的训练数据里,模型因此没发现一些明显的架构问题。让模型动手前先做充分的网络调研能缓解大部分问题,但前提是这些实践在网上找得到。
- 最终能找到答案,但需要反馈循环。 每个修复都要经过审查、本地测试、预发布测试、上线、监控。代码库小的时候循环很快,代码库大了,一轮可能要几个小时。
他还提到一点:每次修 bug 都像一次科学实验,提出假设、写修复、部署、观察。有经验的工程师能凭以往的失败经验快速缩小范围,少做很多轮实验,这正是 AI 替代不了的部分。
Vibe Coding 的局限:自然语言总比你以为的更模糊
Steve Krouse 的文章从罗素的一句话开始:“一切事物的模糊程度,都远超你的意识,直到你试图把它变精确。”
他认为 Vibe Coding 这个叫法很贴切:你一直停留在“感觉”的层面,对 AI 生成的结果做反应,比如“把按钮挪到那边”“颜色再蓝一点”,借此一步步把想法变清楚。
问题在于,Vibe Coding 会让人产生一种错觉:你的感觉就是精确的抽象。 这种感觉会一直持续到它“漏”的那一刻,通常是功能加到一定数量,或者用户规模上来的时候。那些从你不理解的底层冒出来的意外行为,就是 bug。
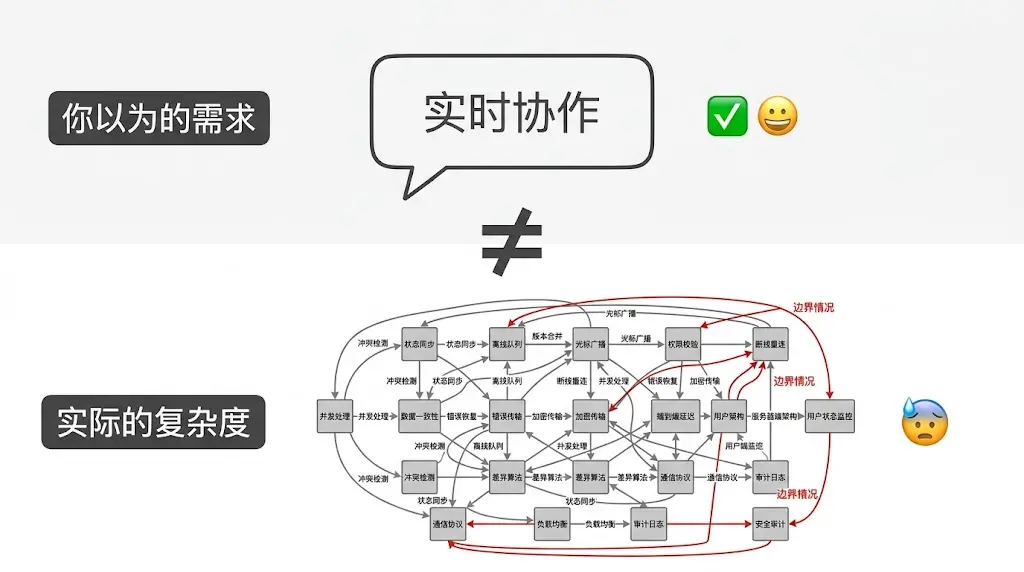
“实时协作”就是一个典型例子。我们天天用 Google Docs 和 Notion,所以会觉得这四个字已经是很清楚的需求了。Steve 说他十年前也给产品加过协作编辑,结果是一场意想不到的复杂度噩梦,而且他已经不记得具体难在哪了。复杂度往往很枯燥、很难记住,全是细节和边界情况。他举的另一个例子是 Slack 决定何时给你发通知的流程图,用自然语言说只是“发通知”三个字,画出来却密密麻麻。
抽象才是驾驭复杂度的工具
Steve 没有停在“Vibe Coding 不行”上。他接着讲抽象:人脑一次只能处理 7 个左右(加减 2)的信息,想处理更多,就得把多件事压缩成一件事,并且可以层层递归地压缩下去,这一步就是抽象。
他引用了 Dijkstra 的话:“抽象的目的不是变得模糊,而是创造一个新的语义层,在这个层面上你可以做到绝对精确。”
React、TailwindCSS 都是在各自领域用抽象驾驭复杂度的例子。协作编辑器本质上就很复杂,这只说明我们还需要更好的抽象。在 Steve 看来,设计好的抽象是编程里最有价值的部分。
代码没有死:为什么没人谈“Vibe Writing”
文章最尖锐的一段是对“代码已死”的反驳。Steve 说,好像 99% 的人都认定编程要死了,这就跟“印刷术发明了,讲故事就死了”一样荒谬。
他的类比是写作:为什么没人讨论“Vibe Writing”?没人觉得 ChatGPT 会让优秀的小说家和记者失业,因为一段语法正确但空洞的文字,谁都能看出来。代码不一样,能跑起来的程序会给人一种“已经完成”的错觉,但 AI 写出来的代码,目前质量还不够好,大家都在绕着这个限制用 AI。
他也展望了更远的将来:即便有一天真的有了与人类无异的机器智能,我们最先做的也不会是生产更多低质量代码,而是用它解决最难的抽象问题,做出更好的抽象,帮人理解和掌控更高层次的复杂度。
哪些项目适合 Vibe Coding,哪些不适合
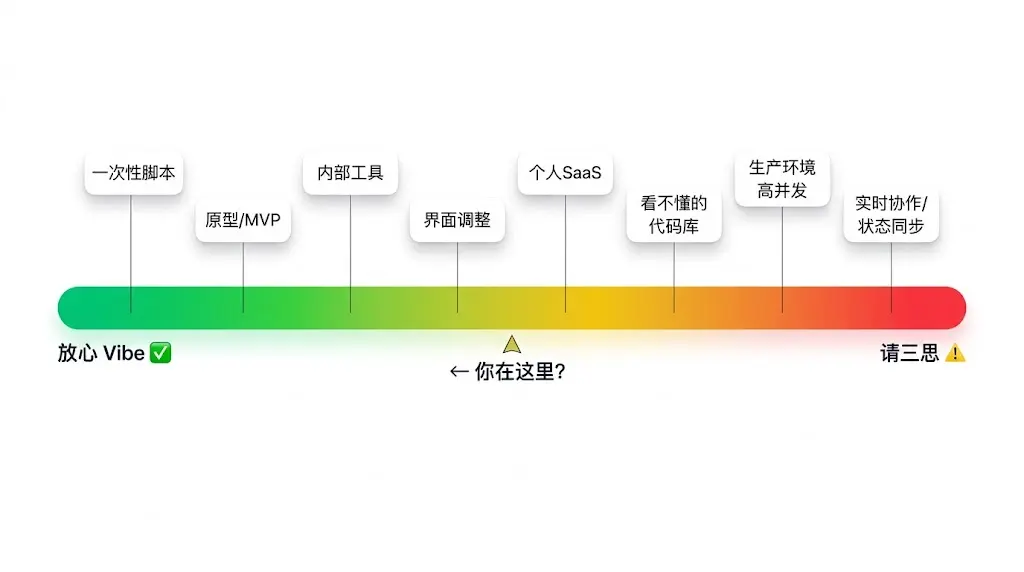
把两篇文章的经验合起来,边界大致如下:
| 场景 | 是否适合纯 Vibe Coding | 原因 |
|---|---|---|
| 原型验证、MVP、内部工具 | 适合 | 目标是快速验证想法,出问题影响小 |
| 个人项目、一次性脚本 | 适合 | 不需要长期维护,也不承载真实流量 |
| 界面调整、样式修改 | 适合 | 不涉及深层逻辑,效果一眼可见 |
| 承受真实流量的生产环境 | 不适合 | 规模上来后底层问题会暴露,修复周期长 |
| 实时协作、并发、状态同步 | 不适合 | 本质复杂,自然语言描述远不够精确 |
| 完全看不懂生成代码的项目 | 不适合 | 出问题时连排查方向都没有 |
| 需要长期维护的项目 | 不适合 | 几个月后人和 AI 都可能读不懂这堆代码 |
用 AI 写生产项目时可以怎么做
结合 Dan Shipper 列出的瓶颈,下面几条做法可以减少“爆火后崩了”的风险:
- 让 AI 先找根因再修。 出 bug 时先要求它解释问题出在哪一层、为什么会发生,再动手改,避免代码库变成热修复的拼凑。
- 动手前先做调研。 用到协作编辑、消息队列这类专门领域的库时,先让 AI 查官方文档和社区最佳实践,再设计方案。
- 把反馈循环搭好。 测试、预发布环境、上线后的监控提前准备好,循环越短,AI 修 bug 越快。
- 关键路径的代码自己要看懂。 至少在数据一致性、并发、鉴权这些地方,人得能判断 AI 的方案对不对。也可以让另一个模型做代码审查,具体做法见 Codex 接入 GitHub 后先做高信号 Review,Merge 仍由人决定。
总结
Dan Shipper 10 天做出 14 万行代码的产品,说明 Vibe Coding 确实把“做出来”的门槛降到了很低。但“做出来”和“撑得住”是两回事:需求越复杂、规模越大,自然语言的模糊就越会变成代码里的 bug,而懂代码的人能更快找到问题。
所以结论不是别用 Vibe Coding,而是用它走得更快,同时清楚自己在造什么。想在 Claude Code 或 Codex 里按这套思路做项目,可以在 AIGoCode 上直接使用这两款工具。
参考链接
- Steve Krouse,Reports of code's death are greatly exaggerated:https://stevekrouse.com/precision
- Dan Shipper,When Your Vibe Coded App Goes Viral—And Then Goes Down:https://every.to/chain-of-thought/when-your-vibe-coded-app-goes-viral-and-then-goes-down