做资料研究时,常见的用法是把 PDF、网页和笔记丢进一个知识库,再向模型提问。底层多半是 RAG:每次提问都临时检索片段、拼起来生成回答。NotebookLM、ChatGPT 的文件上传,以及不少知识库产品,走的都是这条路。
它能用。可如果你连续几周研究同一个课题,会发现一个别扭的地方:上周已经整理过的对比、上个月标出来的矛盾,这次提问还得重新翻一遍。模型没有把中间结论留下来。
2026 年 4 月 4 日,Andrej Karpathy 在 GitHub 上发了一份名为 LLM Wiki 的 gist。他自己把它叫做 idea file:不是一个装好就能用的软件,而是一份可以粘贴给 Claude Code、Codex、OpenCode 这类编程 Agent 的思路说明,具体目录和规则要你跟 Agent 一起搭。
本文对照这份官方 gist,把 RAG 和 LLM Wiki 的差别、三层结构和三种操作讲清楚,并说明怎么开始、以及它明确不负责的部分。
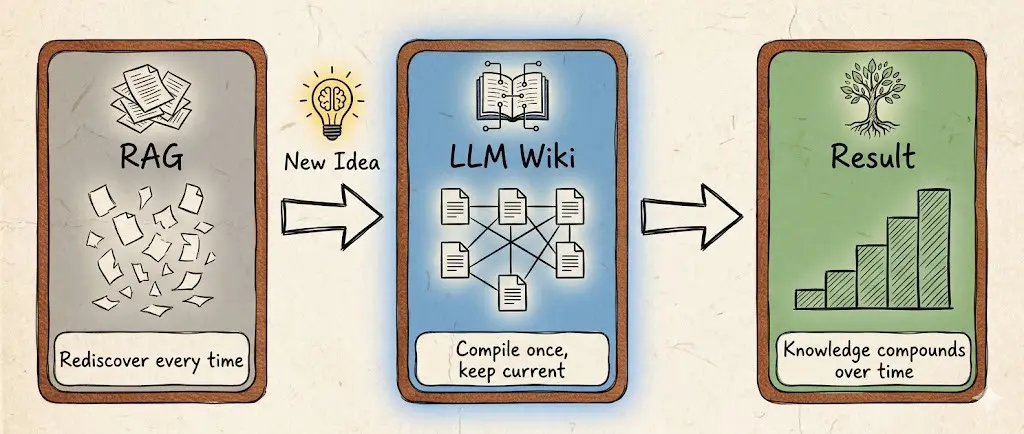
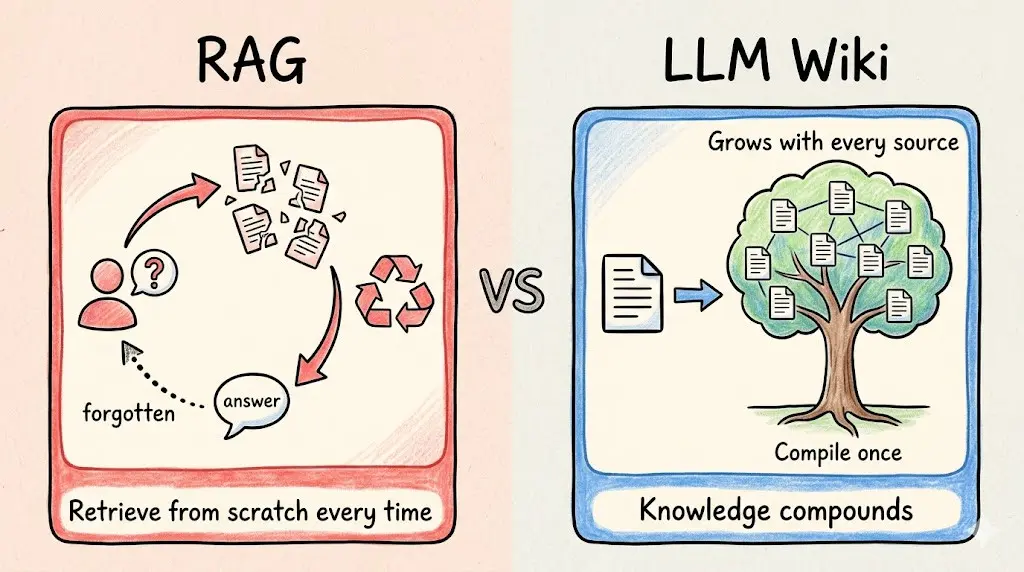
RAG 解决检索,但不积累
RAG 的工作方式是:资料先被切块、建索引,提问时再找出相关片段。优点很直接,上手快,也不用先维护一套页面。
缺点同样直接。Karpathy 的原话是:模型每次都在从零发现知识,没有积累。一个需要综合五份文档才能回答的问题,它每次都得重新把相关碎片找出来拼上。
如果你只是偶尔问一句「这份 PDF 里怎么说」,RAG 通常够用。如果你希望知识库会随着阅读变厚,而不是每次对话结束后又变回一堆原文,那就该换一种组织方式。
LLM Wiki 把知识编译成会生长的页面
LLM Wiki 的核心不是查询时再检索原文,而是让模型持续维护一个由 Markdown 页面组成的 Wiki。新资料加进来时,模型先阅读、抽取要点,再写进已有页面:更新实体页、修订主题摘要、标出新旧说法的冲突,并补上交叉引用。
gist 里把这种差别概括成:知识是先编译、再保持更新,而不是每次提问都重新推导。交叉引用已经在页面里,矛盾已经被标过,综合结论也已经反映你读过的内容。
Karpathy 自己的用法是一边开着编程 Agent,一边开着 Obsidian。模型负责改 Wiki,人在 Obsidian 里点链接、看关系图、读更新后的页面。他的比喻是:Obsidian 是 IDE,LLM 是程序员,Wiki 是代码库。
你几乎不亲自写这些 Wiki 页面。人负责找资料、提出问题、判断哪些结论值得留下;模型负责摘要、交叉引用和记账式的维护。
三层分别管什么
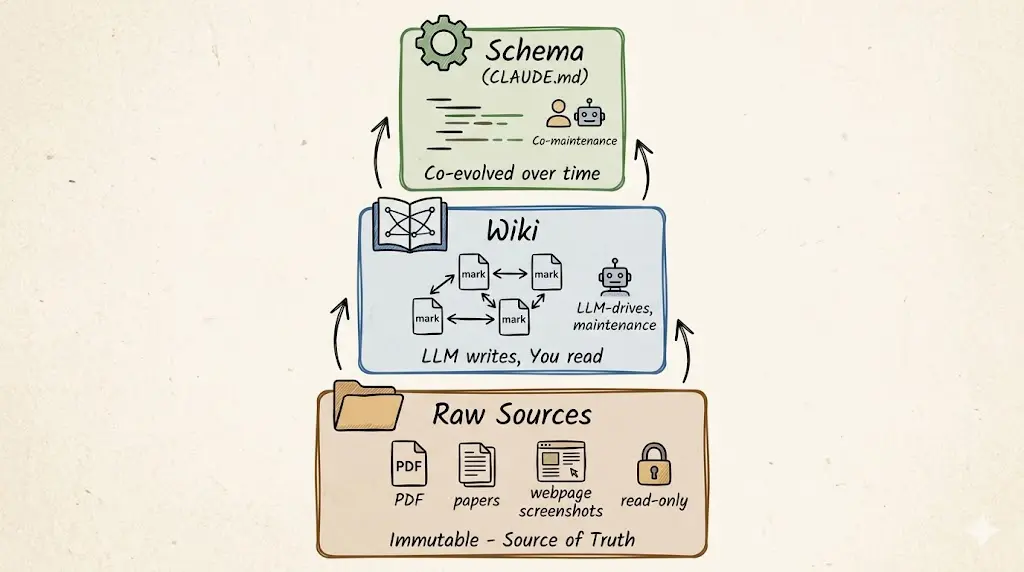
gist 把系统分成三层,职责分得很清楚。
原始资料层放你收集的文章、论文、图片和数据文件。这一层是只读的,模型可以读,不能改,作为信息源头。
Wiki 层是模型生成并维护的 Markdown 目录,里面有摘要页、实体页、概念页、对比和综述。这一层完全由模型负责:建页、更新、维持交叉引用。你读,它写。
Schema 是一份告诉模型「这个 Wiki 怎么组织」的规则文件,例如给 Claude Code 用的 CLAUDE.md,或给 Codex 用的 AGENTS.md。它规定页面约定,以及摄入资料、回答问题和做维护时该走的流程。gist 把它看作关键配置:有了它,模型才是按规矩维护 Wiki 的助手,而不是一个普通聊天机器人。这份文件也需要你和模型一起慢慢改,找到适合自己领域的写法。
三种操作:摄入、查询、审查
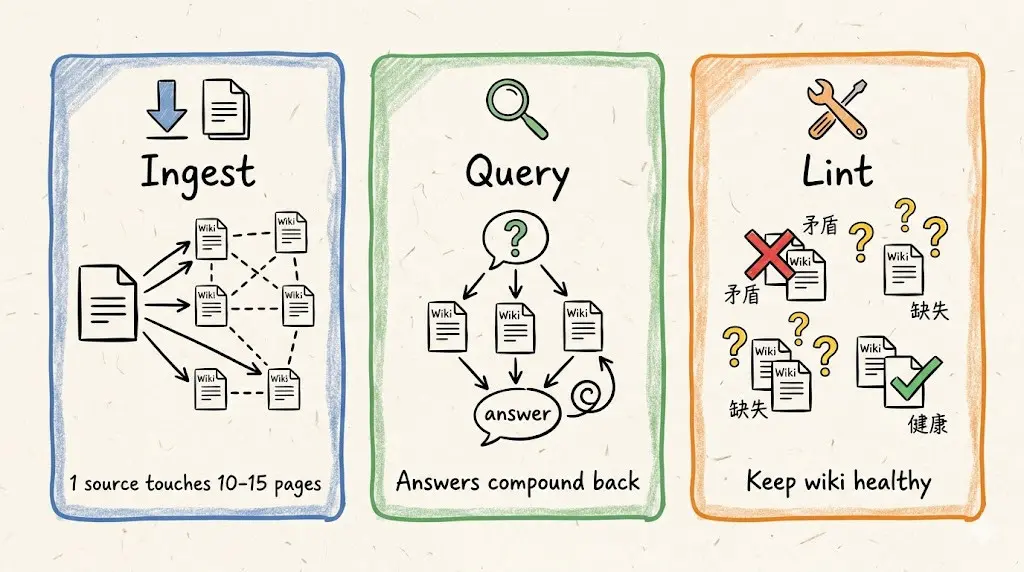
日常使用可以收成三件事。
摄入(Ingest):把一份新资料放进原始资料目录,让模型处理。一份典型流程是:先读资料,跟你讨论要点,再写摘要页、更新索引、改相关的实体页和概念页,并在日志里记一笔。gist 里举的例子是,一份资料可能会动到十几页。Karpathy 更倾向一次只摄入一份,自己先看摘要再往下走;也可以批量摄入,但要把你习惯的流程写进 Schema,方便下次会话接着用。
查询(Query):向 Wiki 提问。模型先找相关页面,读完后再综合回答,并带上引用。回答不一定是一段文字,gist 里还提到过 Markdown 页面、对比表、用 Marp 做的幻灯片,或用 matplotlib 画的图。更关键的一点是:好的回答可以存回 Wiki,变成新页面。一次对比分析、一次新发现的关联,不应该只留在聊天记录里。
审查(Lint):定期让模型做一次健康检查。gist 建议看这些地方:页面之间的矛盾、被新资料取代的旧说法、没有入链的孤儿页、被提到却还没有独立页面的概念、缺失的交叉引用,以及可以用检索补上的数据缺口。模型也可以据此建议下一步该问什么、该找哪类资料。
另外还有两个辅助文件。index.md 面向内容,给每个页面留链接和一行摘要,并可按类别组织;每次摄入后由模型更新。查询时可以先读索引,再进入具体页面。gist 认为,大约 100 份资料、数百个页面的规模,靠索引通常就够用,不必先上向量检索。log.md 是按时间追加的记录,记下摄入、查询和审查。如果每条都以统一前缀开头,用普通的文本搜索也能很快看到最近几条。
Wiki 变大之后,索引可能不够用。gist 把搜索工具写成可选项,并提到 qmd:一个面向 Markdown 的本地搜索引擎,混合 BM25 和向量检索,带 CLI,也提供 MCP 服务。你也可以让模型帮你写一个更简单的本地搜索脚本。不是一开始就必须装。
怎么开始用
这份 gist 是有意写得很抽象的。目录结构、页面格式和工具链都要按你的领域来定,上面提到的配件也都是可选的。官方建议的用法,是把它交给编程 Agent,一起实例化一套适合自己的版本。
可以按这个顺序开始:
- 建两个目录,例如 raw/ 放原始资料,wiki/ 放 Wiki 页面。
- 写一份初始 Schema,约定页面类型、命名方式和摄入流程,放到 CLAUDE.md 或 AGENTS.md 里。
- 先丢进几份你真正在用的资料,让模型做第一次摄入,你自己检查摘要和交叉引用。
- 把用着顺手的规则写回 Schema,下次会话接着用。
如果用 Obsidian 浏览 Wiki,gist 还提了几个可选技巧:用官方的 Web Clipper 把网页存成 Markdown;把图片下载到本地目录,避免外链失效;用关系图查看哪些页面是枢纽、哪些是孤儿页;需要的话再配 Marp 做幻灯片,或用 Dataview 按 frontmatter 做动态列表。Wiki 本身就是一个 Markdown 的 git 仓库,版本历史和协作可以直接复用 git。
已经在用 claude-mem 给 Claude Code 留跨会话记忆的人,可以把 LLM Wiki 看成另一层:mem 记住的是对话里的经验,Wiki 沉淀的是按主题组织好的页面。如果你习惯在 Obsidian 里工作,也可以对照 Claudian 的用法,看要不要让 Claude Code 直接在笔记库里改这些页面。
它不适合什么场景
先把边界说清楚:这不是开箱即用的产品,也没有官方安装包。你需要自己准备 Agent、设计 Schema,并且愿意花时间检查模型写出来的页面。gist 也写了,维护负担之所以能降下来,是因为模型可以一次改很多文件;但页面质量仍然要人看。
只是偶尔查一份文档、不想维护目录的人,继续用 RAG 或 NotebookLM 这类工具会更省事。资料很少、只需要一个文件夹的,也不必先上搜索引擎和复杂 Schema。
另外,模型并不能一次读完带内嵌图片的 Markdown。gist 给出的办法是先读文字,再单独查看需要的图片,步骤会啰嗦一些。
参考链接
- Karpathy 的 LLM Wiki gist:https://gist.github.com/karpathy/442a6bf555914893e9891c11519de94f
- qmd(gist 中提到的可选本地搜索工具):https://github.com/tobi/qmd
如果你已经在用 Claude Code 或 Codex,可以把这份 gist 放进项目规则里,先用几份资料跑通摄入和查询。需要给这些工具接入多模型时,也可以直接在 AIGoCode 上使用。