找工作时最耗精力的往往不是面试,而是前面的重复劳动:每天刷好几个招聘网站,判断哪些职位值得投,再针对每个职位改一版简历、写一封求职信。投得越多,越容易变成复制粘贴,质量也跟着下降。
ai-job-search(GitHub 仓库 ai-job-search-dev/ai-job-search,MIT 协议)把这套流程整理成了 Claude Code 里的一组命令。作者是一位地球物理学背景的工程师,2025 年底岗位被裁后,他用这套工作流做自己的求职:投出 69 份定制申请,拿到 20 次初面,最后签下一份 AI 工程师的工作。项目与 Anthropic 没有关联。
这篇按实际使用顺序,讲清楚它需要什么环境、怎么安装、各个命令做什么,以及 /apply 是怎么生成简历和求职信的。
它能做什么
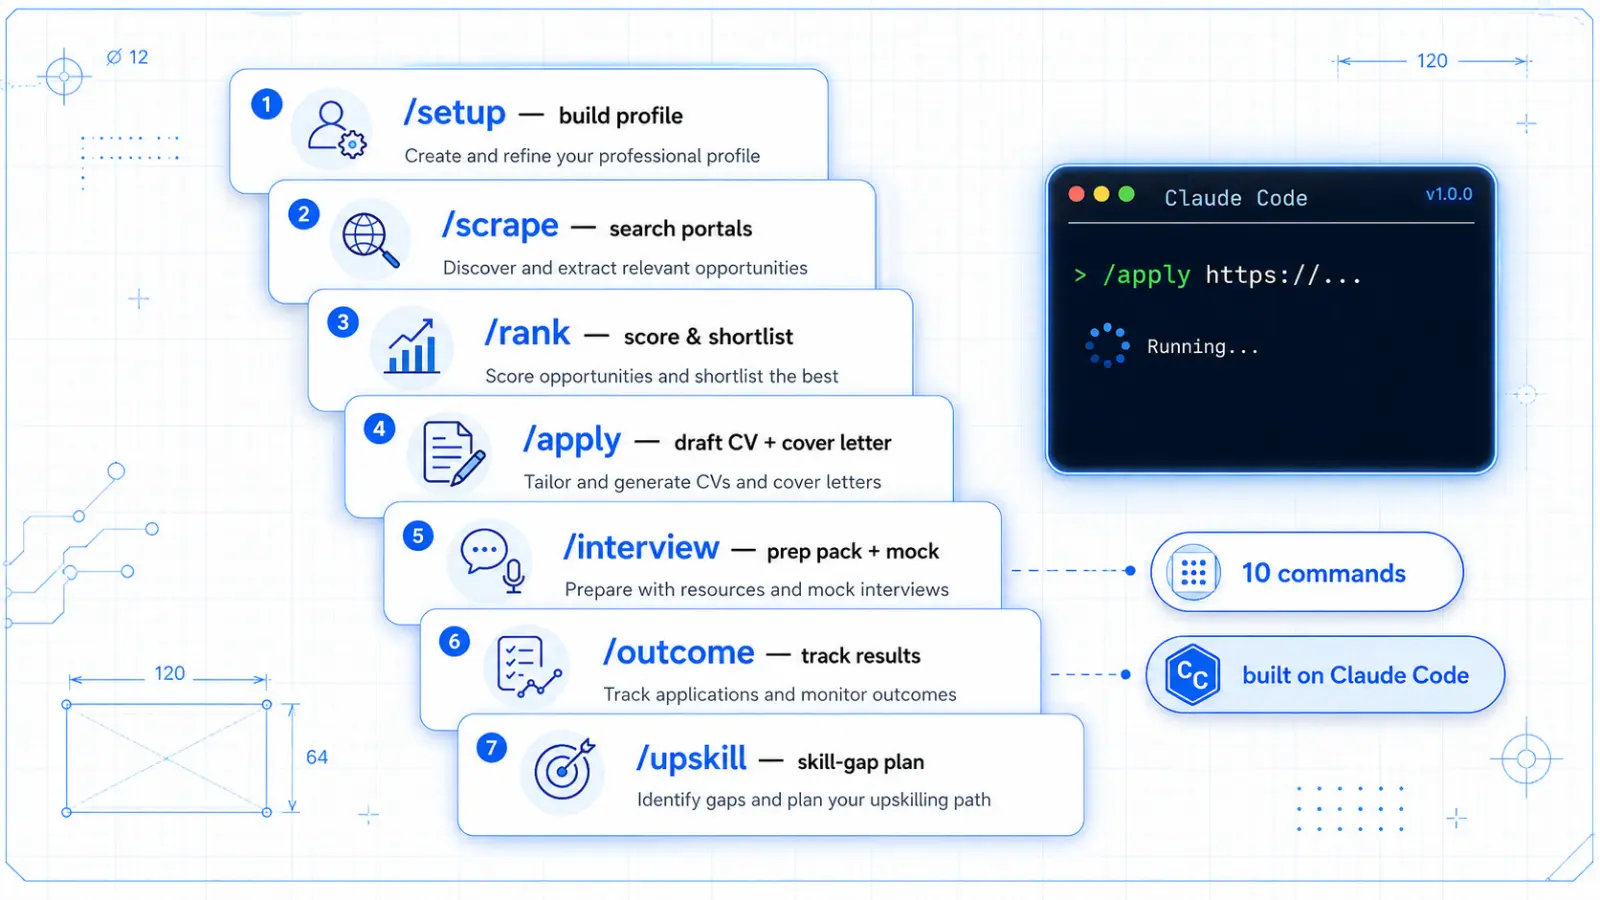
核心流程由 6 个命令串起来,从空白档案一直走到记录结果:
/setup:建立你的个人档案;/scrape:在招聘网站上搜索匹配的职位;/rank:给搜到的职位批量打分,排出候选清单;/apply:评估匹配度,起草、评审并编译定制的简历和求职信;/interview:针对具体面试轮次准备资料,并可以做模拟面试;/outcome:记录每份申请的结果,并在需要时起草跟进邮件。
其中建档、匹配评估和"起草加评审"的申请流程与语言、国家无关。仓库自带的招聘网站搜索工具是针对丹麦市场做的,但可以按同样的模式换成你所在地区的招聘网站。
准备环境
开始之前需要准备这几样:
- Claude Code:没有免费额度,需要 Claude Pro、Max、Team 订阅,或者 Anthropic API 额度;
- Python 3.10 及以上:运行
tools/目录里的脚本; - Bun:运行各个招聘网站的搜索命令行工具;
- LaTeX 发行版:需要包含
lualatex和xelatex,可以选 TeX Live、MacTeX、TinyTeX 或 MiKTeX。简历用 lualatex 编译,求职信用 xelatex 编译; - pypdf(可选):用于
/apply里的 ATS 可读性检查。没装的话会退而使用 Poppler 的pdftotext,两个都没有时只做人工式的关键词检查。
用的是 Codex、Gemini CLI 等其他 Agent 工具的话,官方建议从仓库里的 AGENTS.md 开始看,招聘网站搜索工具可以直接用,完整工作流有社区做的适配版本。
第一步:获取代码,注意隐私
官方给出的方式是 fork 后克隆:
gh repo fork ai-job-search-dev/ai-job-search --clone
cd ai-job-search
这里有一个很重要的提醒:公开仓库的 fork 永远是公开的,GitHub 不允许把它设成私有。而 /setup 会把你的姓名、联系方式、工作经历、期望薪资写进会被 Git 跟踪的文件里。
所以如果只是自己求职、不打算给项目贡献代码,官方建议改用一个私有仓库,再把原仓库添加为 upstream 远程,用来接收后续更新。具体做法在仓库 SETUP.md 的第 8 节。只在本地提交、不推送也可以。追踪表、薪资数据、documents/ 目录和申请存档这些最敏感的文件已经被加入了忽略列表,不会进入 Git。
第二步:安装搜索工具
在仓库根目录执行:
python3 tools/install_portal_clis.py
这个脚本会给 .agents/skills/ 下的每个招聘网站命令行工具执行依赖安装。安装时会禁用安装脚本,遇到声明了安装期生命周期脚本等可疑配置的工具会跳过并报告,加 --dry-run 参数可以先看它要装什么。
第三步:用 /setup 建立档案
在仓库目录启动 Claude Code,然后输入 /setup。它提供三种建档方式,会自动判断你手上有什么材料再询问:
- 读取
documents/文件夹,里面可以放简历 PDF、LinkedIn 导出文件、学位证书、推荐信、过去的申请材料; - 直接在对话里粘贴一份简历;
- 通过一问一答的访谈来建立档案。
使用文件夹方式时可以反复运行,补充了新材料再跑一次即可。
第四步:搜索并筛选职位
输入 /scrape,它会在多个招聘网站上搜索和你档案匹配的职位,去重后按匹配度排序。看中哪个可以直接对它运行 /apply。搜到的职位太多时,先运行 /rank:它会用匹配框架给所有新职位批量打分,给出每个职位的优势和差距,硬性排除条件直接否决,临近截止的会标出来,失效的职位标为过期。
仓库自带的搜索工具包括:
- 4 个丹麦招聘网站:Jobbank、Jobdanmark、Jobindex、Jobnet;
- linkedin-search:基于 LinkedIn 公开的免登录接口,用参数指定地点,比如
-l "Remote",适用于任何地区。不过自动访问违反 LinkedIn 的服务条款,官方明确说只适合个人使用,而且要控制访问量; - freehire-search:调用 freehire.me 聚合站的公开 REST 接口,偏向软件、数据、工程、DevOps 和远程岗位,返回的是结构化数据。
不在丹麦的话,可以用 /add-portal 给本地的招聘网站生成一个搜索工具。它会先研究这个网站的搜索地址格式、结果页结构和访问规则,按现有工具的结构搭好,再实际跑一次查询,确认可用后才注册。需要登录才能访问的网站会被拒绝。
第五步:用 /apply 生成简历和求职信
/apply 后面可以跟职位链接,也可以在链接打不开时直接粘贴职位描述全文。它会跑完下面这套流程:
- 解析职位描述;
- 从技能、经验、文化、地点、职业方向几个维度评估匹配度;
- 用 LaTeX 起草定制的简历和求职信;
- 启动一个评审 Agent,调研公司并挑出草稿的问题;
- 根据评审意见修改;
- 编译两份 PDF,并查看渲染结果反复调整,直到简历正好 2 页、没有孤立的条目标题,求职信正好 1 页、签名可见、字体一致;
- 对简历做 ATS 检查:提取 PDF 的文字层,按招聘系统解析的方式确认联系方式是可识别的文字、没有乱码、阅读顺序正常,再统计职位关键词的覆盖情况;
- 附上核对清单输出最终结果。
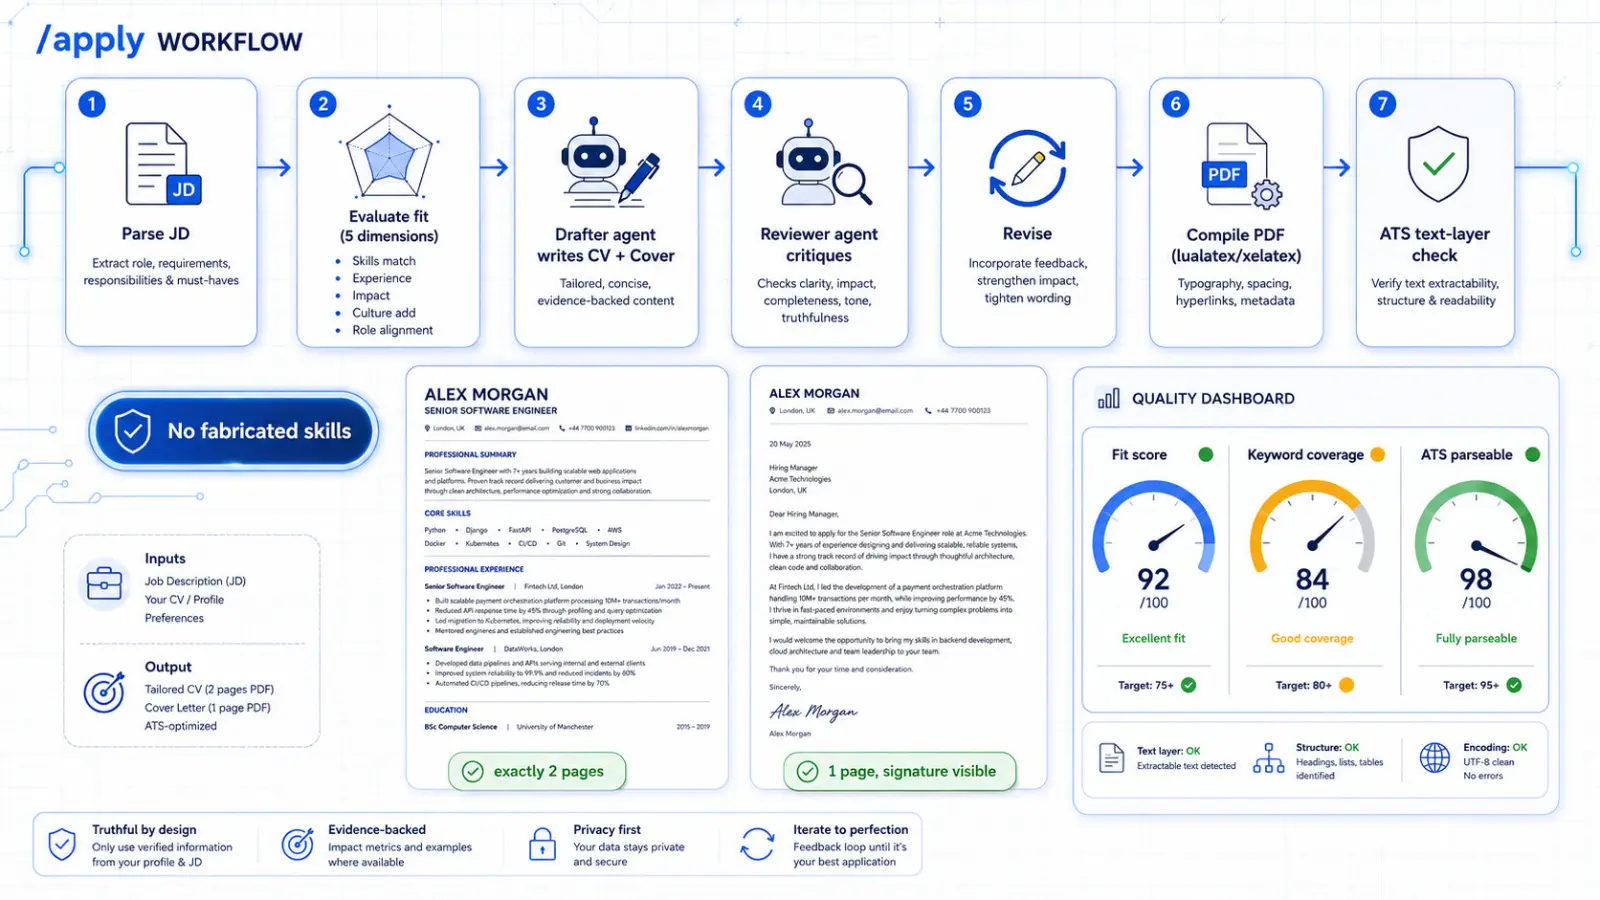
这套流程有几条硬性原则。简历和求职信里的所有内容都会对照你的真实档案核验,不会编造技能或经历。档案确实支持的关键词才会补进去,真正的差距会如实保留,绝不硬塞关键词。简历超过 2 页时,也不是机械地从最早的经历开始删,而是按"和目标职位的相关度、在文中是否重复、求职信是否依赖它"综合打分,先删得分最低的那一行。
另外,职位描述被当作不可信的输入。工作流不会执行里面嵌入的指令,也不会访问正文里的链接,并且会先检查隐藏文字、不可见字符这类可疑内容。不过官方也提醒,这些防护是指令层面的,并不是沙箱,在不熟悉的招聘网站上,发出申请前最好自己看一遍抓取和生成的内容。
其他命令
核心流程之外,还有这些命令可以按需使用:
/interview:根据申请存档(当时的职位描述、提交的简历和求职信、之前轮次的反馈)准备面试资料,把可能的问题对应到你的 STAR 案例,并可以进行模拟面试;/outcome:记录面试进展、录用或拒绝,存档提交过的材料;/outcome followup会找出 10 天没有回音的申请,起草跟进邮件,但只起草不发送;/gmail-sync:从 Gmail 读取面试邀请、录用、拒绝等信号,批量提出状态更新建议,经你确认后才写入;/notion-sync:通过官方 Notion MCP 把求职进度单向同步到 Notion 数据库,方便在手机上查看;/html-report:生成一个可以离线打开的 HTML 求职看板;/expand:扫描档案里已经关联的公开资料(比如 GitHub、个人网站),补充档案里没写出来的技能;/upskill:分析你和目标职位之间的技能差距,给出学习计划;/add-template:注册自己的简历或求职信模板;/reset:清空档案或文档,执行前会列出要删除的内容,需要输入确认词才会执行。
适合谁用
- 投递量大、想把每份申请都做定制,但不想每次从零改简历的人;
- 已经在用 Claude Code,想看看一个完整的多 Agent 工作流是怎么组织的开发者;
- 想把这套模式改造成自己所在地区招聘网站版本的人。
这个仓库本身也是学习 Claude Code 项目结构的好例子:命令、Skill、CLAUDE.md 都在里面。想先弄清这些配置分别放在哪里,可以看 Claude Code 的 .claude 文件夹怎么配?
在 AIGoCode 上接入 Claude Code 后,就可以按上面的步骤把 ai-job-search 跑起来。
参考链接
- ai-job-search GitHub:https://github.com/ai-job-search-dev/ai-job-search
- SETUP.md:https://github.com/ai-job-search-dev/ai-job-search/blob/master/SETUP.md