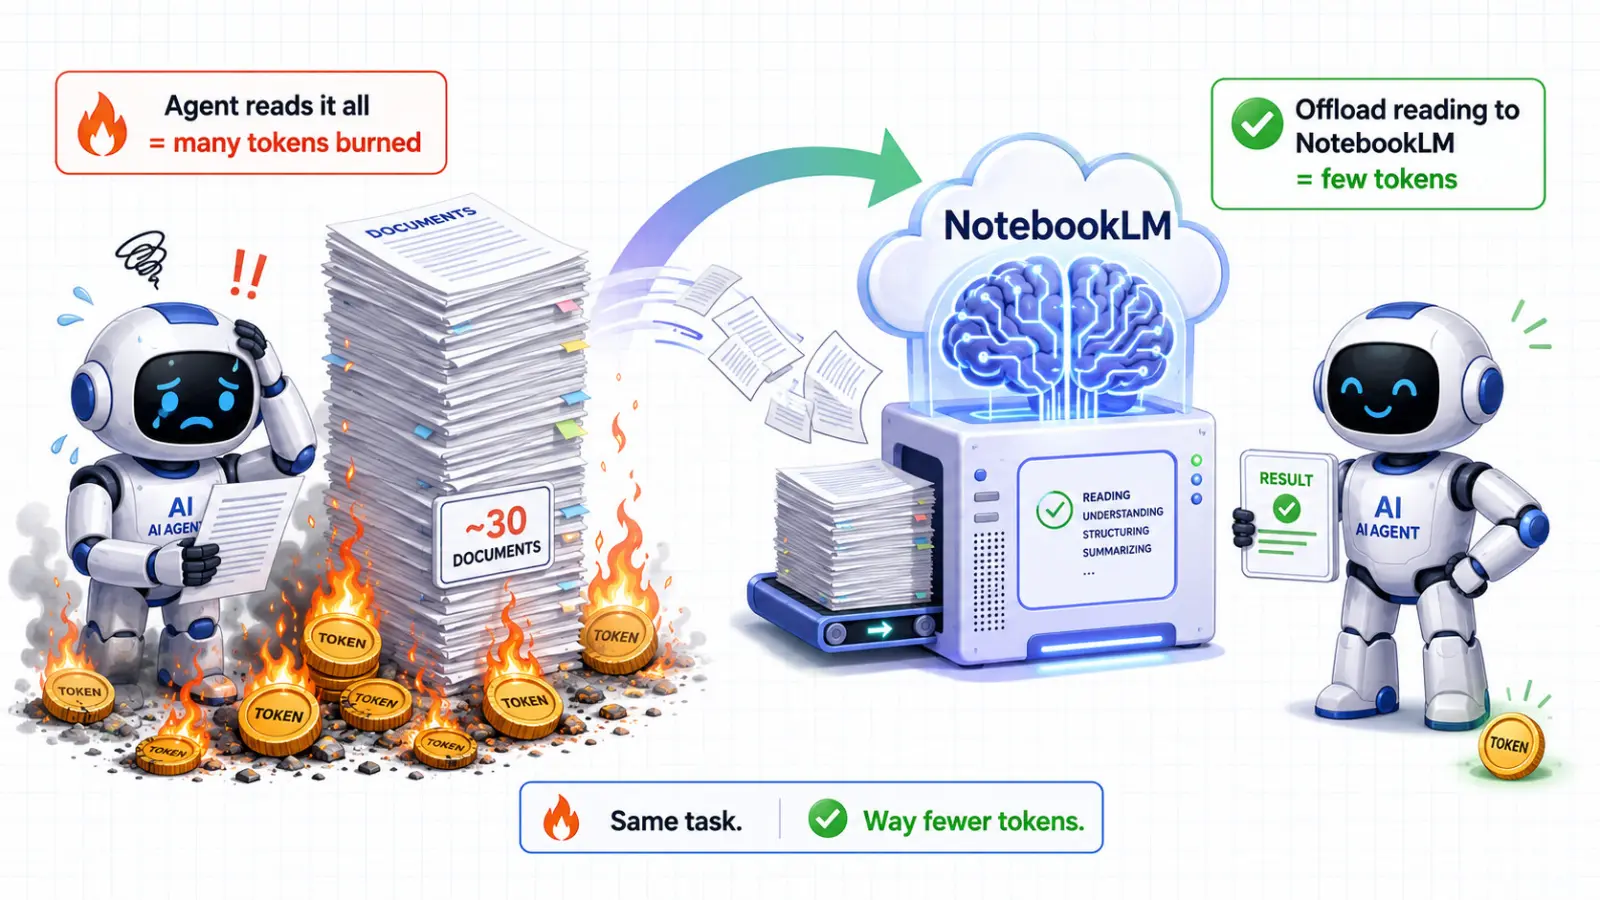
让 AI 帮忙读一大堆资料,是件很费 token 的事。把三十份 PDF、几十个网页交给 Claude Code 或 Codex,让它读完再回答,读得越多消耗越大,长文档还容易超出一次能装下的上下文。而你要的往往只是最后那个结论,前面“啃资料”的活,其实不一定要由按 token 计费的 Agent 来干。
notebooklm-py 就是针对这个思路做的。它是一个非官方的 Python API,同时带命令行工具和给 AI Agent 用的 Skill:让 Google 的这款笔记产品在服务端读完资料,你的 Agent 只负责建笔记本、加资料、提问,然后拿结果去做最后一步。
先交代一下名字。Google 在 2026 年 7 月 16 日发布公告,把 NotebookLM 更名为 Gemini Notebook,官方的说法是同一个独立产品,现在也能在 Gemini 应用里使用。notebooklm-py 的 README 也加了说明:它驱动的是同一个后端服务,更名后照常工作,包名仍然是 notebooklm-py。下文提到“笔记本产品”时统一写作 Gemini Notebook,配图里仍是旧名 NotebookLM。
截至 2026 年 11 月,notebooklm-py 的 GitHub 仓库 star 数超过 2 万,协议是 MIT,要求 Python 3.10 或更高版本。
它的思路:让 Agent 只管编排
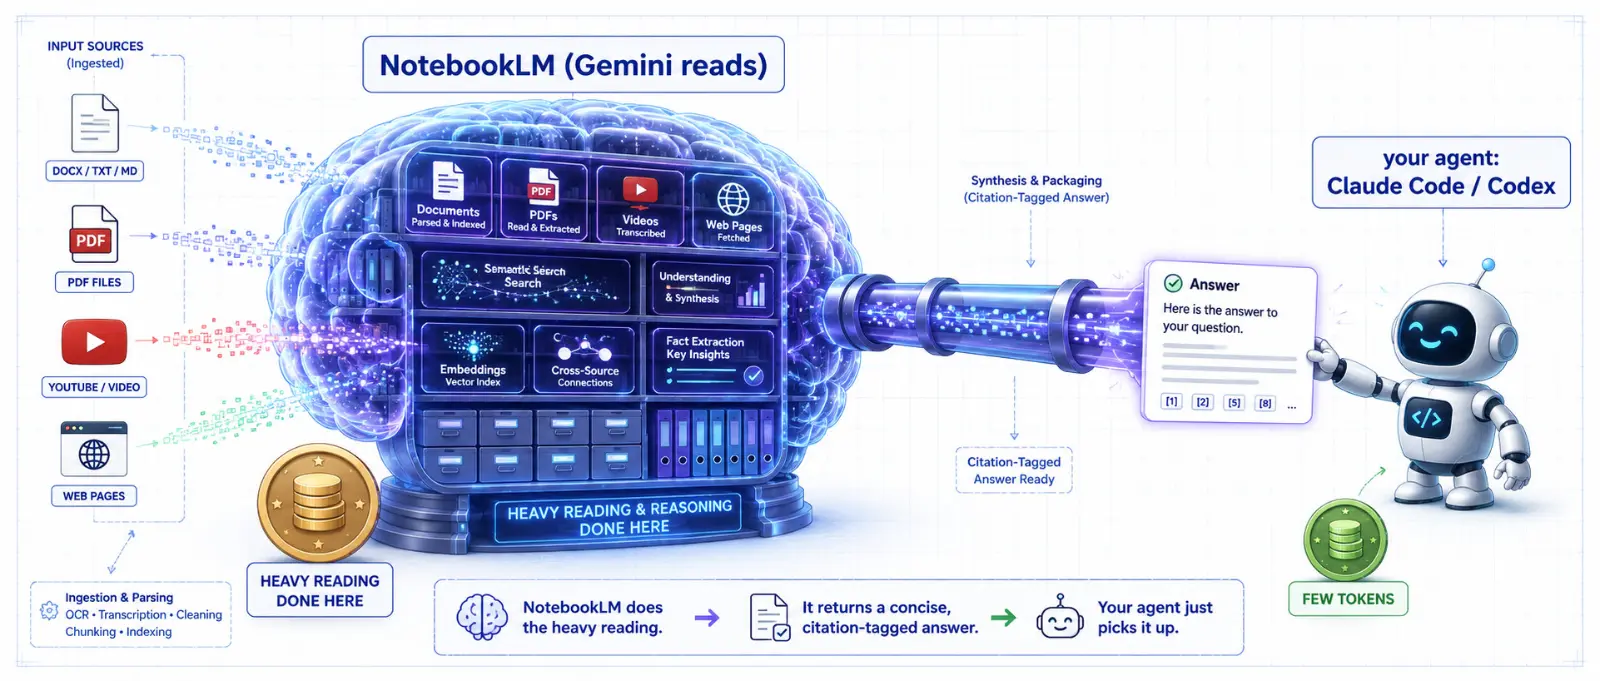
Gemini Notebook(原 NotebookLM)是 Google 的资料研究工具:你上传资料,它基于你的资料回答,并且每个回答都带引用来源,不容易凭空编造。背后读和总结的是 Gemini。
notebooklm-py 的做法是把它变成 Agent 可以反复调用的一层:重的分析交给服务端做,你的 Agent 只负责编排,也就是建笔记本、加资料、提问,再把结果拿出来做收尾。README 把这种用法叫作“省 token 的研究卸载”。
这里要说准确:省下的是你的 Agent 这一侧的 token,阅读和总结的工作并不是没有成本,它占用的是你的 Google 账号额度。README 里提醒了限流,也有 notebooklm usage 命令查看当前用量和重置时间,另外还有一份文档按账号等级列出笔记本、资料数量等上限。
它能做什么
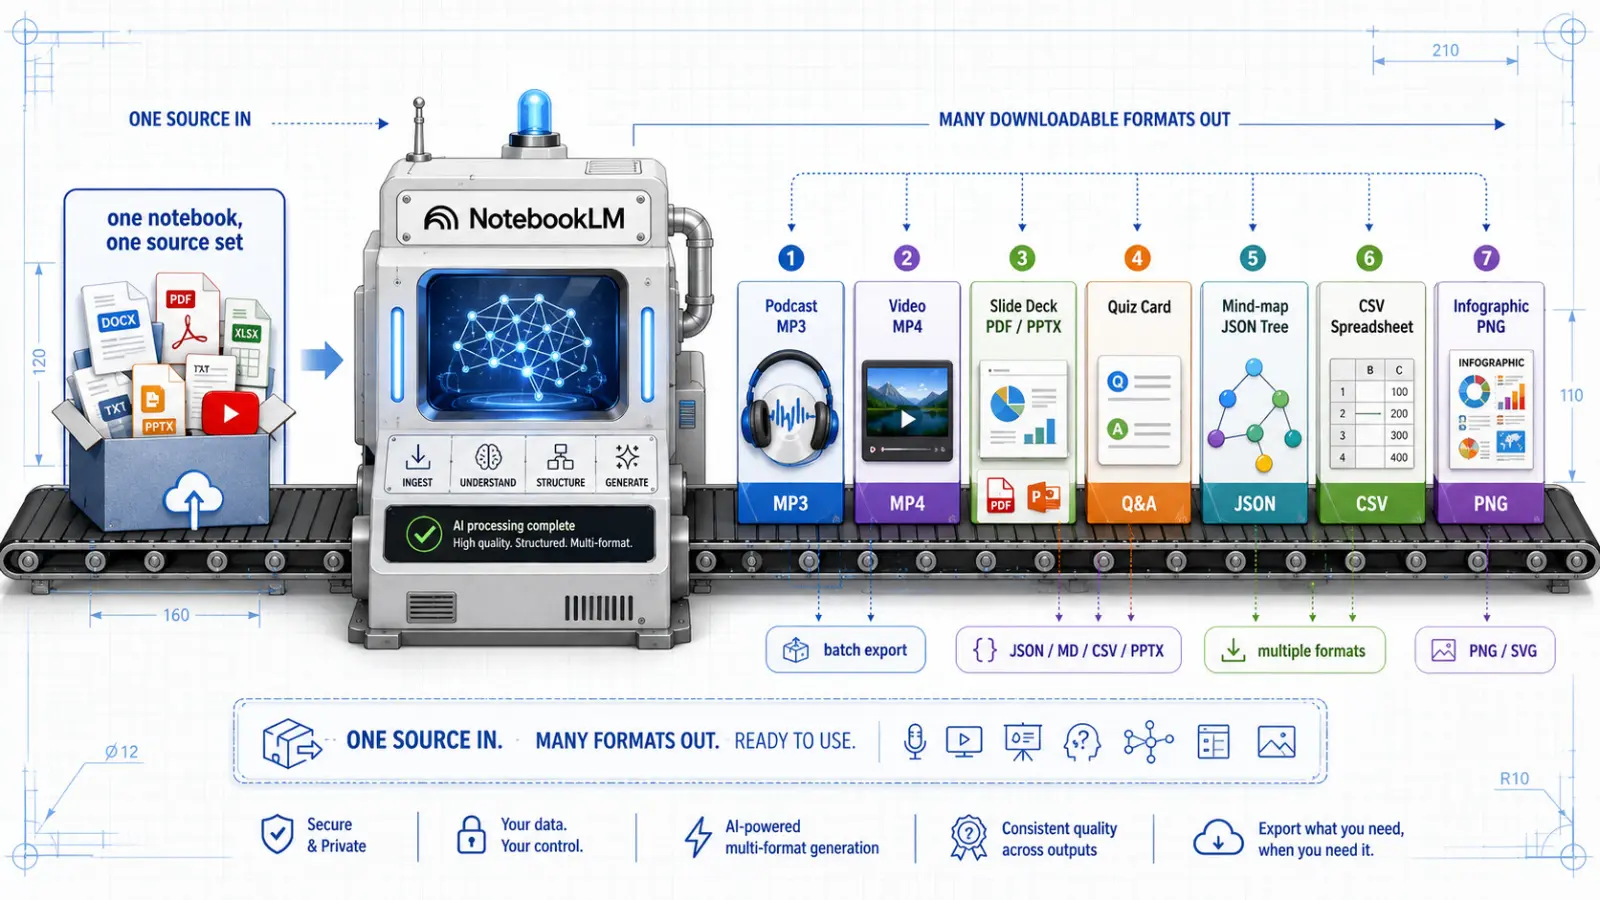
它把这款产品的大部分能力做成了可以用代码或命令调用的形式:
- 来源:网址、YouTube、文件(PDF、文本、Markdown、Word、EPUB、音频、视频、图片)、Google Drive、粘贴的文本,都可以加进笔记本。
- 问答:基于资料的带引用问答,可以保存对话到笔记,还能自定义角色。
- 研究:联网和 Drive 的研究代理,有快速和深度两种模式,可以自动导入找到的资料。
- 内容生成:同一套资料可以生成播客音频(深入探讨、简报、点评、辩论四种形式,支持 50 多种语言)、视频概览、幻灯片、信息图、测验、记忆卡片、报告(简报、学习指南、博客草稿)、数据表格和思维导图。
更值得注意的是网页版没有的部分,也就是批量和脚本化地把结果导出来:
- 一次性下载某一类产物的全部内容(
download <类型> --all); - 测验和记忆卡片导出为 JSON、Markdown 或 HTML;
- 数据表导出为 CSV,思维导图导出为 JSON;
- 幻灯片下载为 PPTX 或 PDF。
给编程 Agent 当“项目大脑”和跨会话记忆
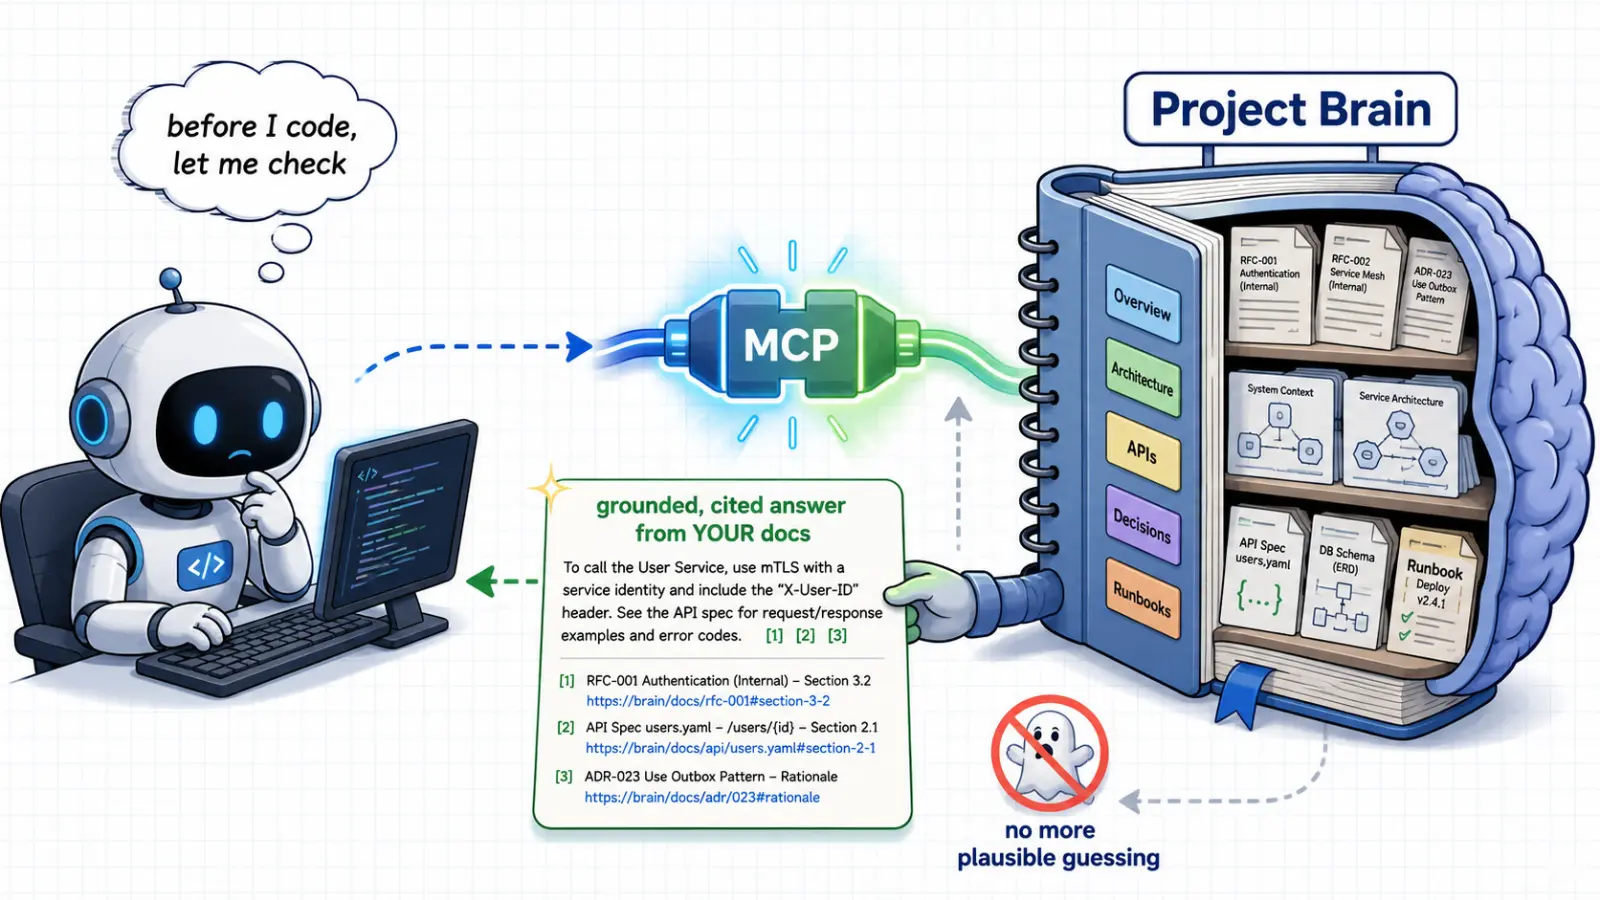
除了省 token,另一个实用的用法是给编程 Agent 当带引用的知识底座。
把内部文档、架构说明、历史 RFC 放进同一个笔记本,再通过它的 MCP 服务让 Agent 查询。Agent 写代码之前先问一句,拿到的是从你自己的资料里带出处的答案,而不是听起来像那么回事的猜测。README 的说法是,这可以替代自己搭向量库和 embedding 流程。MCP 的启动方式和各客户端的配置见仓库的 docs/mcp-guide.md。
它还可以做跨会话记忆:留一个常驻的笔记本,每次收尾把这次的决定和踩过的坑记进去,在 CLAUDE.md 里写一句让 Agent 开工前先查询,记忆就存在 Google 那一侧。如果你更想把记忆放在本地,可以看 claude-mem 安装与使用教程:给 Claude Code 加上跨会话记忆,两种思路的取舍不同。
安装与使用
README 推荐用 uv 或 pipx 把命令行装进独立环境,这样不会和系统 Python 冲突,也能避开较新的 macOS 和 Debian、Ubuntu 上 pip install 报 externally-managed-environment 的问题:
uv tool install "notebooklm-py[browser]"
notebooklm login
notebooklm auth check --test --json
第二行首次运行会自动下载 Chromium,README 写的大小约为 170 MB,然后让你登录 Google 账号。第三行用来验证,看到 "status": "ok" 就说明登录有效。没有 uv 的话,也可以用 pipx install "notebooklm-py[browser]";喜欢用 pip,就在虚拟环境里安装。如果只是作为库嵌进自己的应用,不需要浏览器登录这一套,用 uv add notebooklm-py 即可。
日常用命令行大致是这个节奏:建笔记本、加资料、提问、生成、下载:
notebooklm create "My Research"
notebooklm use <notebook_id>
notebooklm source add "https://en.wikipedia.org/wiki/Artificial_intelligence"
notebooklm source add "./paper.pdf"
notebooklm ask "这些资料的核心观点是什么?"
notebooklm generate audio "make it engaging" --wait
notebooklm download audio ./podcast.m4a
想接进 Claude Code、Codex 这类 Agent,有两种方式装 Skill:
notebooklm skill install
npx skills add teng-lin/notebooklm-py
第一条会把 Skill 装到 ~/.claude/skills/notebooklm 和 ~/.agents/skills/notebooklm;第二条通过开放的 skills 生态,直接从 GitHub 取仓库里的 SKILL.md。装完可以用 notebooklm skill status 检查状态。
认证方式
除了交互式登录,README 列出的方式还有:
- 从已经登录的浏览器导入 cookie:
notebooklm login --browser-cookies chrome; - 使用 master token,需要时自动换新 cookie,适合服务器、CI 和远程 MCP 连接器;
- 多账号配置,可以在不同 Google 账号之间切换。
master token 相当于整个账号的长期凭证。README 的建议是用专门的账号,并妥善保护配置目录,不要拿主力账号去做无人值守。
用之前要知道的事
这是个非官方的库,README 开头就有醒目的提示:
- 使用的是没有公开文档的 Google 接口,Google 随时可能改动,库可能突然失灵;
- 与 Google 没有关联,是社区项目;
- 有限流,用量大了可能被限速。
所以它更适合原型、研究和个人项目,不建议拿去扛关键的生产业务。心里有这个预期,它是个很好用的工具;如果指望它像官方 SDK 那样稳定,就会失望。
另外,资料会上传到 Google 的服务里处理。涉及公司内部文档、客户数据时,先确认你们的安全要求允许这样做。
小结
这个库想通的一点是分工:Gemini Notebook 擅长基于给定资料做带引用的深度阅读和总结,按 token 计费的 Agent 擅长编排和最后一步。把“啃资料”这件事挪到服务端,Agent 只在末端花 token,成本结构会顺很多。再加上批量、可脚本化的导出,补上了网页版缺的程序化能力。
如果你在 AIGoCode 上接入了 Claude Code 或 Codex,可以先用 notebooklm skill install 装好 Skill,拿一小批资料试一轮,看看 Agent 这一侧的 token 消耗有没有明显下降。
参考链接
- notebooklm-py GitHub:https://github.com/teng-lin/notebooklm-py
- notebooklm-py 在 PyPI:https://pypi.org/project/notebooklm-py/
- MCP 使用指南:https://github.com/teng-lin/notebooklm-py/blob/main/docs/mcp-guide.md
- Google 官方公告(NotebookLM 更名为 Gemini Notebook):https://blog.google/innovation-and-ai/products/gemini-notebook/notebooklm-gemini-notebook/