用 AI 写代码,最磨人的往往不是它写得慢,而是每开一个新会话,它对你的项目又一无所知:技术栈要重讲,命名规矩要重讲,上周踩过的坑还得再讲一遍。
常见的做法是往 CLAUDE.md 或 AGENTS.md 里不停追加内容,写到三四百行,模型确实会读,但很难抓住和当前任务相关的那几条。
Trellis 是一套给 AI 编程用的工程框架,用 TypeScript 写成,AGPL-3.0 协议,GitHub 上目前超过 1.5 万 star。它把规范、任务和项目记忆落成文件存进仓库,不管哪个 coding agent 接手,都按同一套项目标准干活。这篇文章讲清楚 Trellis 往仓库里放了什么、一个任务怎么跑完、怎么安装,以及它适合什么规模的项目。
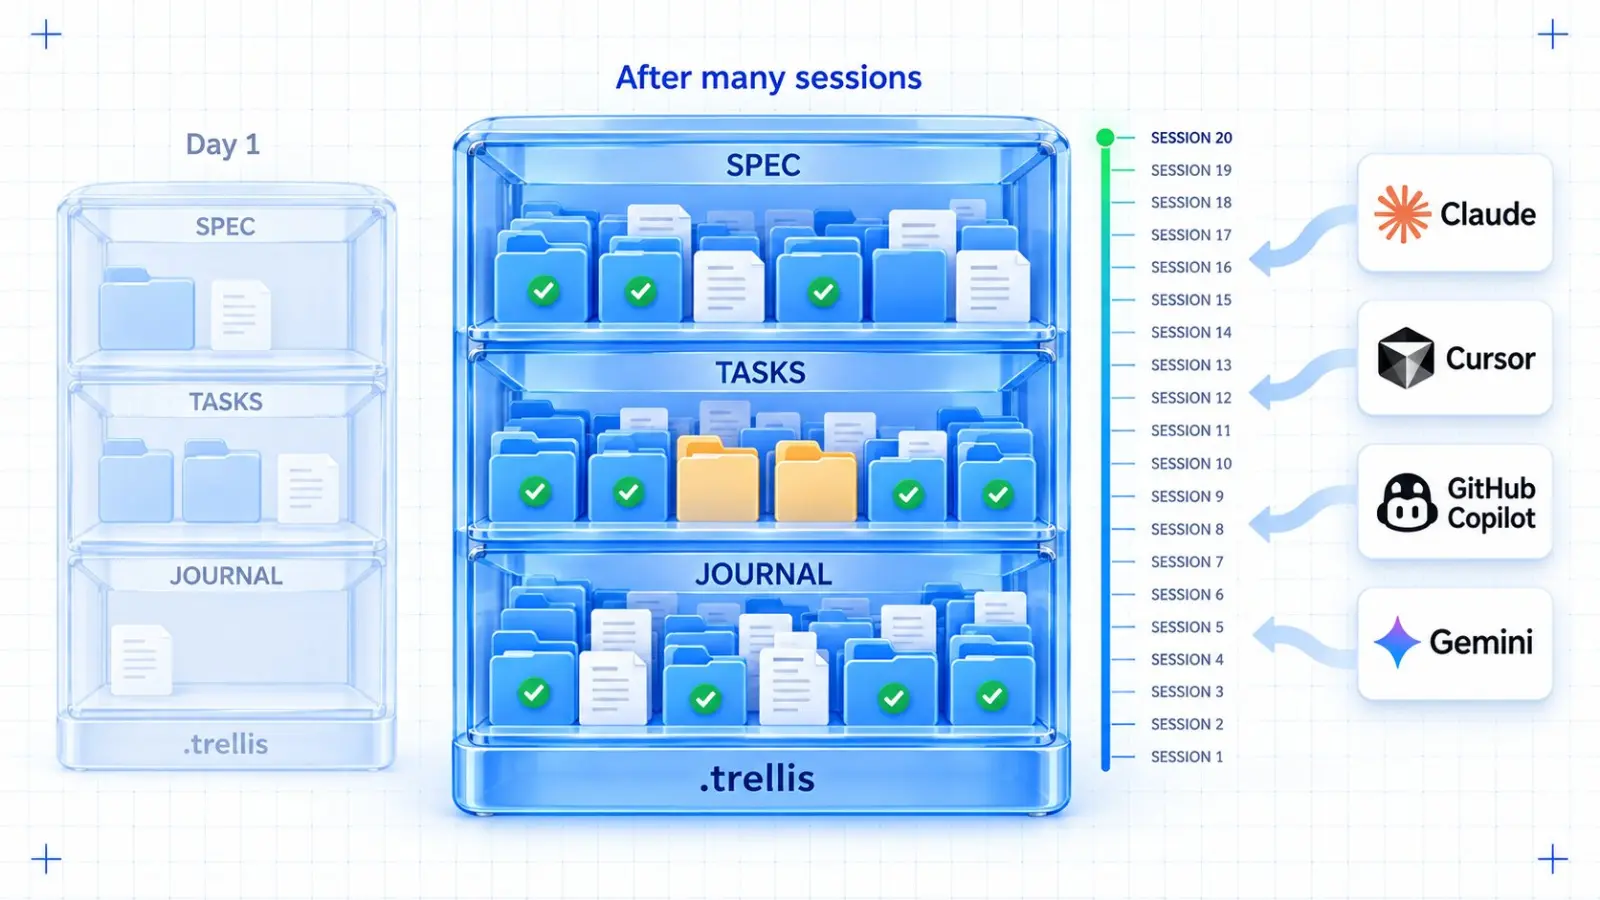
Trellis 是什么:.trellis 目录里的三块内容
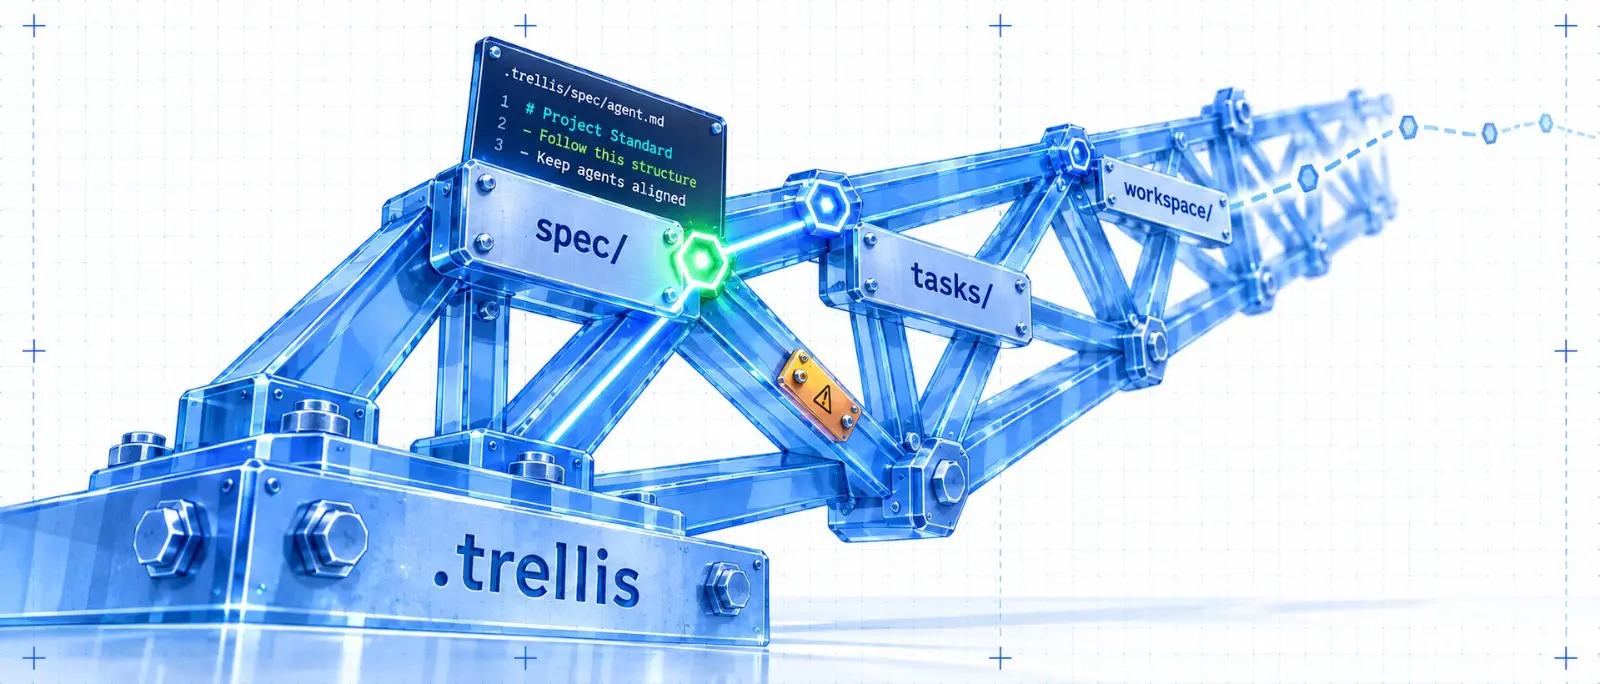
执行 trellis init 之后,项目里会多出一个 .trellis 目录,核心是三部分。
spec/:规范库。 前端、后端、思考方式各一套,拆成小文件保存。干活时只把和当前任务相关的几条注入上下文,而不是把整本规范塞进去。
tasks/:任务区。 一个任务一个目录,PRD、技术设计、实现计划和状态都放在里面,完成后归档到 archive,按月分。中途换会话,任务也不会丢。
workspace/:记忆层。 每个开发者一份日志,记录上次做到哪、当时为什么那样改,新会话开始时先读它。
规范和任务进 git,团队共用;个人日志按人分开存,不会互相冲突。某个人摸索出来的一条规矩写进 spec 之后,全队的 AI 都会照着执行。
| 目录 | 存什么 | 谁共享 |
|---|---|---|
| spec/ | 分领域的项目规范,按需注入 | 团队,进 git |
| tasks/ | 每个任务的 PRD、设计、计划、状态 | 团队,进 git |
| workspace/ | 每个开发者的工作日志 | 按人分开 |
一个任务在 Trellis 里怎么跑完
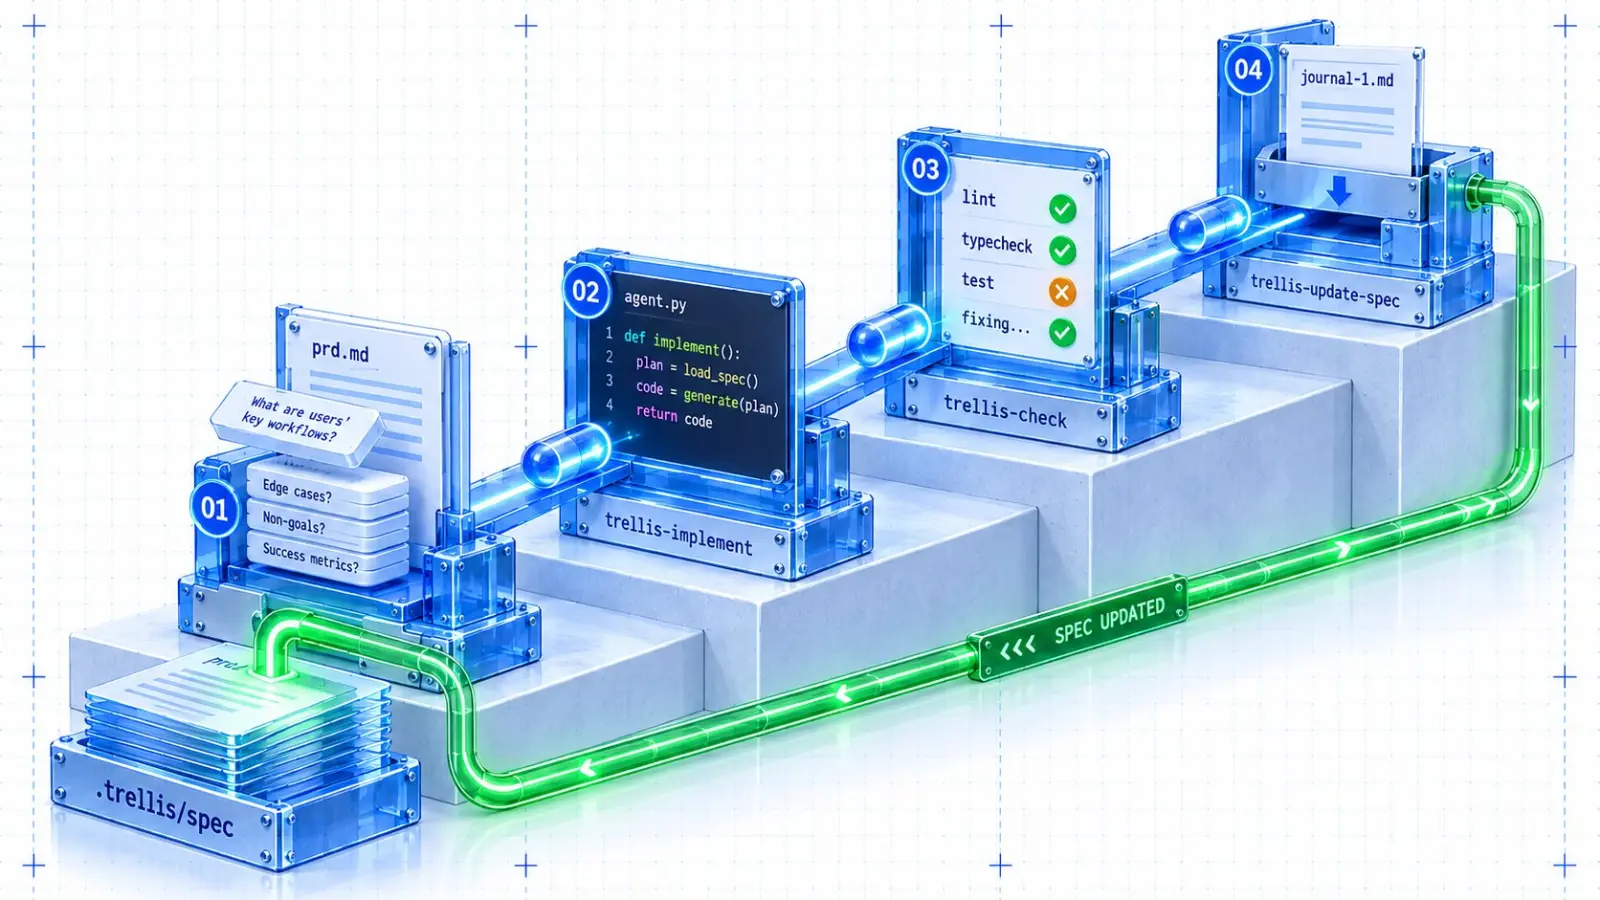
Trellis 把一个任务分成四个阶段,自动串联,中间不需要手动切换。
- Plan:用大白话说出需求,trellis-brainstorm 会一个问题接一个问题地追问,直到 PRD 写清楚。需要查资料的部分交给 trellis-research 子代理,结论存进 research 目录。
- Implement:trellis-implement 子代理按 PRD 写代码,相关 spec 自动注入,这一步不做 git 提交。
- Verify:trellis-check 拿改动的 diff 和规范逐条比对,再跑 lint、类型检查和测试,能修的当场修掉。
- Finish:先做最终检查,然后 trellis-update-spec 把这次新学到的东西写回
.trellis/spec/。
第四步是这套框架最有价值的地方。调试时踩的坑、临时定下的约定,不会只留在聊天记录里等着被清掉,而是变成规范文件留在仓库。任务做得越多,spec 越完整,下一个任务开局时拿到的上下文也越准。
任务完成后输入:
/trellis:finish-work
它会归档任务、追加日志、清掉当前活动任务的指针。上下文快满的时候也可以提前执行,进度不会丢。如果 AI 卡住或者跳了步骤,用 /trellis:continue 把它拉回流程。
Trellis 安装与初始化
官方 README 列出的环境要求是 Node.js 18 及以上、Python 3.9 及以上,macOS、Linux、Windows 都能用。
npm install -g @mindfoldhq/trellis@latest
cd your-project
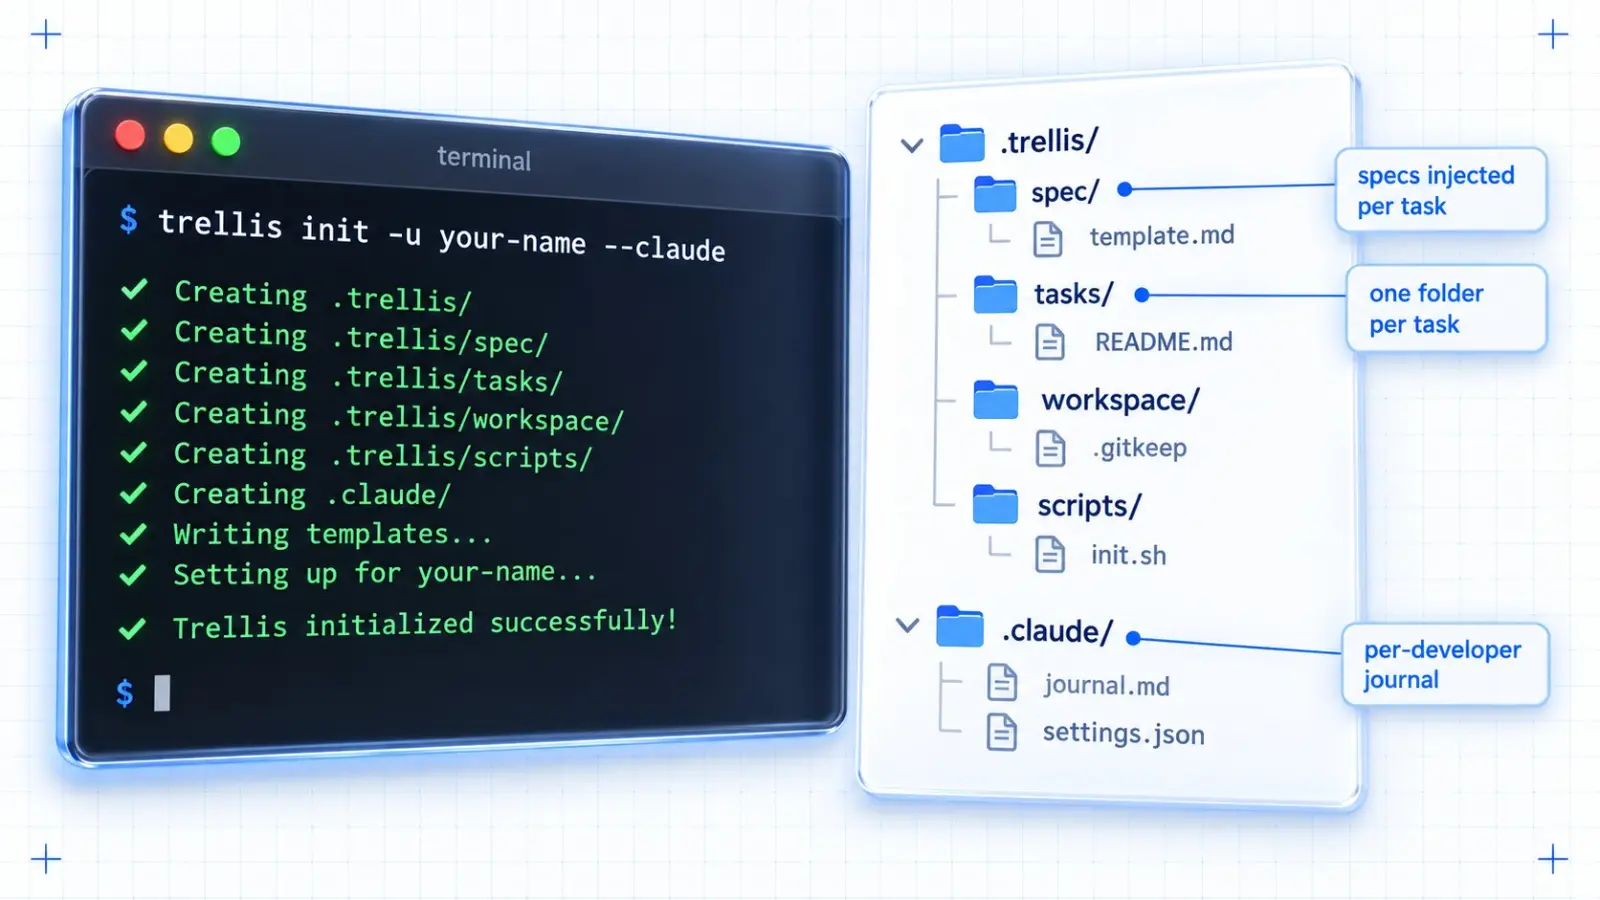
trellis init -u your-name --claude
-u 后面填自己的名字,Trellis 用它创建个人工作区。如果团队同时用多个工具,可以一次带上多个平台参数:
trellis init -u your-name --claude --cursor --opencode
新成员加入已有项目时,同样执行一次 trellis init -u 名字。Trellis 会读取 .trellis/.developer 这个不入库的身份文件,发现是新成员就生成一个加入任务,带他过一遍项目规范。
升级分两步,全局 CLI 和项目里的模板分别更新:
trellis upgrade
trellis update
一套 .trellis,接 22 个 AI 编程工具
Trellis 支持的平台一共 22 个,包括 Claude Code、Cursor、Codex、Gemini CLI、Copilot、OpenCode、Kiro 等。初始化时带上对应参数,它会按各家的格式,把命令、子代理、skill 和 hook 生成到 .claude、.cursor、.codex 等目录,底层读的都是同一个 .trellis。
它还会往 .agents/skills 写一份跨平台共享的 skill,认这套标准的工具可以直接用。团队里有人用 Cursor、有人用 Claude Code,也不需要各自维护一套工作流。如果你还不熟悉 Claude Code 自己的配置目录,可以先看 Claude Code 的 .claude 文件夹怎么配,再决定哪些规范交给 Trellis 管。
团队规范也可以单独放在一个仓库里,新项目初始化时直接拉取:
trellis init -u your-name --registry gh:myorg/myrepo/my-team-spec
用 ablate 对比有没有 Trellis 的差别
这个功能不太常见。trellis ablate 会把项目里所有受管理的 Trellis 文件临时移走,移走前先在项目外保存一份带校验的恢复记录。之后开一个全新会话,就能直观感受没有 Trellis 时 AI 的表现。
trellis ablate --dry-run
trellis ablate
对比完执行下面的命令,原样恢复:
trellis restore
它和 trellis uninstall 不同,后者是永久删除。需要注意,恢复记录里保存着 .trellis 的原始内容,包括你写的 spec 和任务,在恢复验证通过之前它一直放在项目外面。如果里面有敏感信息,要清楚这一点。
限制与适用场景
和 spec 驱动的思路相比,Trellis 多了一层闭环:任务、记忆和规范回写是连在一起转的,而不只是开工前写一份文档。如果你想先了解"先写规范再写代码"这类做法,可以对照阅读 OpenSpec:先写规范再让 AI 写代码的规范驱动开发框架。和单个 CLAUDE.md 相比,Trellis 把规范拆成分层的小文件,按任务注入,并在任务结束后自动补充。
代价是你要接受它的目录约定和流程。小仓库、短平快的活儿用 Trellis 会偏重;项目够大、规范够多,或者团队里几个人的 AI 已经各写各的风格,花一个下午把它铺进去是划算的。另外,它采用 AGPL-3.0 协议,商用前请先确认是否符合公司的开源合规要求。
总结
Trellis 解决的是 AI 编程里的"项目失忆":规范拆成小文件按需注入,任务有独立目录和状态,每个开发者有自己的工作日志,每次任务结束再把新经验写回规范。如果你正在用 Claude Code 或 Codex 维护一个规范不少的中大型项目,可以先挑一个模块试跑几个任务,看 spec 能不能真的越写越有用。
想直接在国内顺畅使用 Claude Code、Codex 来跑这套流程,可以在 AIGoCode 上接入使用。
参考链接
- Trellis GitHub 仓库:https://github.com/mindfold-ai/Trellis
- Trellis 官方文档:https://docs.trytrellis.app