做过 Agent 的人大概都遇到过这种情况:让它按顺序处理一批文件,前几十个好好的,后面开始跳步骤,该校验的没校验,该写报告的直接略过,偶尔还把两个文件的结果混在一起。第一反应往往是改 prompt:加粗、大写、MANDATORY、DO NOT SKIP,结果换了一种错法。
Brian Suh 在 2026 年 5 月发表的文章《agents need control flow, not more prompts》把这件事讲得很透:可靠的 Agent 需要写在代码里的确定性控制流,而不是越来越长的 prompt 链。文章在 Hacker News 上引起了大量讨论,不少人分享了几乎一样的踩坑经历。
这篇适合正在用 LLM 搭自动化流程、或者用 Claude Code、Codex 跑批量任务的开发者,会讲 prompt 为什么管不住流程、确定性控制流长什么样、怎么开始改造,以及它不适用的情况。
一个真实的例子:200 个文件的 QA Agent
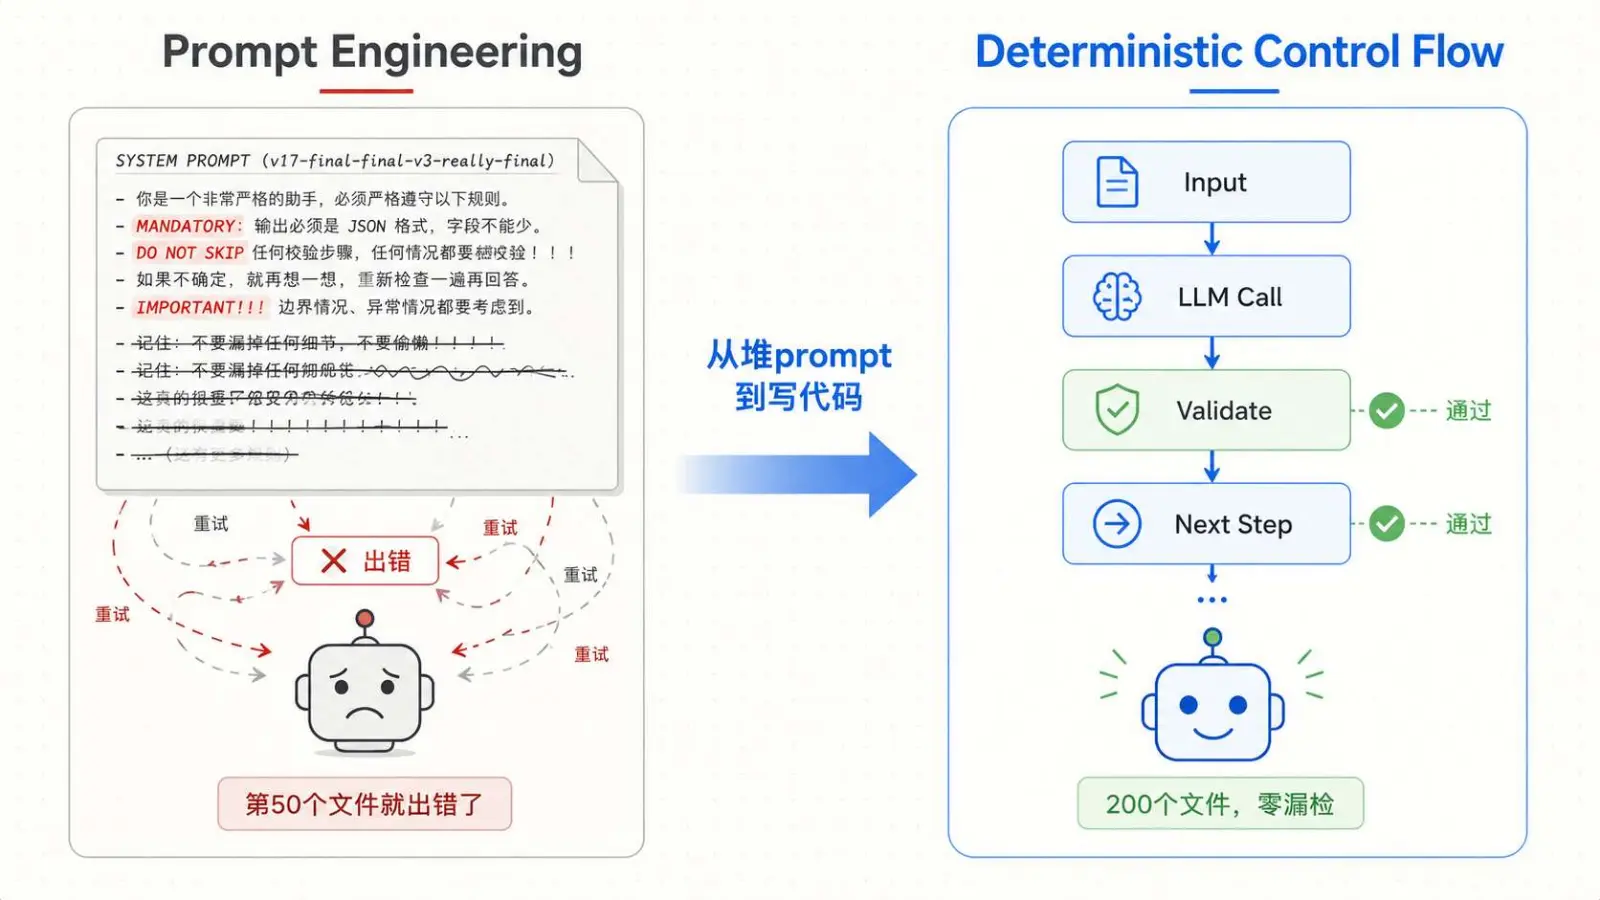
Hacker News 讨论区里有人分享了团队的 QA Agent:需要在浏览器里逐个核对约 200 个需求文件。他们一直想用一条 prompt 解决,让模型自己列待办、逐个检查,也就是把高层流程交给模型管。
结果是跑到 30 个文件左右就开始出问题:有时漏掉文件,有时把一组文件重复测三遍,一个文件出错还会影响模型对后面文件的判断。
改进的方向很直接:不再让模型决定「下一步做什么」,而是由代码循环每次只交给模型一个文件,拿到结果后用代码校验,通过了才进入下一个。
prompt 为什么管不住流程
prompt 本质上是一段自然语言指令,而自然语言是建议,不是命令。你写「必须按顺序执行这 5 个步骤」,模型会尽力遵守,但它没有程序计数器、没有调用栈、没有异常处理,它在尽力理解你的意思,而不是严格执行你的逻辑。
Brian 用了一个比喻:想象一门编程语言,语句只是建议,函数可能返回「成功」但其实在瞎编,你没法在这样的语言上做可靠的推理。
这不是模型够不够聪明的问题。单步任务上现在的模型都很强,问题出在多步编排:步骤越多,每一步的不确定性就越会累积,最后的结果越难预测。
确定性控制流长什么样
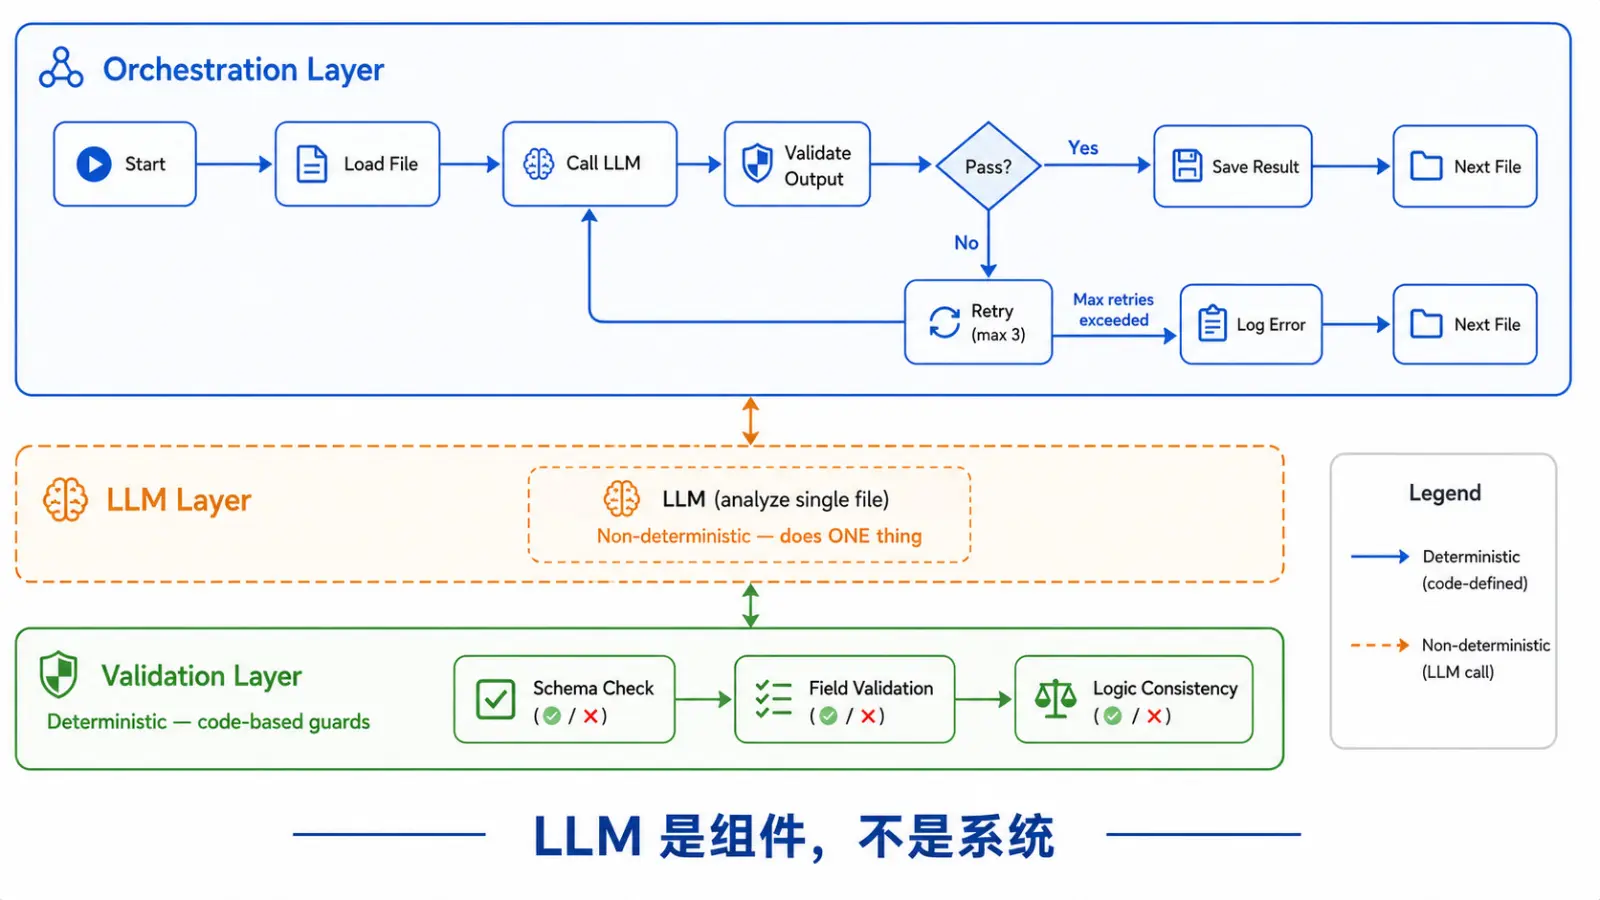
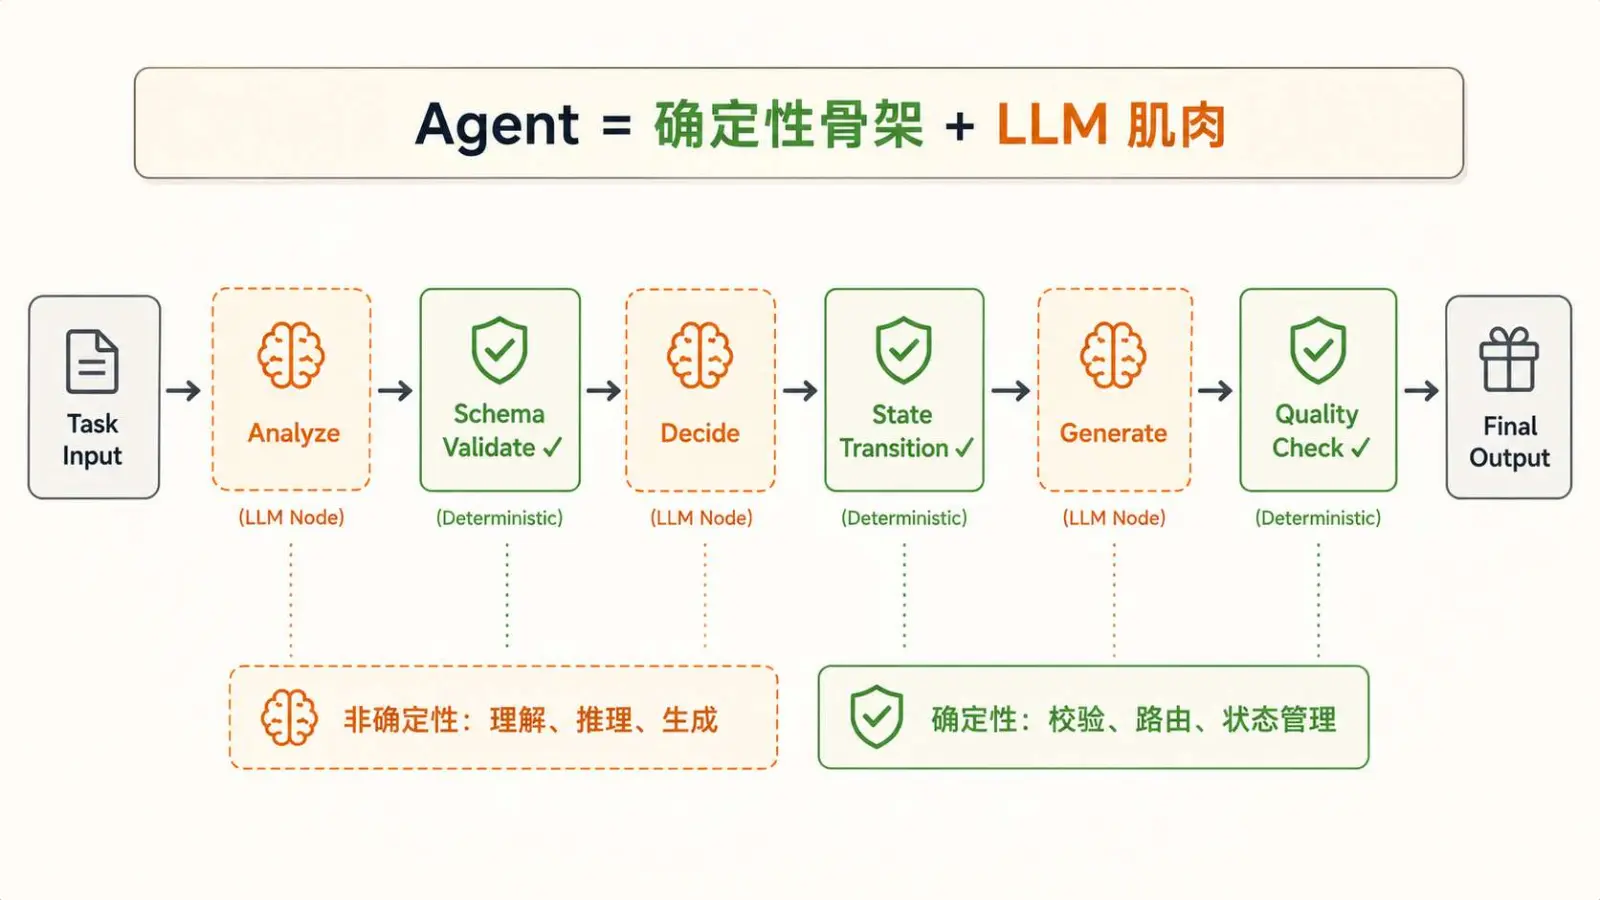
核心思路一句话:把 LLM 当组件,不要当系统。
流程由代码控制。 哪些步骤、什么顺序、满足什么条件进入下一步、出错怎么办,全部写在代码里,而不是写在 prompt 里。
LLM 只做它擅长的事。 理解自然语言、生成文本、做判断交给模型;「接下来做什么」的决定权收回到代码手里。
每一步都有校验。 模型输出后,用代码检查格式、关键字段和逻辑是否自洽。不通过就重试或报错,而不是默默往下跑。
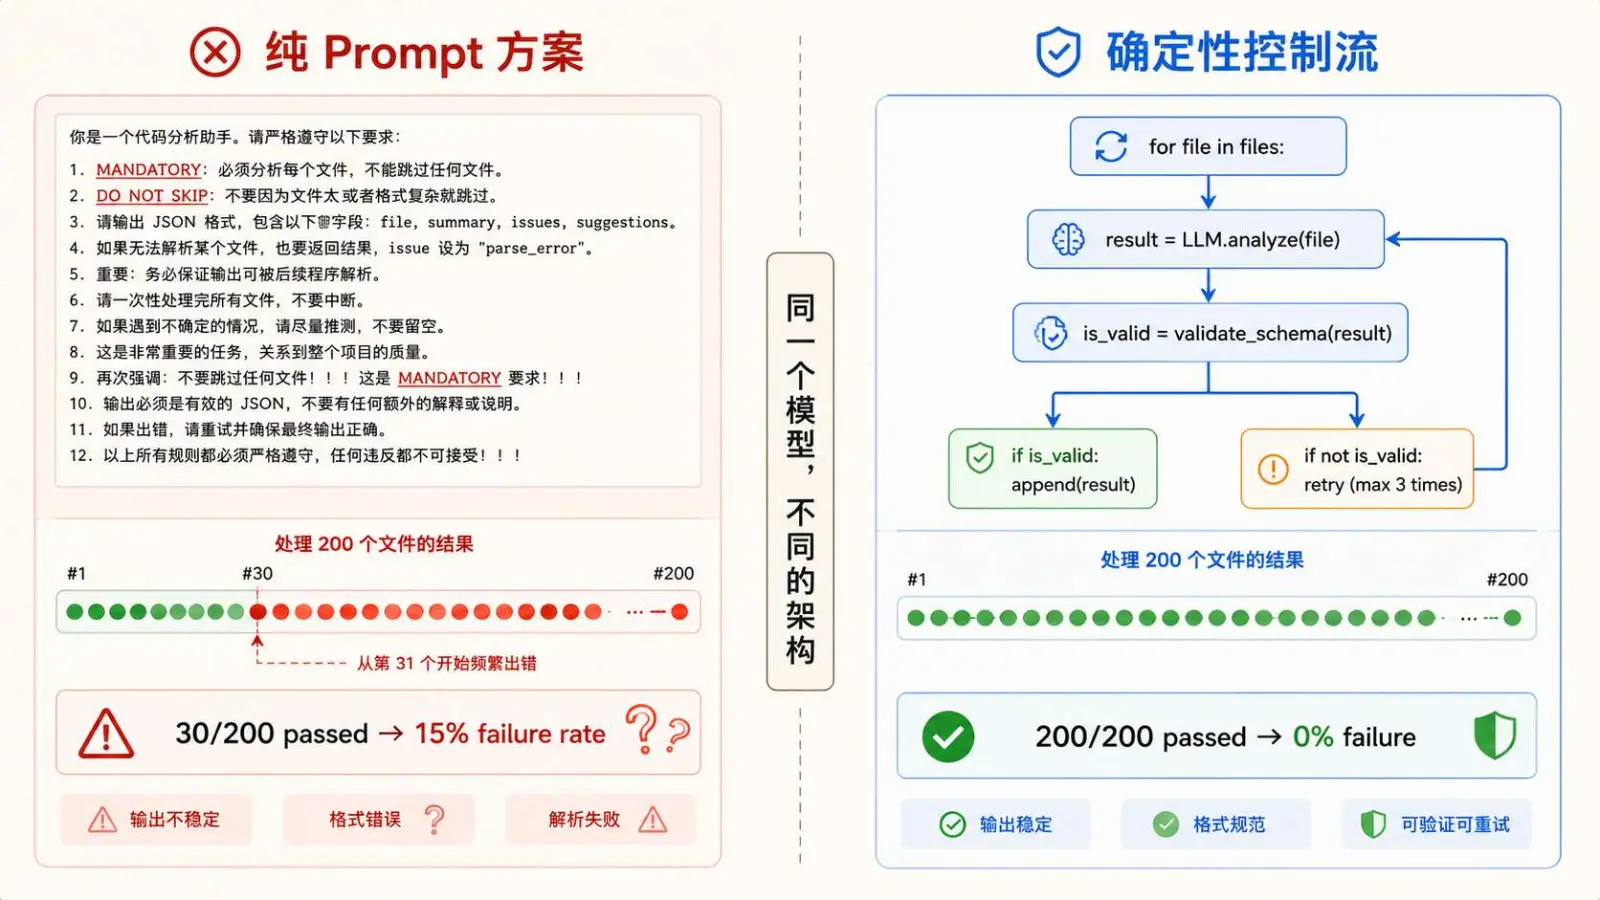
同样是处理 200 个文件,写成代码大致是这样:
for file in files:
    # 1. 代码控制:每次只处理一个文件
    result = llm.analyze(file)

    # 2. 确定性校验:检查输出格式
    if not validate_schema(result):
        result = llm.analyze(file, retry=True)

    # 3. 校验通过才写入,否则记录错误
    if validate_schema(result):
        report.append(result)
    else:
        errors.append(file)
这里模型只负责分析单个文件,流程、校验、重试和错误收集全由代码完成。对比纯 prompt 方案:
请依次分析以下 200 个文件,每个文件输出一份 JSON 报告,
必须包含 severity、description、file_path。
请严格按顺序执行,不要跳过任何文件。
(MANDATORY: DO NOT SKIP ANY FILE)
两种写法用的可以是同一个模型,但前者每一步都可检查、可追溯,后者只能祈祷。
没有程序化校验时的三种选择
Brian 指出,确定性编排只解决了一半问题,另一半是主动发现错误。如果没有程序化校验,就只剩三条路:
| 模式 | 做法 | 代价 |
|---|---|---|
| 保姆 | 人一直盯着,每一步人工检查 | 能用,但违背了自动化的初衷 |
| 审计 | 跑完之后做全量端到端验证 | 能发现问题,但成本可能比手动做还高 |
| 祈祷 | 跑出什么算什么,直接接受 | 省事,风险全靠运气 |
现实里不少人用的是第三种。
业界的做法
这个思路并不新。Stripe 公开介绍过内部的编码 Agent 系统 Minions,做法是在 Agent 步骤之间穿插确定性的环节,比如固定执行的检查和测试,模型负责「想」,代码负责「管」。
Claude Code、Codex 这类工具本身也是这样:模型之外有一整套确定性的工具调用、权限和上下文管理机制。你在 Claude Code 里用 Hooks 拦截危险操作,就是把规则从 prompt 搬进代码的典型例子,具体可以看 用 Claude Code Hooks 装上三道硬护栏。
怎么开始改造你的 Agent
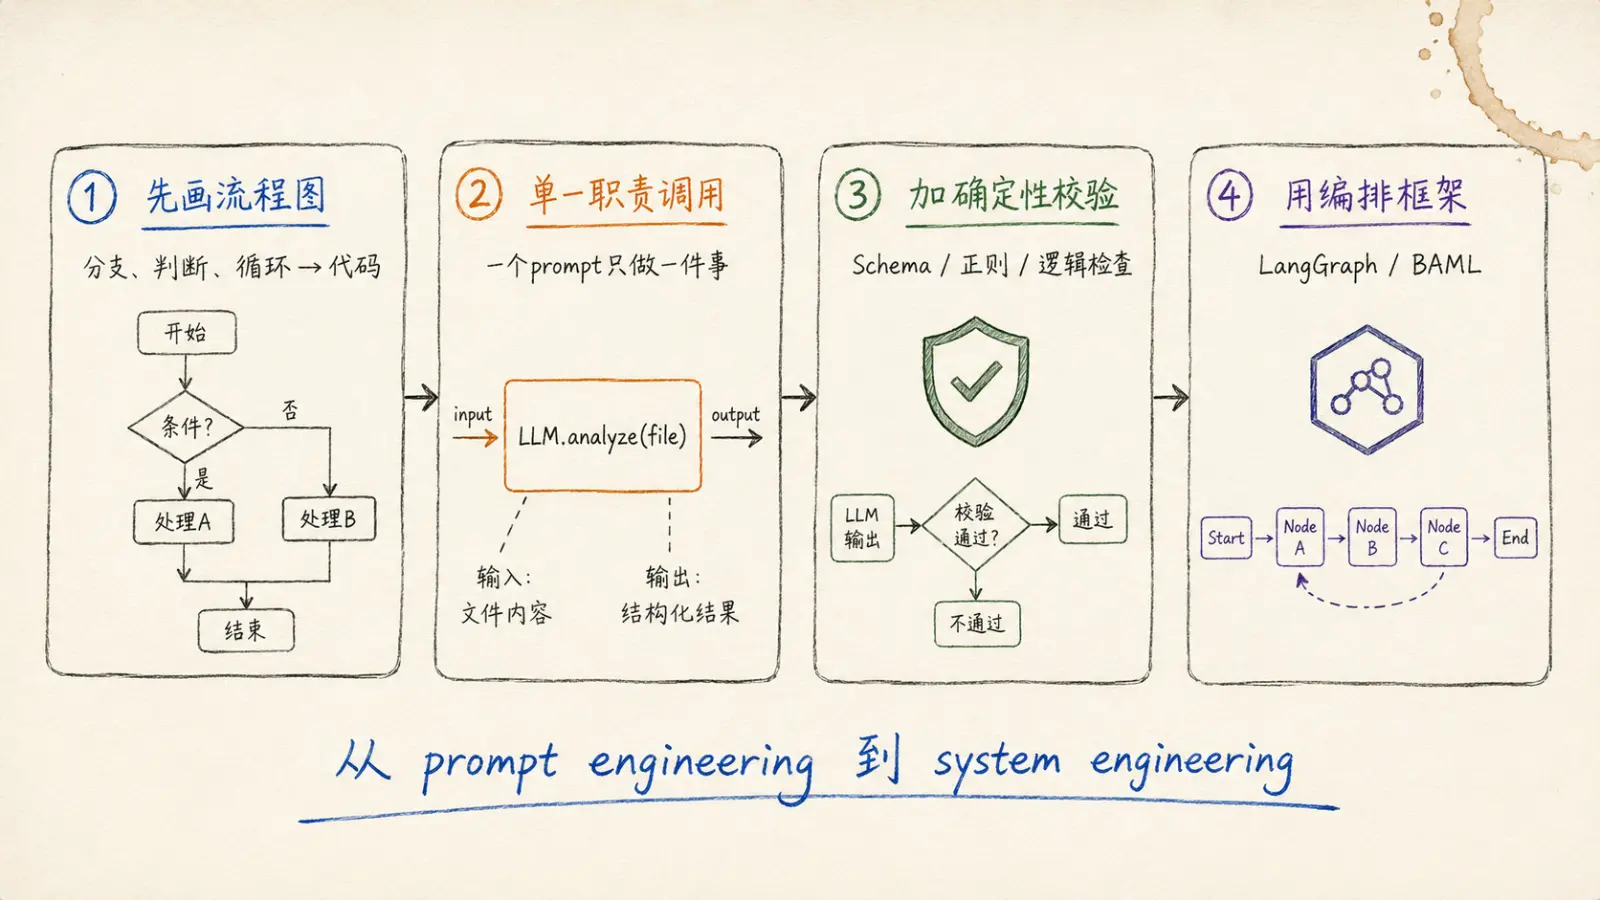
- 先画流程图,再写 prompt。 把 Agent 要做的事画出来,每个分支和判断节点标清楚,再逐个问:这段逻辑该放在 prompt 里还是代码里?多数时候答案是代码。
- 每次 LLM 调用只做一件事。 别让一个 prompt 同时分析、判断、输出,拆成几个输入输出明确的小调用。
- 不要直接信任模型输出。 用 JSON Schema 校验格式,用代码检查关键字段和逻辑一致性,不通过就重试或升级给人。
- 考虑现成框架。 LangGraph、BAML 这类工具就是用来把 LLM 调用编排成确定性工作流的;需要长时间运行、可恢复的流程,也可以看 Temporal 这类工作流引擎。如果你的场景是固定 AI 编程流程,Archon 的 YAML 工作流 是同一思路的另一种实现。
限制与注意事项
- 开放式任务不好拆。 「调研某个主题并写报告」这类探索型任务很难写成固定流程,确定性控制流最适合可重复、对可靠性要求高的工作。
- 别过度约束。 每一步都限死,Agent 的灵活性也就没了;模型变强以后,有些脚手架可能会多余。
- 校验写得太松等于没写。 校验条件太宽,系统只会更快地得出错误结论。宁可大声失败,也不要悄悄输出错的结果。
总结
模型进步解决不了这个问题,因为它不是智力问题,而是架构问题。软件之所以可靠,是因为系统由库组成、库由模块组成、模块由函数组成,每一层都有明确的输入输出约定,prompt 链没有这种性质。
下次发现自己在 prompt 里写 MANDATORY 时,先停一下想想:这一步是不是该交给代码?如果你在用 Claude Code 或 Codex 搭这类流程,也可以通过 AIGoCode 接入,把模型调用放进自己的脚本里统一管理。
参考链接
- Brian Suh:agents need control flow, not more prompts:https://bsuh.bearblog.dev/agents-need-control-flow/
- Hacker News 讨论:https://news.ycombinator.com/item?id=48051562