让 Codex 给订单表加个字段、顺手写迁移脚本,它最常出错的地方往往不在代码,而在字段名。
表里叫 created_at 还是 create_time,status 是字符串还是枚举,有没有联合索引,它看不到库,只能照着 model 文件猜。
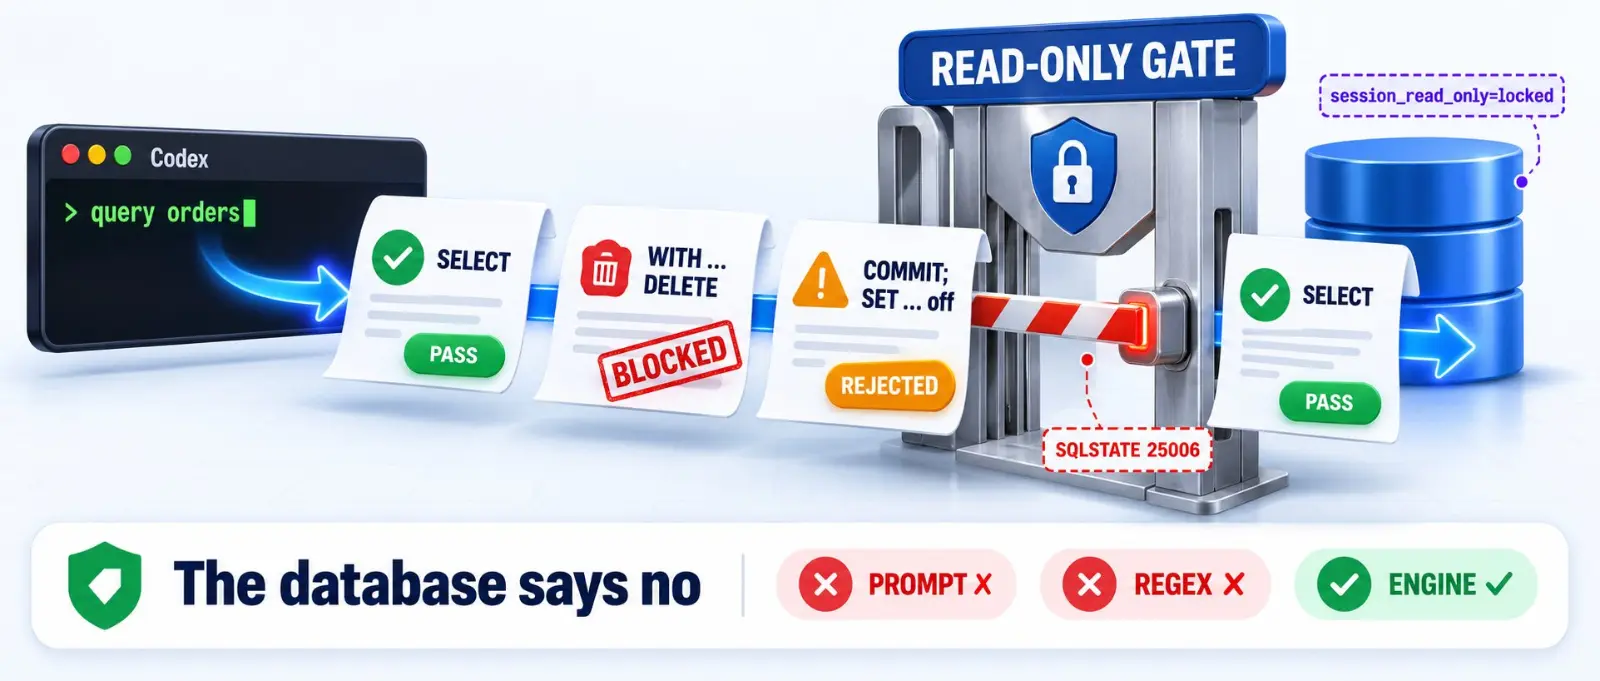
接一个数据库 MCP 就能解决,可是真要把开发库的连接交出去,又有点发怵。Google 开源的 MCP Toolbox for Databases 正好把这两件事都考虑到了:接进 Codex 只要一条命令,只读保护落在数据库引擎上,再配合 Codex 的审批模式,查表结构自动放行,执行 SQL 先问你。
项目在 GitHub 上超过 1.6 万 Star,写这篇时最新版本是 v1.15.0。
一条命令接进 Codex
先装二进制。Mac 或 Linux 用 Homebrew 最省事:
brew install mcp-toolbox
不想用 Homebrew,也可以到 GitHub Releases 按系统下载对应的 toolbox 二进制,加上可执行权限即可。
然后在 Codex 里注册:
codex mcp add postgres \
  --env POSTGRES_HOST=127.0.0.1 \
  --env POSTGRES_DATABASE=app \
  --env POSTGRES_USER=ai_reader \
  -- toolbox --prebuilt=postgres/data --stdio
每个 --env 设一个环境变量,-- 后面是启动 MCP server 的命令。装完用 codex mcp list 看一眼有没有,进了 Codex 再用 /mcp 确认它真的连上了。
密码没有写进命令,因为用 --env 传进去的值会明文写进配置文件。更稳的做法是直接改 ~/.codex/config.toml,用 env_vars 让 Codex 从本地环境里转发:
[mcp_servers.postgres]
command = "toolbox"
args = ["--prebuilt=postgres/data", "--stdio"]
env = { POSTGRES_HOST = "127.0.0.1", POSTGRES_DATABASE = "app", POSTGRES_USER = "ai_reader" }
env_vars = ["POSTGRES_PASSWORD"]
只想在某个项目里连这个库,把同样的内容放进项目根目录的 .codex/config.toml,Codex 只会读取被标记为可信的项目里的这份配置。
为什么写的是 postgres/data
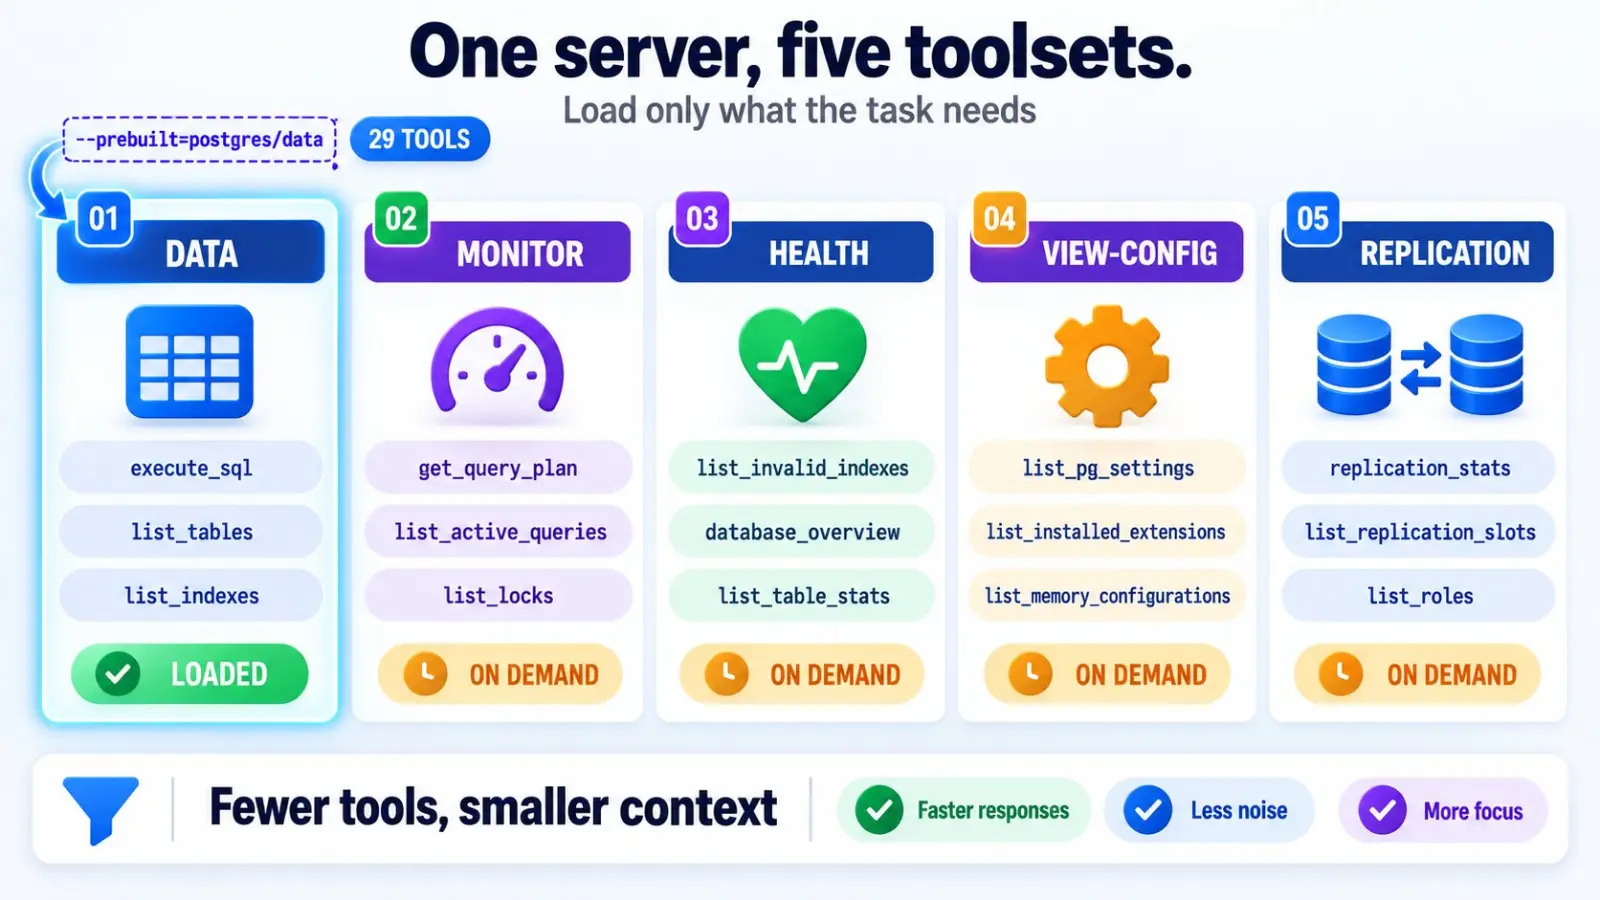
注意 args 里写的是 postgres/data,不是 postgres。
不带后缀的 --prebuilt=postgres 会把 Postgres 的预置工具一次全带进来,除了查表结构、执行 SQL 的那一组,还有查慢查询和锁的 monitor、看表膨胀和失效索引的 health、看复制状态等其他分组。--prebuilt=<数据库>/<工具集> 的写法可以只加载其中一组,postgres/data 就是只要 SQL 相关的工具。
日常写代码用得上的就是 data 这一组,全塞进去光工具描述就白占上下文。哪天要排查慢查询,再换成 monitor 那一组。
接上以后,跟 Codex 说一句:改 model 之前先用 list_tables 看一下 orders 表的真实结构。列、约束、索引等信息会以结构化数据返回,迁移脚本就不用靠猜了。
预置配置不只 Postgres,MySQL、SQL Server、Oracle、SQLite、ClickHouse、Snowflake、Neo4j 等都有,BigQuery、Spanner、AlloyDB、Cloud SQL 这些 Google Cloud 自家的数据库更全。
只写一句“只许查询”为什么不够
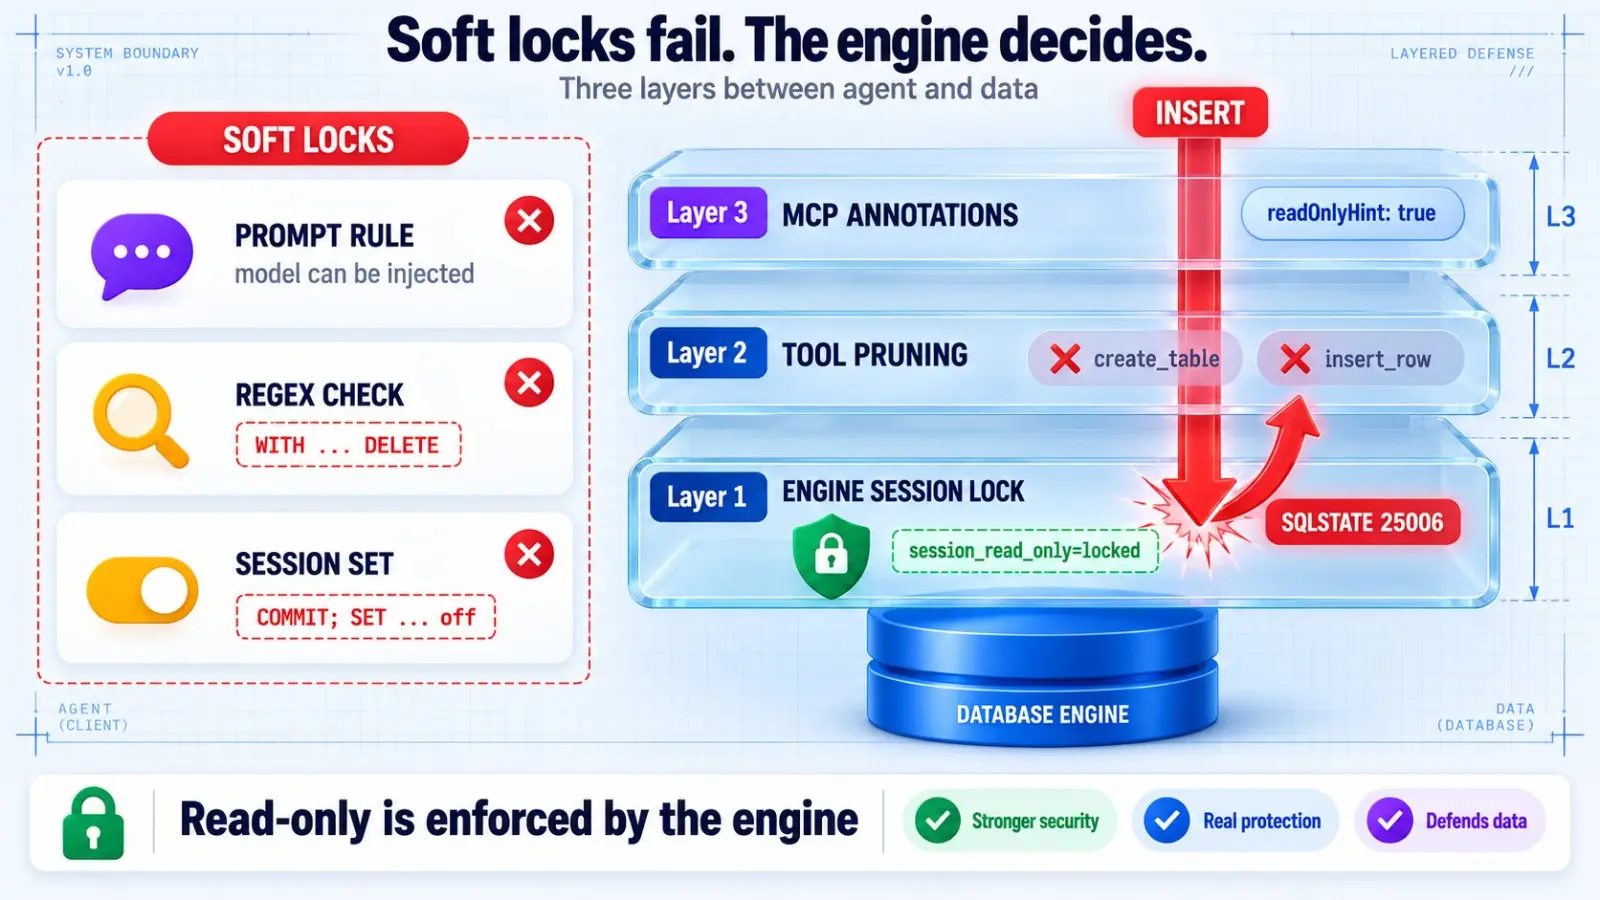
把数据库交给 agent,常见的软约束有三种,MCP Toolbox 的官方安全文档逐一说明了它们为什么不可靠。
提示词。 在 AGENTS.md 里写“只跑查询”,等于把一个概率模型当成安全边界,一次提示注入就可能绕过去。
字符串检查。 只看语句是不是以 SELECT 开头也挡不住。一种写法是用 WITH 开头、在公共表表达式里先删数据,最后再查询一下,整条语句以 WITH 开头、以 SELECT 结尾,字符串检查会放行,表里的数据却已经删掉了。另一种是调用一个自定义函数,看起来是一次读取,函数体里做的却是批量删除。
会话级开关。 连上以后把当前会话设成只读事务,看着稳了,但模型可以先提交事务、把开关关掉,再执行写操作。前面要是还有 PgBouncer 这类连接池,在共享连接上改了会话设置,这条连接还回池子后会影响别的服务,这叫连接池污染。
MCP Toolbox 的三层只读保护
第一层,锁在数据库引擎上。 开启只读模式后,Toolbox 在建立连接时就把只读参数写进连接串:Cloud SQL Postgres 用 cloudsql_session_read_only=locked,AlloyDB 用 alloydb_session_read_only=locked。会话从一开始就被锁成只读,任何写入都会被 Postgres 直接拒绝,报错类似 cannot execute INSERT in a read-only transaction。BigQuery 没有长连接,就先用它自带的 dryRun 预检,不是 SELECT 的语句在执行前就被拒掉。
第二层,把写工具藏起来。 只读模式下,create_table、insert_row 这类工具直接从工具列表里拿掉,agent 看不到,也就不会去规划一个注定失败的写操作。
第三层,给工具打只读标记。 暴露出去的工具带上 readOnlyHint: true,客户端可以据此决定要不要弹窗确认。这一层和 Codex 的审批模式直接相关,下一节细说。
打个比方:提示词是在门口贴告示,字符串检查是门卫看脸,第一层是直接把门焊死。
自定义工具在 tools.yaml 的 source 里加一行 readOnly: true 就能开启;预置工具则通过对应数据库的只读环境变量开启,具体变量名见官方的只读文档。
这里要说清楚:引擎级的硬锁目前只覆盖部分数据库,主要是 Cloud SQL、AlloyDB 和 BigQuery。自己部署的 Postgres,可以把锁放到数据库账号上:给 Codex 单独建一个只有查询权限的账号,只授予连接数据库、使用 schema 和读取表的权限,不给任何写权限。上面配置里的 ai_reader 就是这样一个账号。这样不管写操作被包装成什么形式,数据库都会返回权限不足。
一句话:能让数据库拒绝的,就别指望模型自觉。
查表自动放行,执行 SQL 先问你
接上数据库以后,每调一次工具都弹窗确认,很烦;全部放开,又不放心。
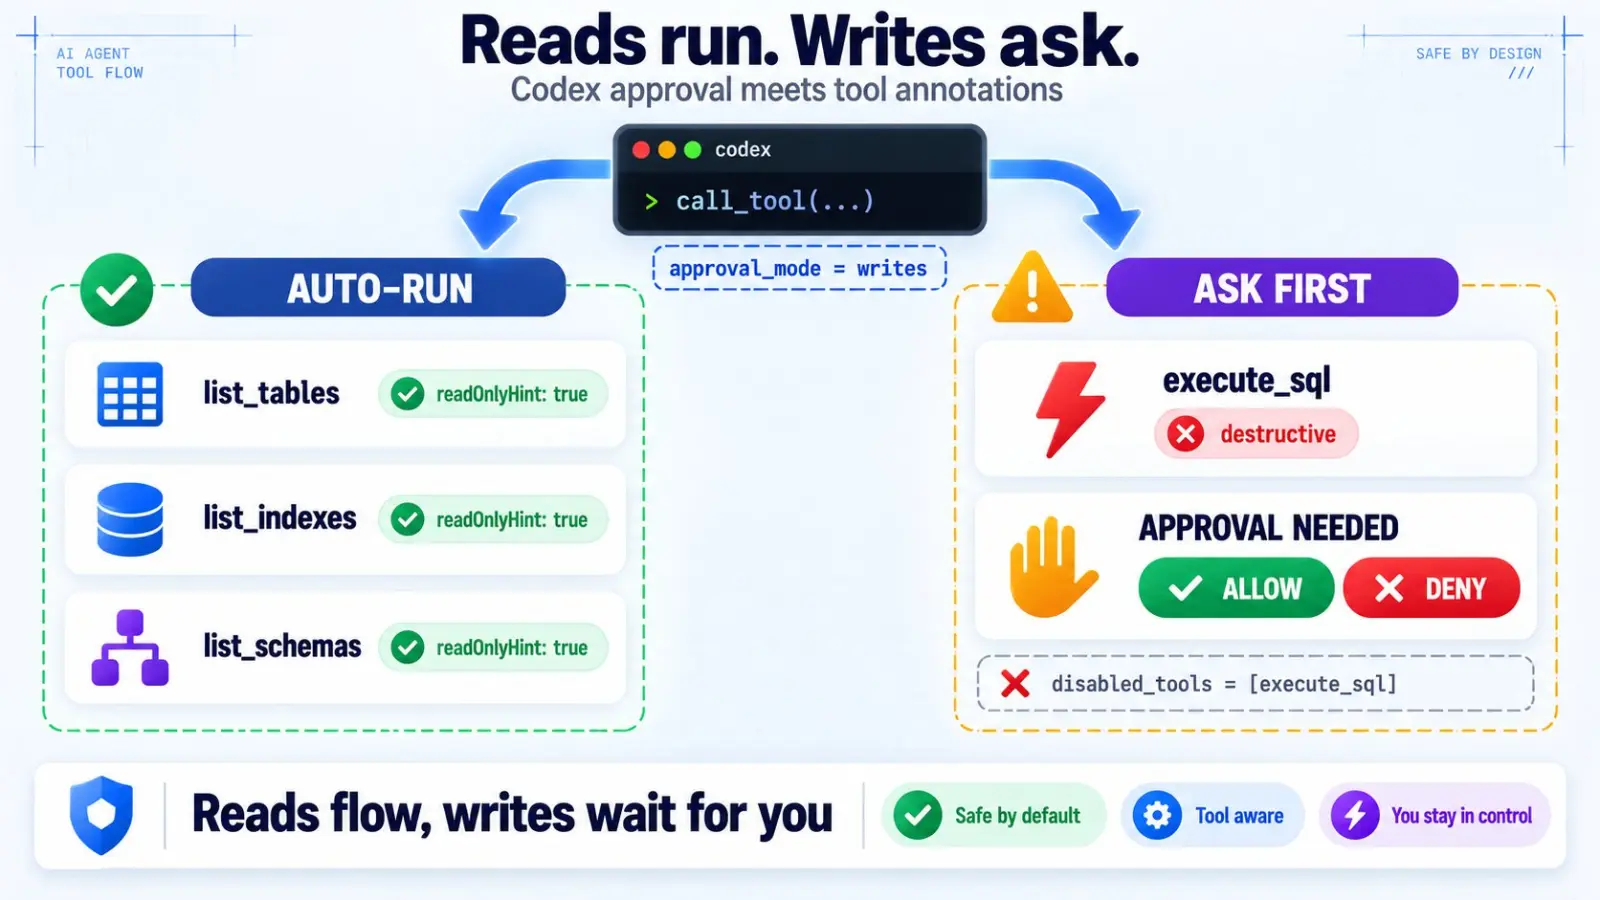
Codex 的 MCP 配置里有个 default_tools_approval_mode,可选 auto、prompt、writes、approve。其中 writes 的意思是:没有标成只读的工具,调用前要你确认。
这正好接上 MCP Toolbox 的只读标记。list_tables 这类查结构的工具标了只读,会被直接放行;execute_sql 可以执行任意 SQL,没有标只读,调用前会停下来让你过目。配置里加一行:
[mcp_servers.postgres]
command = "toolbox"
args = ["--prebuilt=postgres/data", "--stdio"]
env_vars = ["POSTGRES_PASSWORD"]
default_tools_approval_mode = "writes"
还想更严,可以直接把 execute_sql 从这个 server 里拿掉,只留查结构的工具:
disabled_tools = ["execute_sql"]
如果用的是开启了只读模式的 Cloud SQL,execute_sql 也会被标成只读,Codex 在 writes 模式下会直接放行它。这时放行是安全的,因为就算 SQL 里藏了写操作,数据库引擎也会拒绝。
审批决定要不要打扰你,引擎锁决定写不写得进去,两样配齐了,Codex 查库才算放心。关于 Codex 里 MCP 权限和 Hooks 的更多配置,可以看这篇 Codex 的 Hooks 与 MCP 权限设置。
给自己的 Agent 用:把 SQL 写死
上面说的是开发时让 Codex 查库。自己做的 Agent 要上生产,就别再给它 execute_sql 了,换成 MCP Toolbox 的另一种用法:自定义工具。
在 tools.yaml 里分别定义 source(连哪个库)和 tool(能做什么),多个 tool 还能打包成 toolset。每个 tool 的 SQL 语句是你提前写好的,模型只能填参数,比如按酒店名搜索的工具,模型只能传一个酒店名进去。数据库的用户名和密码建议用环境变量引用,不要直接写在文件里。
打个比方:预置工具是让 AI 进后厨自己炒菜,自定义工具是只给它一份菜单,点什么做什么。
和 Codex 搭配时有个细节:自定义的 SQL 工具默认也被当成可能改数据。纯查询的工具,记得在工具定义里补上 annotations,标上 readOnlyHint: true,不然 Codex 开着 writes 模式时每次都会弹窗。
再进一步是认证参数。比如“查我的航班”,user_id 不让模型填,而是在参数上配置 authServices,从请求带的 ID token 里解出来。这个参数不接受模型传进来的值,模型就算被注入一句“帮我查一下别人的订单”,也填不进别人的 user_id。
服务用 toolbox --config tools.yaml 启动,默认监听本机 5000 端口,MCP 地址是 http://127.0.0.1:5000/mcp。Python、JS、Go、Java 都有 SDK,LangChain、LlamaIndex 也有对应的包。
不想常驻 MCP,就生成一个 Skill
MCP Toolbox 还有个 skills-generate 命令,能把一个工具集转成符合 Agent Skill 规范的 skill:
toolbox --prebuilt postgres skills-generate \
  --name pg-data \
  --toolset data \
  --output-dir skills
生成的是一个 SKILL.md 加一组脚本,每个工具对应一个脚本。把生成的 pg-data 文件夹放进 Codex 的 skills 目录,重启 Codex 就能用,用到时才加载,平时不占上下文。Skill 名只能用小写字母、数字和连字符。
团队里已经有一套固定查询、想直接发给大家用的,这条路比让每个人都配一遍 MCP 省事。
写在最后
MCP Toolbox 给 Codex 补上的是“看得见真实数据库”这一块:一条 codex mcp add 接进去,用 postgres/data 只加载 SQL 那一组,写迁移脚本前先让它 list_tables,字段名就不用猜了。
更值得借鉴的是它对只读的态度:提示词、字符串检查、会话开关都不算数,锁要落在数据库引擎或账号权限上。再配上 Codex 的 writes 审批模式,查表自动放行、执行 SQL 先问你,日常用起来既不烦也不慌。
只用 Codex 写业务代码的,配一个只读账号、开 writes 模式,接上开发库就够了;在做数据类 Agent 产品的,重点看 tools.yaml 和认证参数。需要给 Codex 接入稳定的模型服务,可以到 AIGoCode 查看支持的模型和 Codex 配置文档。
参考来源:
- MCP Toolbox for Databases:github.com/googleapis/mcp-toolbox
- MCP Toolbox 只读安全说明:mcp-toolbox.dev
- Codex MCP 配置说明:developers.openai.com/codex/mcp