大多数人用 Claude Code 的方式是一问一答:提一个需求,等它回复,再提下一个,全程盯着。这种方式适合小改动,但遇到“把一个库从零重写一遍”“把旧项目迁移到新框架”这类要做几天的任务,人就成了瓶颈。
2026 年 3 月,Anthropic 研究员 Siddharth Mishra-Sharma 在官方博客分享了一套做法:先写好指令文件,在集群节点的 tmux 里启动 Claude Code,然后关掉笔记本,隔几个小时用手机看一眼 GitHub 提交记录。Claude(文中用的是 Opus 4.6)用几天时间从零实现了一个可微分的宇宙学玻尔兹曼求解器,这类代码通常需要领域专家花几个月甚至几年。
这篇文章把这套 Claude Code 长任务工作流整理成 5 步:写计划文件、建进度文件、准备测试基准、用 Git 做监控、在 tmux 里跑执行循环并用 Ralph Loop 防止提前收工。它不限于科研,适合任何目标明确、能用测试验证的长任务。
核心思路:从逐步指导到定好目标放手跑
传统用法里,你像老师,AI 像学生,每一步都要你指导。长任务的做法反过来:你像项目经理,负责定目标、写清验收标准、准备参考实现,具体工作交给 Agent 自己去磨,人只需要偶尔检查。
Anthropic 的文章把这类任务的特点概括为:范围清楚、成功标准明确、人的监督可以是“偶尔”而不是“持续”。重写数值求解器、把老 Fortran 代码迁移到现代语言、对照参考实现调试大型代码库,都属于这一类。
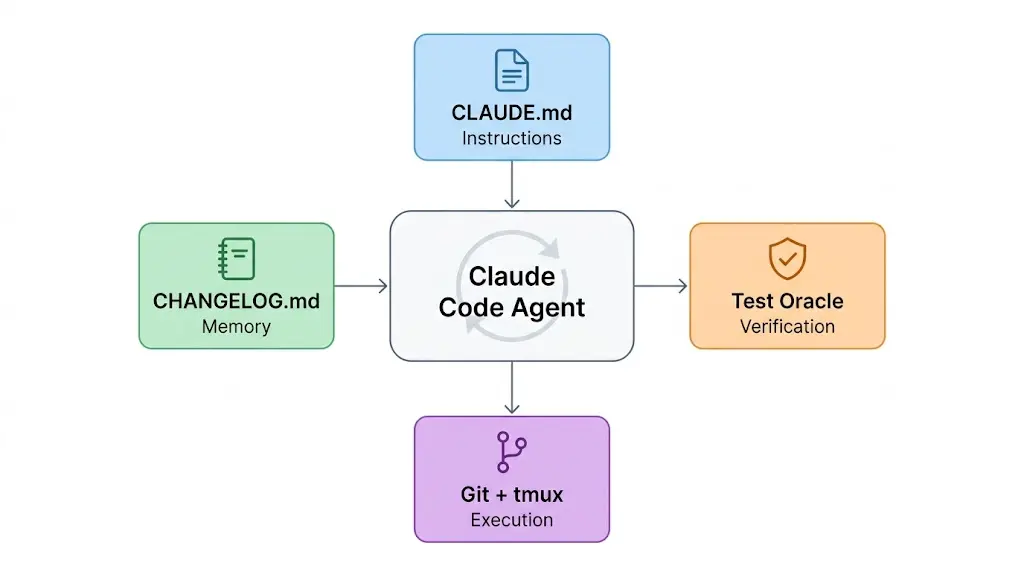
整套工作流由下面几个组件组成:
第 1 步:写好 CLAUDE.md,作为 Agent 的项目说明书
所有指令写在项目根目录的 CLAUDE.md 里。Claude Code 会特殊对待这个文件,始终把它留在上下文中,并以它为总体计划。作者建议把大部分时间花在这一步:和 Claude 一起反复打磨,直到计划看起来靠谱。
这个文件应该包含:
- 项目的高层目标和交付物;
- 精度或质量要求,比如“主要输出与参考实现 CLASS 的偏差不超过 0.1%”;
- 已经确定的设计决策和约束;
- 提交规范,比如“每完成一个有意义的工作单元就 commit 并 push”;
- 测试要求,比如“每次提交前运行
pytest tests/ -x -q,不能提交破坏已有测试的代码”。
关键一点是 Claude 可以自己修改这个文件。随着项目推进,它会更新计划、记录新的设计决策,指令和项目一起演进。如果你用的是 Codex,对应的做法是写 AGENTS.md,可以参考 AGENTS.md,把项目规范写给 Codex,看懂并就近生效。
第 2 步:建一个进度文件,让 Agent 跨会话记住踩过的坑
进度文件在文章里叫 CHANGELOG.md,是 Agent 跨会话的长期记忆,相当于实验室笔记本。在 CLAUDE.md 里要求 Claude 持续更新它。
一个好的进度文件会记录:当前状态、已完成的任务、失败的尝试和原因、关键检查点的精度表、已知限制。
失败记录尤其重要。没有它,下一个会话会重新尝试同样的死胡同。一条典型记录是:“尝试用 Tsit5 求解扰动方程,系统太刚性,已切换到 Kvaerno5。”
第 3 步:准备测试基准,让 Agent 知道自己有没有进步
长时间自主运行最怕的不是出错,而是出了错不知道。Agent 需要一个客观的判断标准,文章里叫 Test Oracle。
它可以是参考实现、一个可量化的目标,或者现有的测试套件。在这个项目里,Claude 被要求以 CLASS 的 C 源码作为参考实现,不断构建并运行单元测试。还可以让 Agent 边做边扩充测试用例,防止改出回归。
这个思路完全可以搬到日常开发:只要有参考实现、一套测试用例或一个可量化的指标,就能用同样的方式让 Agent 自己判分。
第 4 步:用 Git 做协调和远程监控
Agent 每完成一个有意义的工作单元就 commit 并 push。这样做有三个好处:出问题时有可恢复的历史;进度随时可见;计算资源中途到期时,已完成的工作不会丢。
作者的监控方式很简单:排队买咖啡时用手机刷一下 GitHub 的提交记录。需要调整方向时,可以 SSH 进去重新给提示或修改 CLAUDE.md;更省事的做法是让本地的 Claude Code 帮你 SSH 进去执行命令。
第 5 步:在 tmux 里跑执行循环,并用 Ralph Loop 防止偷懒
建议先在本地把计划迭代好,写进 CLAUDE.md,再到计算节点上开始长跑。在 tmux 里启动 Claude Code 的好处是可以随时断开,关掉笔记本也不影响。
在使用 SLURM 调度的 HPC 集群上,一个启动脚本的示例如下(来自 Anthropic 原文):
#!/bin/bash
#SBATCH --job-name=claude-agent
#SBATCH --partition=GPU-shared
#SBATCH --gres=gpu:h100-32:1
#SBATCH --time=48:00:00
#SBATCH --output=agent_%j.log
cd $PROJECT/my-solver
source .venv/bin/activate
export TERM=xterm-256color
tmux new-session -d -s claude "claude; exec bash"
tmux wait-for claude
任务启动后,连上 tmux 会话给出方向,比如告诉 Claude “Read CHANGELOG.md and pick up the next task”,确认它在正常推进后按 Ctrl+B D 断开。之后想检查进度或调整方向,随时重新连接:
srun --jobid=JOBID --overlap --pty tmux attach -t claude
没有 HPC 集群也没关系,在本地或云服务器的 tmux 里跑 Claude Code 是同样的模式。核心不是硬件,而是 CLAUDE.md、进度文件和测试基准这套组合。
Ralph Loop:不让 Agent 提前说“做完了”
长任务有个常见问题:Agent 跑着跑着就声称完成了,实际上还差得远,甚至会说“今天差不多了,明天再继续吧”。文章把这叫作 agentic laziness。
解决办法是 Ralph Loop,本质上是一个循环:每当 Agent 说完成了,就把它踢回去,问它是不是真的做完了。Agent 往往会承认还没达标,然后继续干。Ralph Loop 是 Anthropic 官方插件市场里的插件,可以这样安装:
/plugin install ralph-loop@claude-plugins-official
如果提示找不到插件市场,先执行 /plugin marketplace add anthropics/claude-plugins-official。文章里的调用示例如下:
/ralph-loop:ralph-loop "Please keep working on the task until the success criterion of 0.1% accuracy across the entire parameter range is achieved." --max-iterations 20 --completion-promise "DONE"
Claude 最多迭代 20 次,直到它输出“DONE”确认目标真的达成。--completion-promise 是精确的字符串匹配,所以提示词里要写清楚“只有全部达标才输出 DONE”,并且始终设置 --max-iterations 作为保险;中途想停可以用 /cancel-ralph。文章还提到了类似的方案 GSD,以及 Claude Code 自带的 /loop 命令。
如果你更常用 Codex,想让它在无人值守时跑脚本和定时任务,可以参考 codex exec,把 Codex 接进 CI、脚本和定时任务。
实际效果:能压缩时间,但过程并不完美
Claude 从零开始跑了几天,最终和参考实现 CLASS 在各项输出上达到了 1% 以内的偏差。下图是 Claude 自己回溯整理的精度变化曲线,标出了各个开发里程碑。
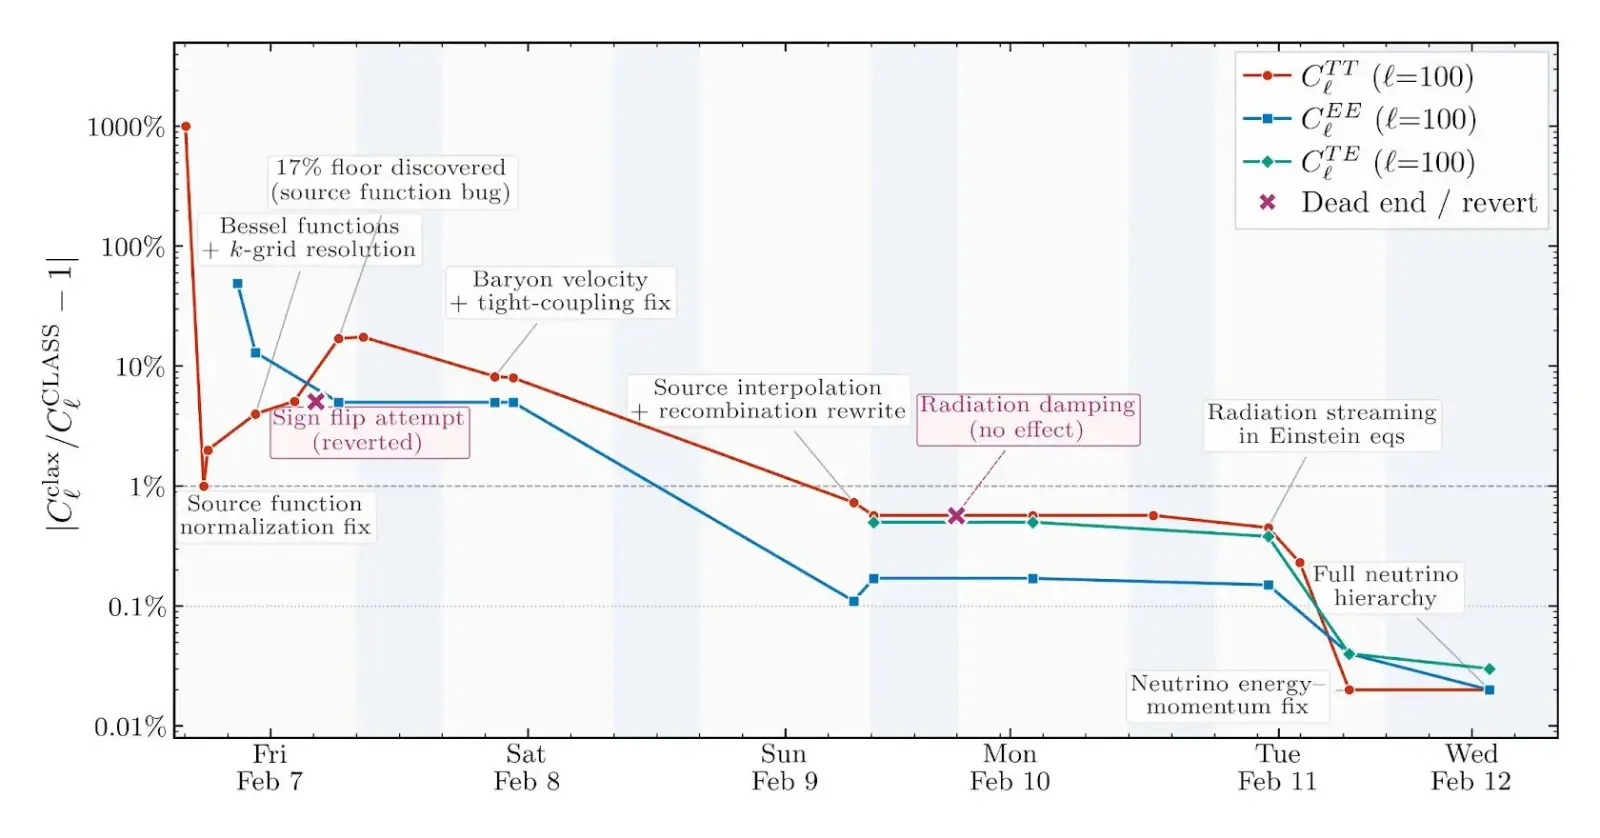
过程并不顺滑:测试覆盖有明显缺口,有一段时间只在一个参数点上测试;也会犯低级错误,比如在规范约定(gauge convention)上栽跟头,花几个小时追一个宇宙学家一眼就能看出的 bug。但它一直在朝目标推进。作者也明确说,结果还不是生产级,并不是在所有区间都达到可接受的精度。
一个意外收获是:这个项目不在作者的核心研究方向,但他顺着 Claude 的 commit 记录看下来,学到了不少玻尔兹曼求解器和相关物理知识。用他的话说,提交记录读起来像“一个速度很快、理解很字面的博士后写的实验笔记”。
哪些任务适合这样跑
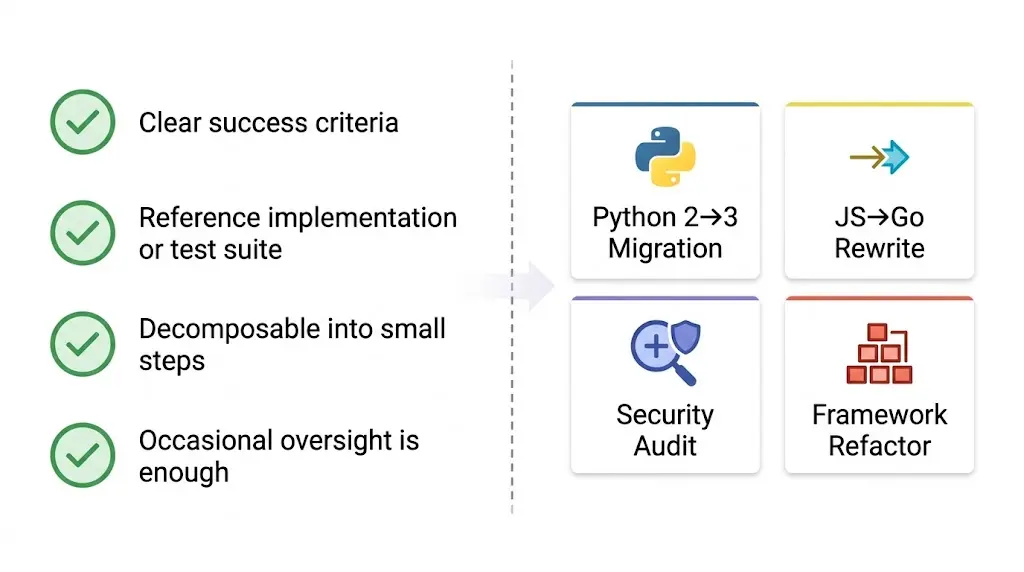
不只是科研,满足下面几个条件的任务都可以试:
- 有明确的成功标准:不是“做得好看一点”,而是“与参考实现偏差不超过 X%”“全部测试通过”;
- 有参考实现或测试套件:Agent 能客观判断自己的进展;
- 能拆成小步骤:每一步都能提交、都能验证;
- 不需要实时的人工判断:偶尔检查就够。
比如把旧项目从 Python 2 迁移到 Python 3、把一个 JS 库用 Go 重写、在大型代码库里做安全审计、用新框架重构已有项目。
总结
这套长任务工作流归结起来就是四件事:把目标写清楚(CLAUDE.md)、让 Agent 记住踩过的坑(进度文件)、给它一个能自己判分的标准(测试基准)、用 Git 当监控,再用 tmux 和 Ralph Loop 让它持续跑下去。
跑机器学习训练的人早就习惯了这个节奏:晚上提交任务,第二天看结果。Agent 开发正在变成同样的模式。如果你手头有一个目标明确、能用测试验证的项目,可以在 AIGoCode 上用 Claude Code 按这 5 步试一次。
参考链接
- Anthropic,Long-running Claude for scientific computing:https://www.anthropic.com/research/long-running-Claude
- Ralph Loop 插件说明:https://github.com/anthropics/claude-plugins-official/blob/main/plugins/ralph-loop/README.md