录过口播的人都有体会,剪视频最磨人的不是调色,也不是加字幕,而是找废话。十分钟素材里,嗯、啊、说错了重来一遍、两条之间那几秒发呆,全得拖着时间线一段段找出来剪掉。好不容易剪完,一播放,接缝处还“啪”地响一声。
video-use 是 Browser Use 团队开源的一个剪辑 Skill。用法很直接:素材丢进一个文件夹,在这个文件夹里启动 Codex,说一句“把这些剪成一条发布视频”,最后在 edit 目录里拿到 final.mp4。它在 Claude Code、Codex 等支持 Skill 的 Agent 里都能用,本文按 Codex 的用法讲:它怎么读视频、怎么装、装之前要对哪几处设置、一次剪辑怎么走、为什么剪完不会爆音。
它不看视频,它读台词本
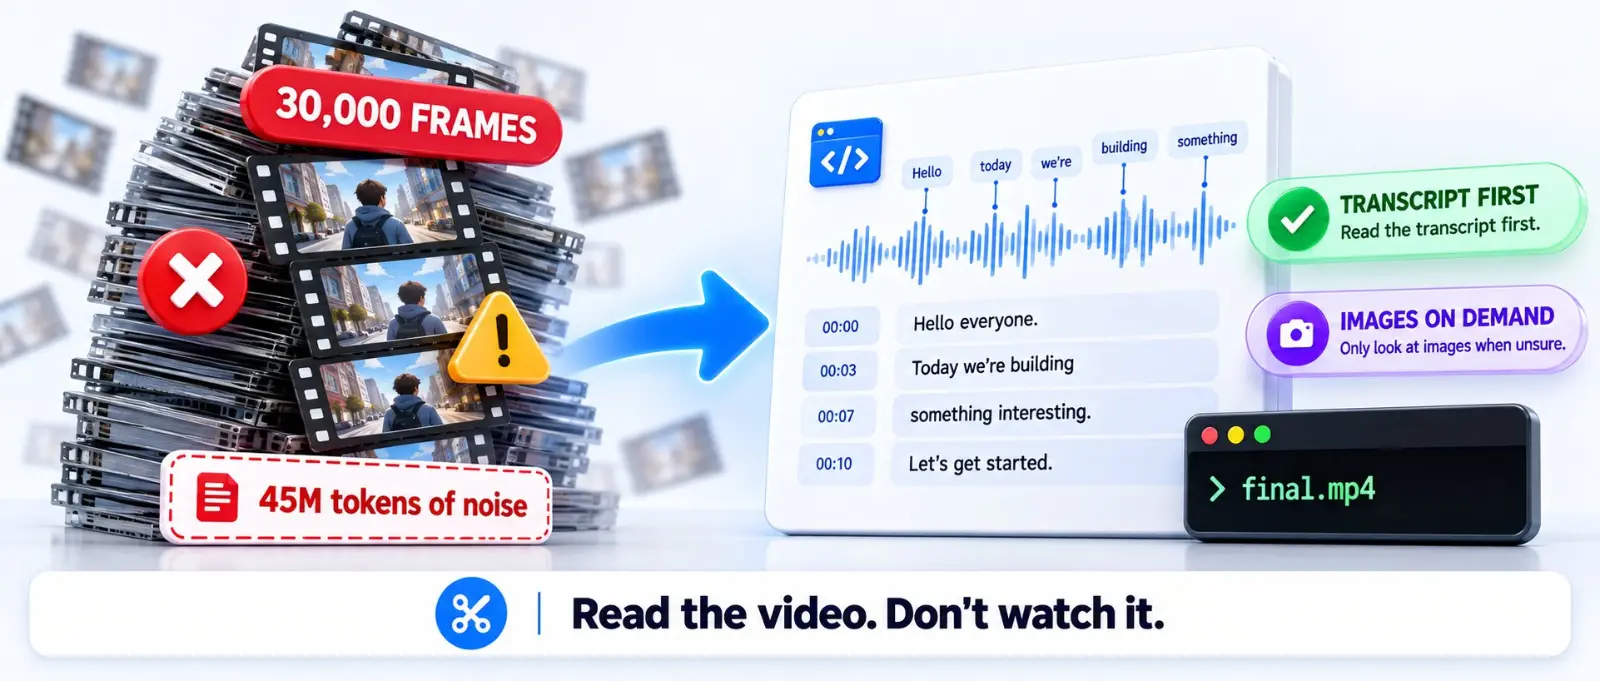
让大模型剪视频,最直觉的办法是把画面一帧帧喂进去。项目自己算过这笔账:30000 帧,每帧约 1500 token,大约 4500 万 token,几乎全是噪音。video-use 换了个思路,让模型读视频,而不是看视频,输入分两层。
第一层是逐字稿,一直挂在上下文里。 每个素材调一次 ElevenLabs 的 Scribe 语音转写,拿到词级时间戳、说话人区分,以及笑声、掌声、叹气这类音频事件。所有素材再打包成一份 takes_packed.md,遇到 0.5 秒以上的停顿或者换人说话就断一行,每行带起止时间:
## C0103  (duration: 43.0s, 8 phrases)
  [002.52-005.36] S0 Ninety percent of what a web agent does is completely wasted.
  [006.08-006.74] S0 We fixed this.
哪句说错了、同一句话录了三遍哪遍最顺,模型看这份文本就能判断,剪辑点直接落在词和词的边界上。
第二层是画面,只在拿不准的时候看。 timeline_view 这个脚本会把某一段时间做成一张 PNG:上面一排胶片帧,下面是波形,两个停顿不知道从哪剪、两条重录不知道选哪条的时候,才调一次。它不是用来扫全片的工具。
说白了,它是个读台词本的剪辑师,大部分时间对着稿子下刀,偶尔抬头看一眼画面。要让模型真能看到这些 PNG,前提是你用的模型支持图片输入。
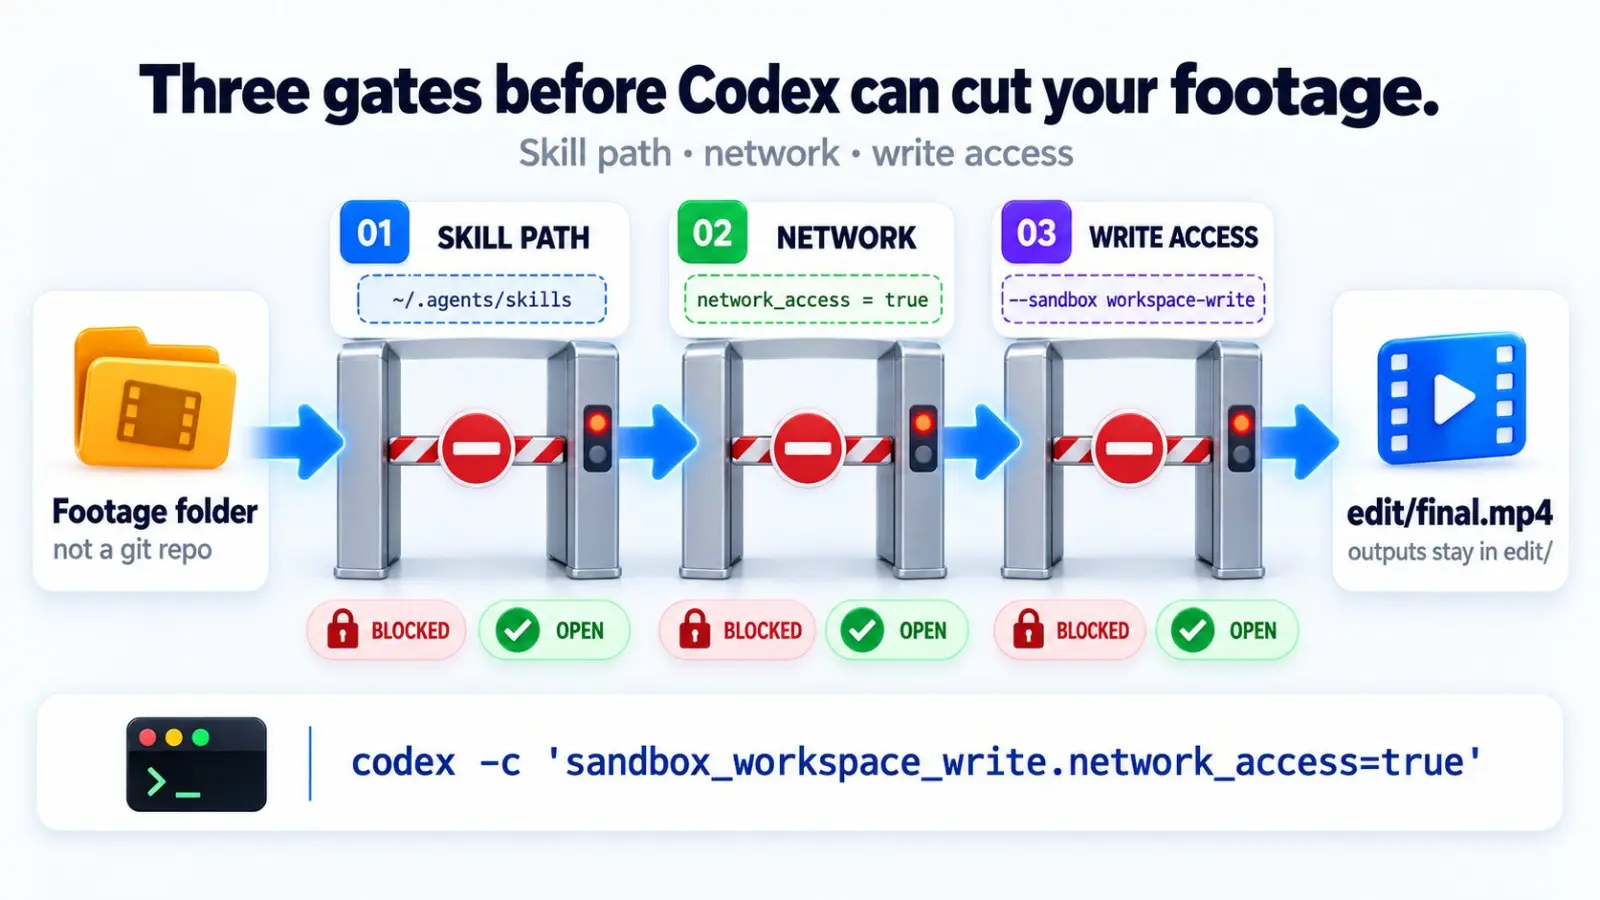
装进 Codex,先对三处设置
硬条件先列清楚:ffmpeg 和 ffprobe 必须有;Python 依赖用 uv sync 或 pip install -e . 安装;转写全靠 Scribe,需要一个 ElevenLabs 的 API key,没有 key 什么都转不了,而且转写会消耗额度。要做动画叠加的话还得有 Node.js,其中 HyperFrames 要求 Node 22 以上。yt-dlp 只在要从链接下载素材时才需要。
最省事的装法,是把官方安装说明(install.md)交给 Codex 去做:让它先读 install.md,克隆仓库到一个固定位置(比如 ~/Developer/video-use),装依赖和 ffmpeg,把 Skill 注册到当前 Agent,最后只在需要 API key 的时候停下来问你。官方明确要求安装过程中不要自己跑转写,因为转写要花钱。key 写进仓库根目录的 .env,权限设为 600,不要提交到仓库。
手动装也就几步:
git clone https://github.com/browser-use/video-use ~/Developer/video-use
cd ~/Developer/video-use
uv sync
brew install ffmpeg
然后在仓库根目录新建 .env,写入一行 ELEVENLABS_API_KEY=你的 key。装完先别急着剪,Codex 这边有三处要对一下。
第一处:Skill 放哪。 install.md 给 Codex 的注册方式,是把整个仓库软链到 ~/.codex/skills/video-use。而 Codex 官方文档现在写的用户级 Skill 目录是 ~/.agents/skills,扫描时会跟着软链走。装完在 Codex 里输入 /skills,列表里没有 video-use,就再链一份:
mkdir -p ~/.agents/skills
ln -sfn ~/Developer/video-use ~/.agents/skills/video-use
注意链的是整个目录,不是只链 SKILL.md。Skill 用到的 transcribe.py、render.py 这些脚本都在 helpers 下面,必须和 SKILL.md 放在一起。Codex 会自动检测 Skill 的变化,没出现就重启一次。想系统地了解 Skill 怎么写、怎么复用,可以看这篇:Codex Skill 怎么写,从复用流程到脚本化工作流。
第二处:联网。 每次转写都要请求 ElevenLabs 的接口,做 HyperFrames、Remotion 动画时还要用 npx 拉包。Codex 的 workspace-write 沙箱默认不开放出站网络,所以这些命令会一条条弹审批找你批,或者直接失败。配置项是 sandbox_workspace_write.network_access。
第三处:写权限。 video-use 要在素材目录下创建 edit 文件夹放所有产出,所以沙箱至少得是 workspace-write,只读模式下它连 edit 目录都建不出来。
后两处,一条启动命令就能一起解决:
cd ~/Videos/launch-raw
codex --sandbox workspace-write --ask-for-approval on-request -c 'sandbox_workspace_write.network_access=true'
这里的 -c 只对这一次会话生效。想一劳永逸,就在 ~/.codex/config.toml 里加 [sandbox_workspace_write] 段并写 network_access = true。不过那等于所有项目都放开了出站网络,更稳妥的做法是只在剪视频的时候带上这个参数。
一次剪辑是怎么走的
进了素材目录,可以输入 $video-use 显式点名这个 Skill,也可以直接说需求。官方建议的第一句话是这两种:
edit these into a launch video
inventory these takes and propose a strategy
后面它按固定的 8 步走:
- 盘点:用 ffprobe 看每个素材的参数,transcribe_batch.py 以 4 个并发转写,再打包成 takes_packed.md,挑一两段看一眼画面。
- 预扫:通读一遍逐字稿,把口误、说错、不该用的说法列成清单。
- 沟通:用大白话告诉你它看到了什么,再按素材情况问问题,包括视频类型、目标时长、横屏竖屏、节奏、哪些必须留、哪些必须删、要不要调色和字幕。
- 出方案:4 到 8 句话讲清结构、选哪几条、怎么剪、动画和调色怎么做、预计多长,然后停下来等你确认。
- 执行:生成剪辑决策表 edl.json,逐段调色,并行做动画,最后渲染。
- 预览:先出一个快速预览版本。
- 自检:见下一节。
- 迭代:按你的反馈修改,定稿后把这次的决策追加进 project.md。
第 4 步是硬规则:方案你没确认,它不会动剪辑。剪辑决策表是个普通的 JSON,每一段写明用哪个素材、从第几秒到第几秒,外加选这一段的理由,比如:
{"source": "C0108", "start": 14.30, "end": 28.90,
 "beat": "SOLUTION", "reason": "Only take without the false start."}
哪一刀剪得不对,直接指着这个文件跟它说,比在时间线上找要快。所有产出都放在素材目录下的 edit 文件夹里,原素材不动,video-use 自己的仓库目录也不写。project.md 每次会话追加一段,记录策略、决策和遗留问题,下次在同一个文件夹里启动,它会先读这个文件,用一句话复述上次做到哪。
为什么剪完不会“啪”一声
video-use 把规则分成两类:12 条硬规则管正确性,必须遵守;其余全是示例,配色、字体、调色参数、字幕样式,模型可以按素材自己发挥。这 12 条硬规则,大多对应一种不报错、成片却会坏掉的情况。挑几条最容易碰上的:
每个剪辑点加 30 毫秒的音频淡入淡出。 不加的话,每个接缝都可能有爆音,开头说的那声“啪”就是这么来的。
不在词中间下刀,剪辑点前后留 30 到 200 毫秒的余量。 原因写得很实在:Scribe 的时间戳会漂 50 到 100 毫秒,留余量就是为了吃掉这点误差。
字幕放在滤镜链的最后一步。 先烧字幕再叠动画,动画会把字幕盖住,而渲染不会报任何错。
先逐段切出来,再无损拼接。 每段单独提取、调色,再用 -c copy 拼起来,避免加动画时每一段被重复编码两次。
转写结果按素材缓存,素材没变就不重复转写。 转写要花钱,这条规则同时也是省钱规则。
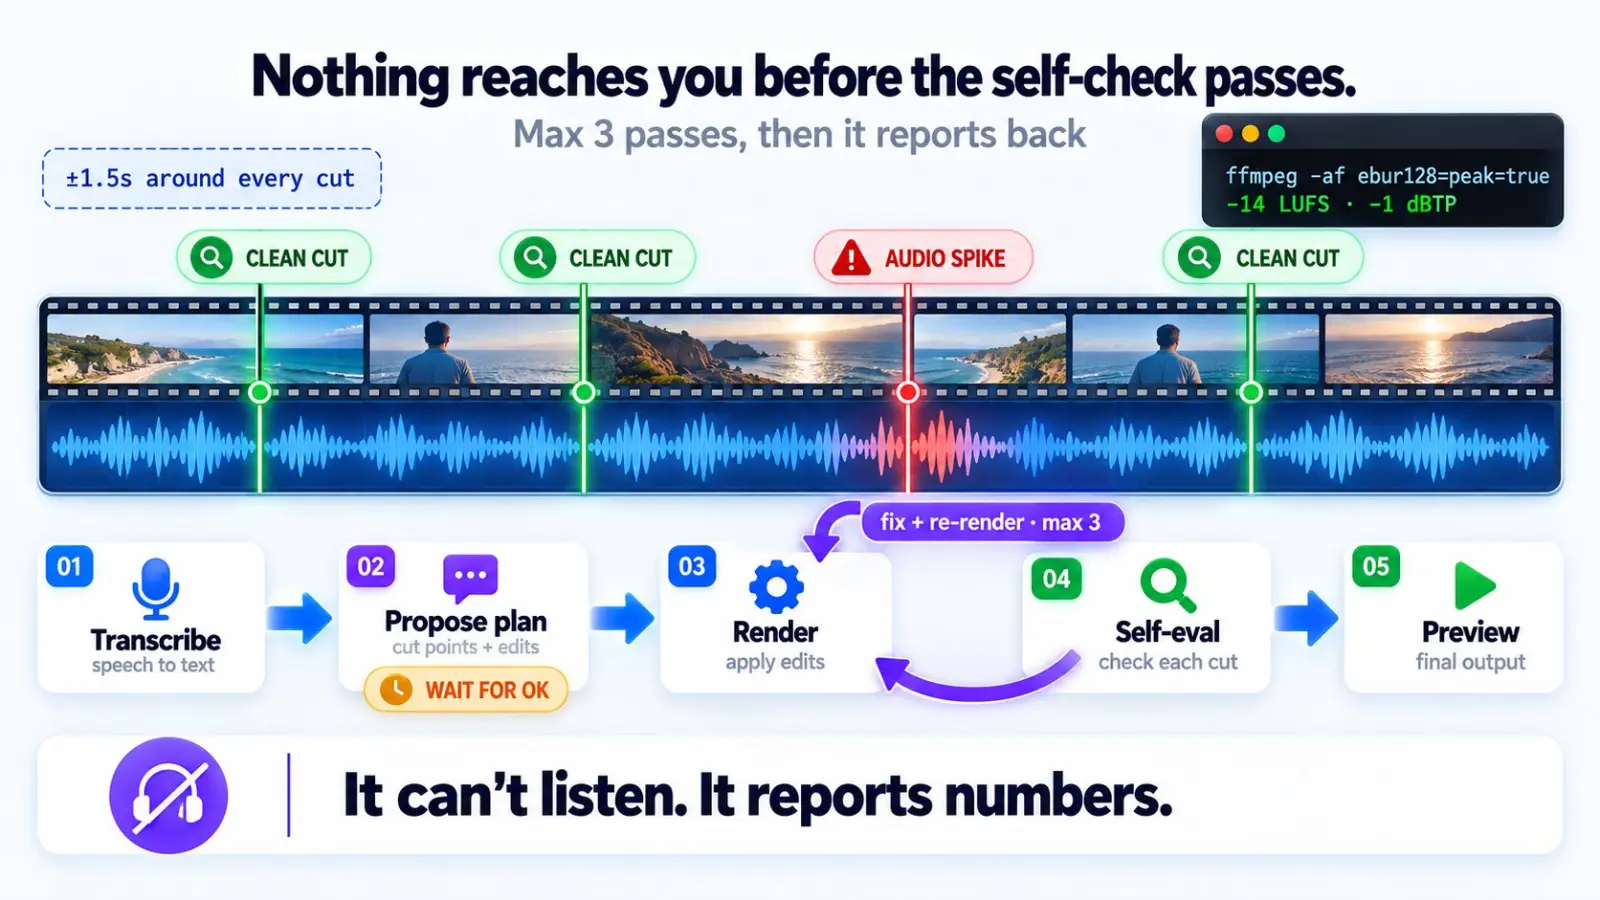
渲染完,它不会马上拿给你看。Skill 要求它先对成片(不是原素材)的每个剪辑点,前后各取 1.5 秒跑一次 timeline_view,检查画面有没有跳、波形在接缝处有没有尖刺、字幕有没有被动画挡住;再抽开头 2 秒、结尾 2 秒和中间几处,看调色和字幕是否一致。响度也要量,而不是凭感觉:
ffmpeg -i out.mp4 -af ebur128=peak=true -f null -
混音时,Skill 的建议是两遍 loudnorm 到 -14 LUFS,真峰值不高于 -1 dBTP,再按段落实测一遍。发现问题就修、重渲染、再检查,最多 3 轮,3 轮还过不了就把问题摊给你,不会一直转圈。对要对外发布的视频,还会再派一个专门挑刺的子代理,要求给出带时间码的问题清单和最该先改的 5 处。
Skill 里有一句话我挺喜欢:它听不见声音,就老实说听不见,然后把响度数字报出来。音乐好不好听、配音顺不顺耳,这个判断还是留给你。
动画交给子代理
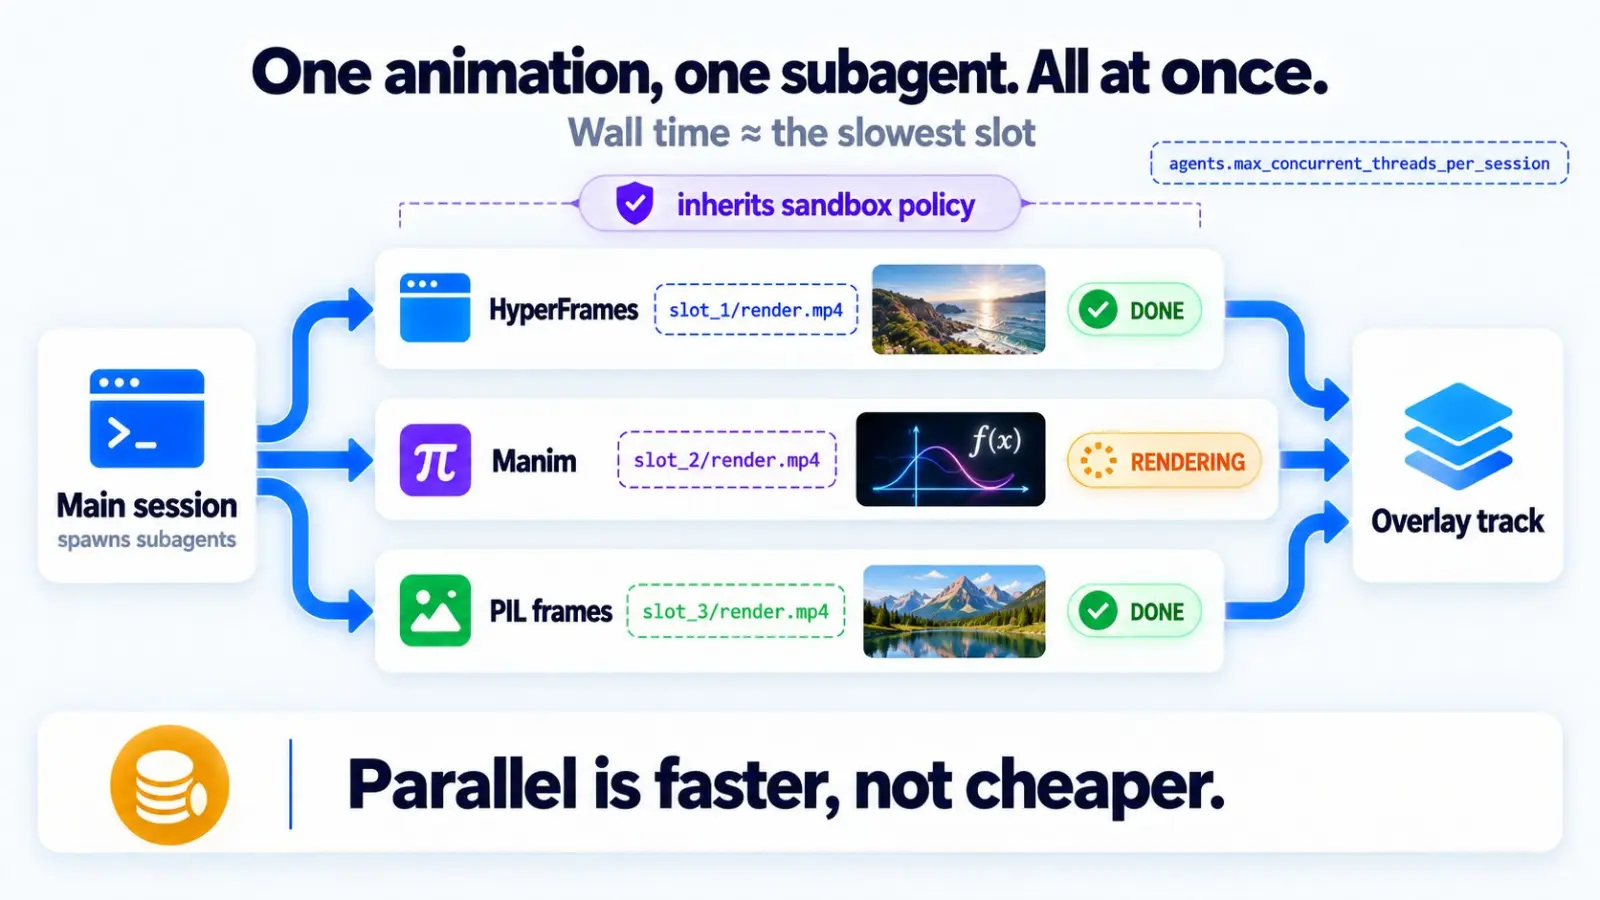
需要动画叠加时,video-use 按每一段动画单独挑引擎:界面动效和文字动画用 HyperFrames,已有 React 组件体系的用 Remotion,公式、图表、状态机用 Manim,简单的数字计数、打字效果直接用 PIL 出一串 PNG 再交给 ffmpeg 合成。
硬规则里要求多段动画并行做:一段动画派一个子代理,总耗时约等于最慢的那一个。Skill 原文写的是用 Agent 工具派子代理,这是 Claude Code 里的叫法;在 Codex 里,子代理由 Codex 自己的多代理机制承担。关于 Codex 子代理怎么用,可以看这篇:Codex 子代理,让主线程保持干净并行处理任务。
有两点要心里有数。一是子代理继承父会话的沙箱策略:启动时没开网络,子代理里的 npx 一样拉不了包。二是同时开几个,由 agents.max_concurrent_threads_per_session 这个配置控制,不设就由 Codex 自己决定默认值;子代理比单代理更费额度,动画段数多的项目要留意消耗。
使用前的几个提醒
- 转写会把音频发到 ElevenLabs,素材里有保密内容先想清楚能不能上传。
- 转写按用量计费,装好后先拿一小段素材试,不要一上来丢整个素材库。
- 它能量化响度、检查接缝,但不能“听”,成片的听感需要你自己把关。
- 这是还在快速迭代的开源项目,本文基于 2026 年 10 月能读到的仓库说明,命令和目录以仓库最新的 install.md 和 SKILL.md 为准。
总结
video-use 的思路说穿了很简单:不让模型去看几万帧画面,而是给它一份带词级时间戳的逐字稿,剪辑点落在词和词的缝里,只在拿不准的时候看几张时间线图。成片质量靠 12 条硬规则兜底,渲染完先把每个剪辑点自查一遍,最多修三轮再交给你。
放到 Codex 里,真正要花心思的是装之前那三处设置:Skill 目录、沙箱联网、edit 目录的写权限。对好了,剩下的就是聊需求、确认方案。找废话的那几个小时它能帮你省下来,这条视频到底要讲什么,还是你说了算。如果你通过 AIGoCode 使用 Codex,这个 Skill 与接入渠道无关,按上面的步骤配置即可。
参考链接
- video-use GitHub:https://github.com/browser-use/video-use
- Codex Skill 官方文档:https://developers.openai.com/codex/skills
- ElevenLabs 语音转文字接口文档:https://elevenlabs.io/docs/api-reference/speech-to-text/convert