做 AI 应用的人,多半被用户问过这么一句:我上次不是跟你说过吗?用户上周说过自己吃素,这周 AI 照样推荐红烧肉;在 Claude Code 里说了五遍项目用 Pydantic v2,第六次它还是写 v1。原因都一样,会话一结束,上下文就清空了,下次从零开始。
Mem0 是专门解决这件事的记忆层,Apache 2.0 开源,有 Python 和 TypeScript 两套 SDK。你把对话交给它,它自己抽出值得记的事实存起来,下次对话前再把相关的几条捞回来。它最有意思的设计是:旧记忆一条不改,新记忆只往上叠,挑哪条靠查询时按时间和实体去排。
本文按“它怎么存、怎么查、跑分怎么看、Python 怎么接、Claude Code 怎么装”的顺序展开,文中涉及的参数和命令以官方文档为准,版本更新较快,使用前建议再对照一遍。
存的时候:只加不改
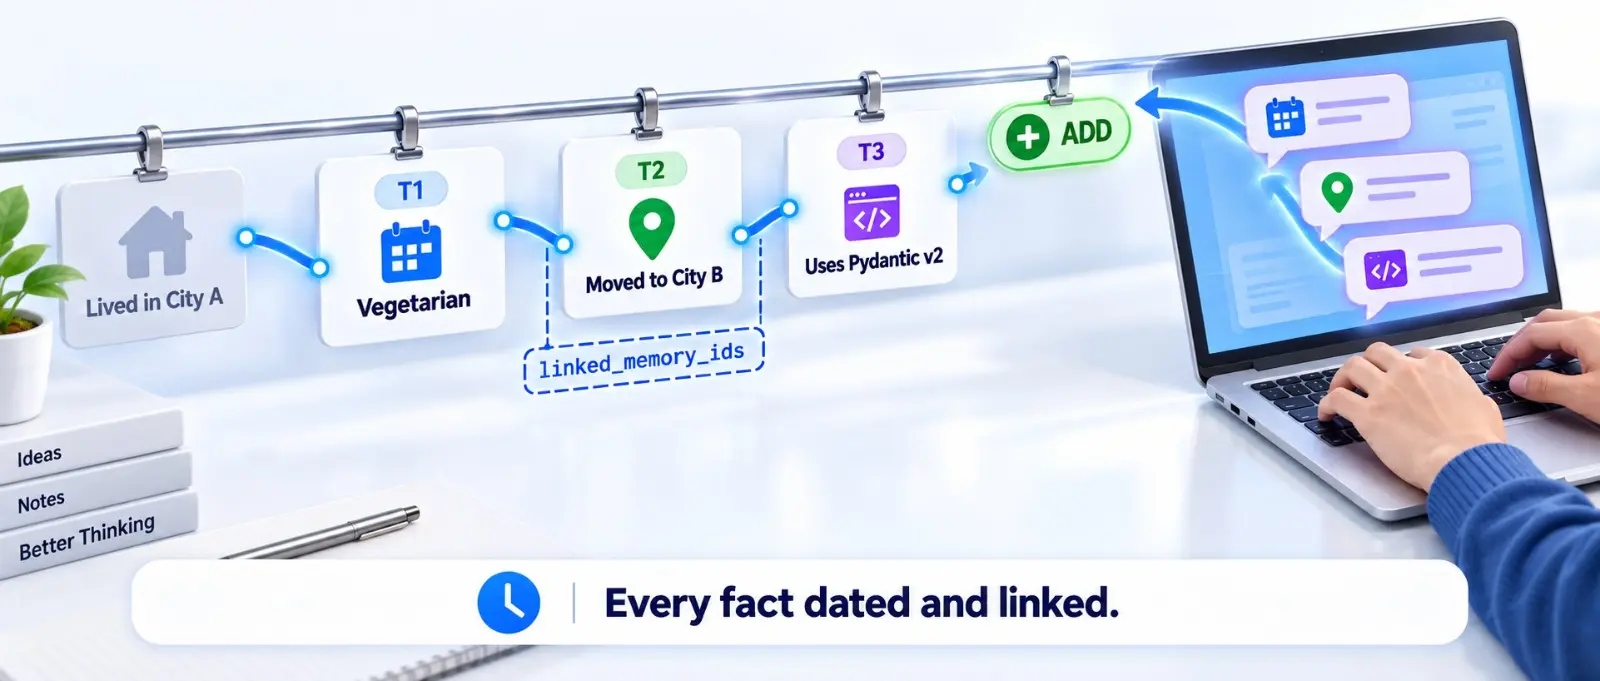
Mem0 新算法的写入只有一种操作:ADD。从对话里抽出一条事实,就新增一条;不改写旧记忆,也不删,抽取只调用一次模型。官方迁移指南把流程写得很清楚:先取回最相关的 10 条已有记忆作为去重参考,单次模型调用抽出所有新事实,批量向量化,用哈希做精确去重,再批量入库。
只加不改,最直觉的担心是库会乱:同一件事存了好几个版本怎么办?它的做法是让旧记忆只用来去重和建立关联。用户半年前说住北京,上个月说搬去了上海,库里会同时有这两条,并且彼此关联。你问他现在住哪,应该答上海;问搬家前住哪,答北京。官方文档里的说法是:信息变化时,新事实与旧事实并存,由检索负责把最相关、最新的排到前面。
另一个设计思路是把相对时间换成绝对日期。“上周去了巴黎”这句话放到半年后就没用了,换成具体日期,同一件事的不同版本才排得出先后。助手说过的话也会被抽取,给过的推荐、一起定下的方案都算,所以 Agent 自己做过什么,下次还查得到。
查的时候:三路信号一起打分
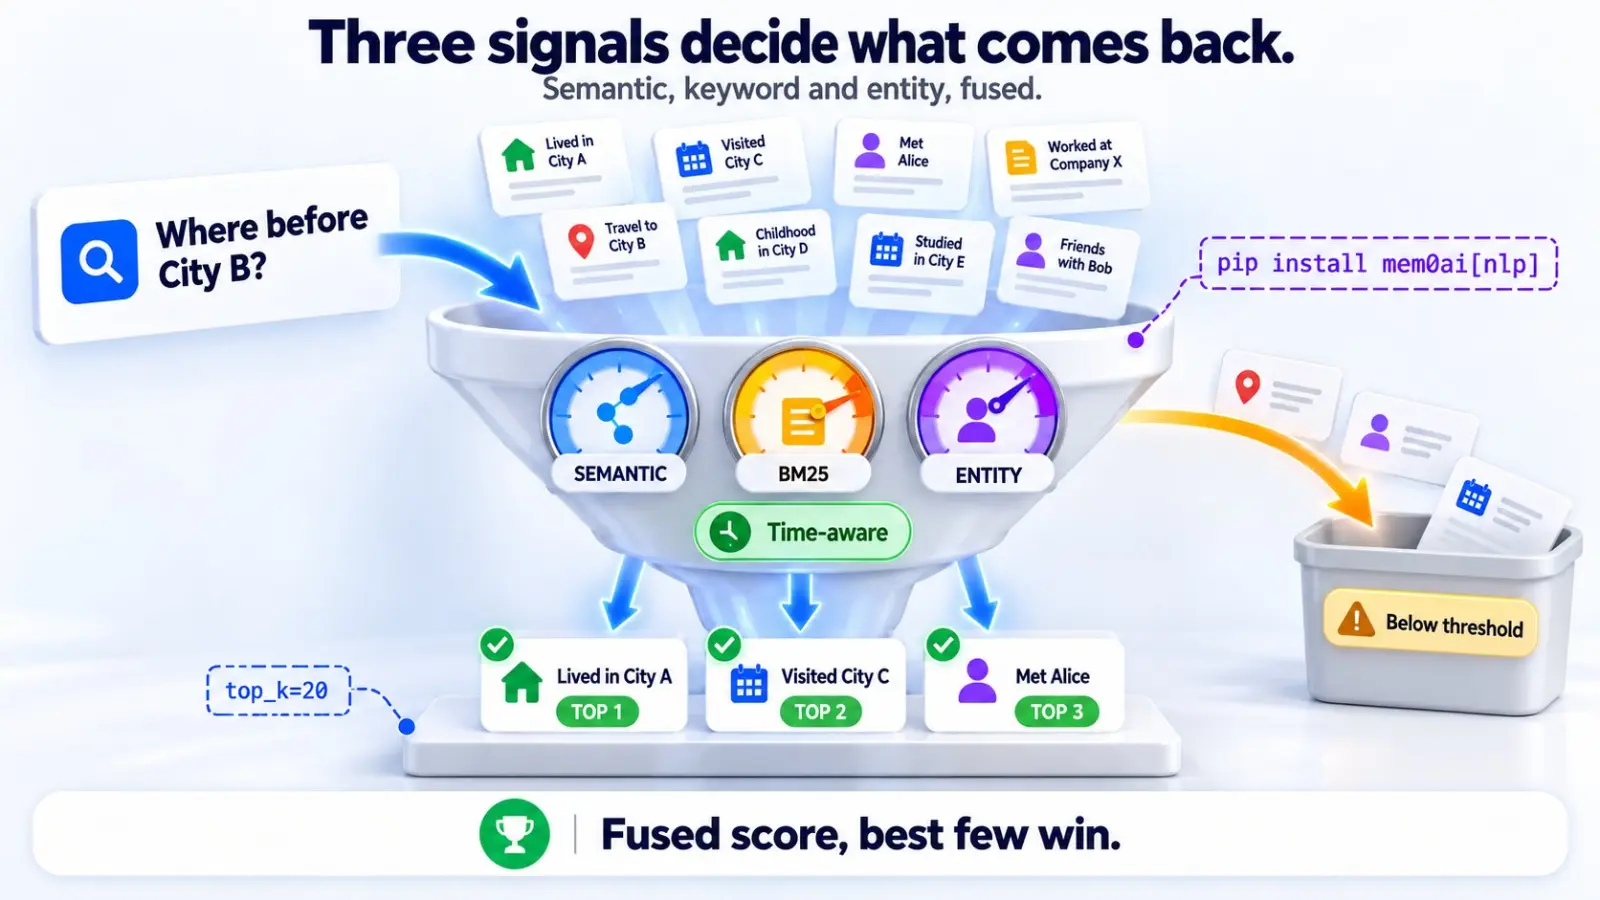
存的时候不做判断,判断都压在检索这一步。官方文档描述的混合检索是三路信号并行打分,再融合成一个分数:
- 语义向量相似度;
- BM25 关键词匹配;
- 实体匹配:把人名、地名、项目名单独抽出来做向量,问题里提到的实体和哪些记忆重合,那几条就往前排。
要注意,BM25 和实体匹配只是加分项,不会扩大候选范围,候选仍然来自语义检索。检索还支持时间感知:问“上周”“现在”“截至某月”之类,会按记忆的时间戳去匹配。
跑分怎么看
官方更新日志(2026 年 4 月)给出的开源 SDK 数字是:LoCoMo 从 71.4 提到 91.6,LongMemEval 从 67.8 提到 93.4,检索一次通常不到 7K token,而全量上下文方案要 25K 以上;问“搬家前住在哪”这类时间推理题,准确率从 51% 提到 93%。官方首页还会展示托管平台的成绩,平台版带有开源版没有的专有优化,数字不会完全一样。
看这类数字要留两个心眼:一是它是官方自己的评测,评测框架虽然开源、可以自行复现,但跑分高不等于在你的场景里好用;二是 Mem0 版本迭代很快,数字会变,引用时请标明版本和时间。你的场景里存什么、问什么,比这张表重要得多。
Python 里十几行就能接上
Mem0 有三种用法:直接装库、自己起服务,或者用官方云平台。只是想试试,装库就够了:
pip install "mem0ai[nlp]"
python -m spacy download en_core_web_sm
nlp 扩展装的是 spaCy,负责实体提取和关键词词形还原。不装也能跑,但检索会退化成只有语义一路。官方说明 [nlp] 扩展目前只支持 Python 3.10 到 3.12,3.13 上会因为依赖没有预编译包而安装失败。如果向量库用的是 Qdrant,还要再装 fastembed,BM25 才会启用,否则会悄悄退回语义检索。
核心就两个方法,add 负责存,search 负责查。开源版默认依赖 OpenAI 的模型和 embedding,具体默认模型与向量库以官方配置文档为准,最省事的跑法是先设好 OPENAI_API_KEY:
from mem0 import Memory

m = Memory()

# 存:把对话直接交给它,它自己抽事实
m.add([
    {"role": "user", "content": "我们项目用 Pydantic v2,别给我写 v1 的写法"},
    {"role": "assistant", "content": "好的,后面统一按 v2 的 model_validate 写"},
], user_id="demo-user")

# 查:user_id 要放进 filters
res = m.search("这个项目用哪个版本的 Pydantic", filters={"user_id": "demo-user"}, top_k=3)
for r in res["results"]:
    print(r["memory"])
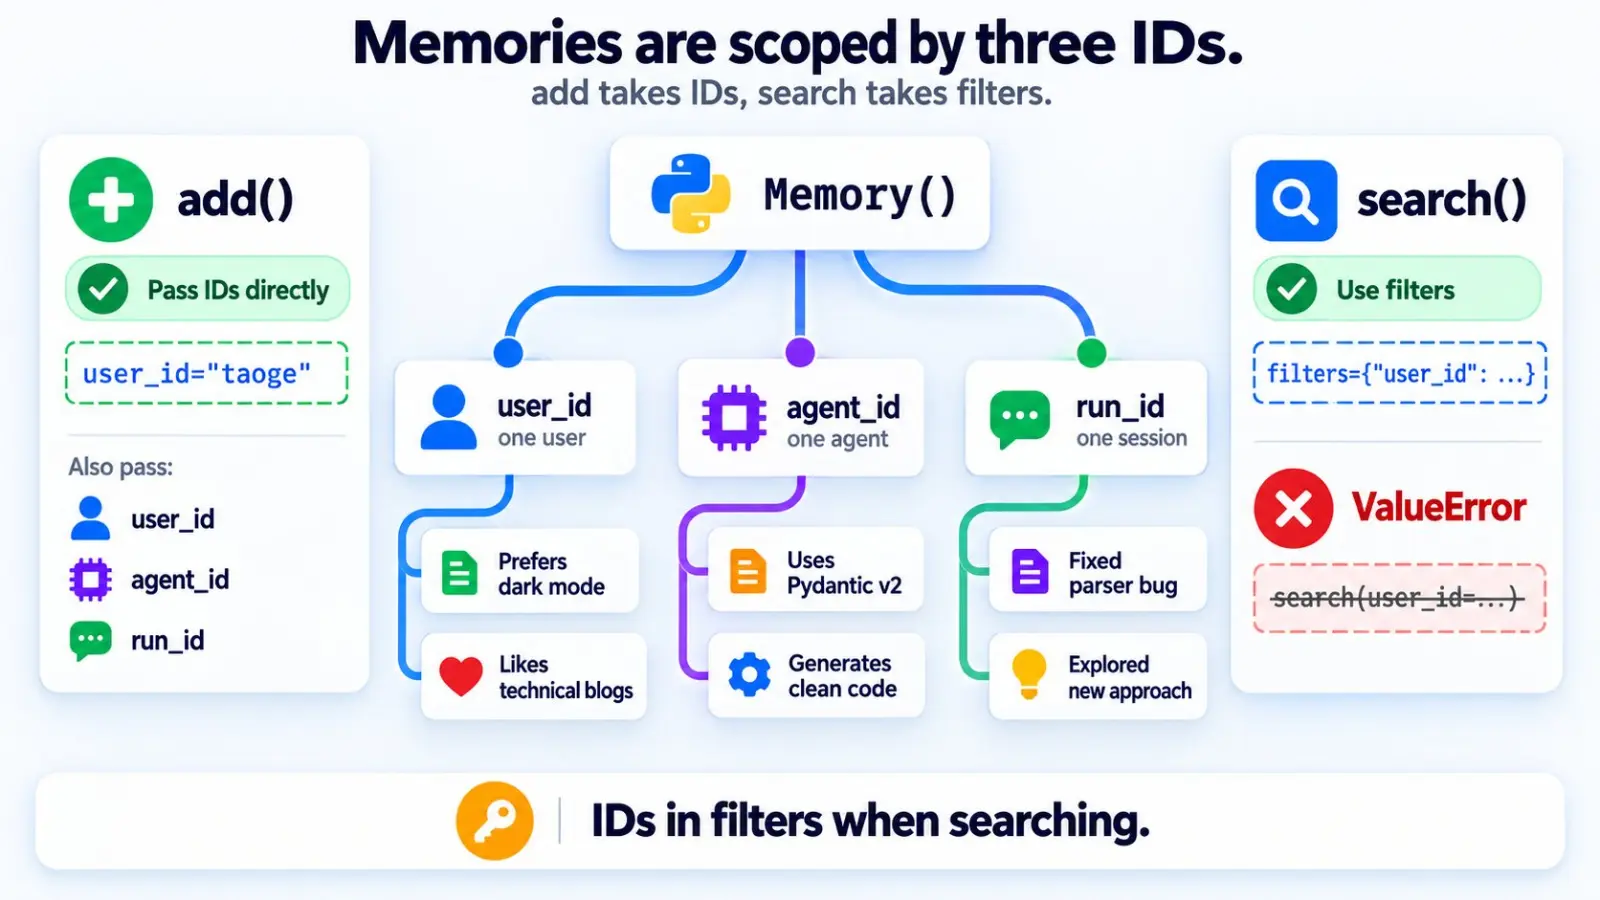
记忆按三个维度隔离:user_id 对应某个用户,agent_id 对应某个 Agent,run_id 对应某次会话。写法上有个地方容易踩:add 的时候这几个 ID 直接当参数传,但 search 和 get_all 必须包进 filters,直接传会抛出 ValueError。
升级到新算法的开源用户还要留意几个默认值的变化:top_k 从 100 降到 20,threshold 默认 0.1(低相关的结果会被直接筛掉),rerank 默认关闭,add 只会返回 ADD 事件。老代码里如果依赖 UPDATE、DELETE 事件,需要改。另外,外部图数据库(Neo4j 等)的集成已从开源版移除,图记忆现在是托管平台的内置能力。
Claude Code 里装成插件
这部分和写代码的人关系最大。Mem0 官方给 Claude Code 做了插件,装好后记忆会自动捕获、自动召回。官方文档(插件版本 0.3.1)的前提是:有 Mem0 平台账号和以 m0- 开头的 API key,Claude Code 版本要支持插件 agent 和相关 hook 事件,本机有 Python 3.10+ 和 Git。安装命令如下:
export MEM0_API_KEY='你的 key'
claude plugin marketplace add mem0ai/mem0
claude plugin install mem0@mem0-plugins --scope user --config api_key="$MEM0_API_KEY"
unset MEM0_API_KEY
装完重启 Claude Code,或者执行 /reload-plugins,然后进入一个 Git 仓库正常干活即可。更新和卸载用 claude plugin update mem0@mem0-plugins --scope user 和 claude plugin uninstall mem0@mem0-plugins。
它的工作方式分两头:
- 捕获:hook 在后台把你的消息、Claude 的回答、改动过的文件、测试和构建结果先记在本地,再由后台进程交给 Mem0 提取。
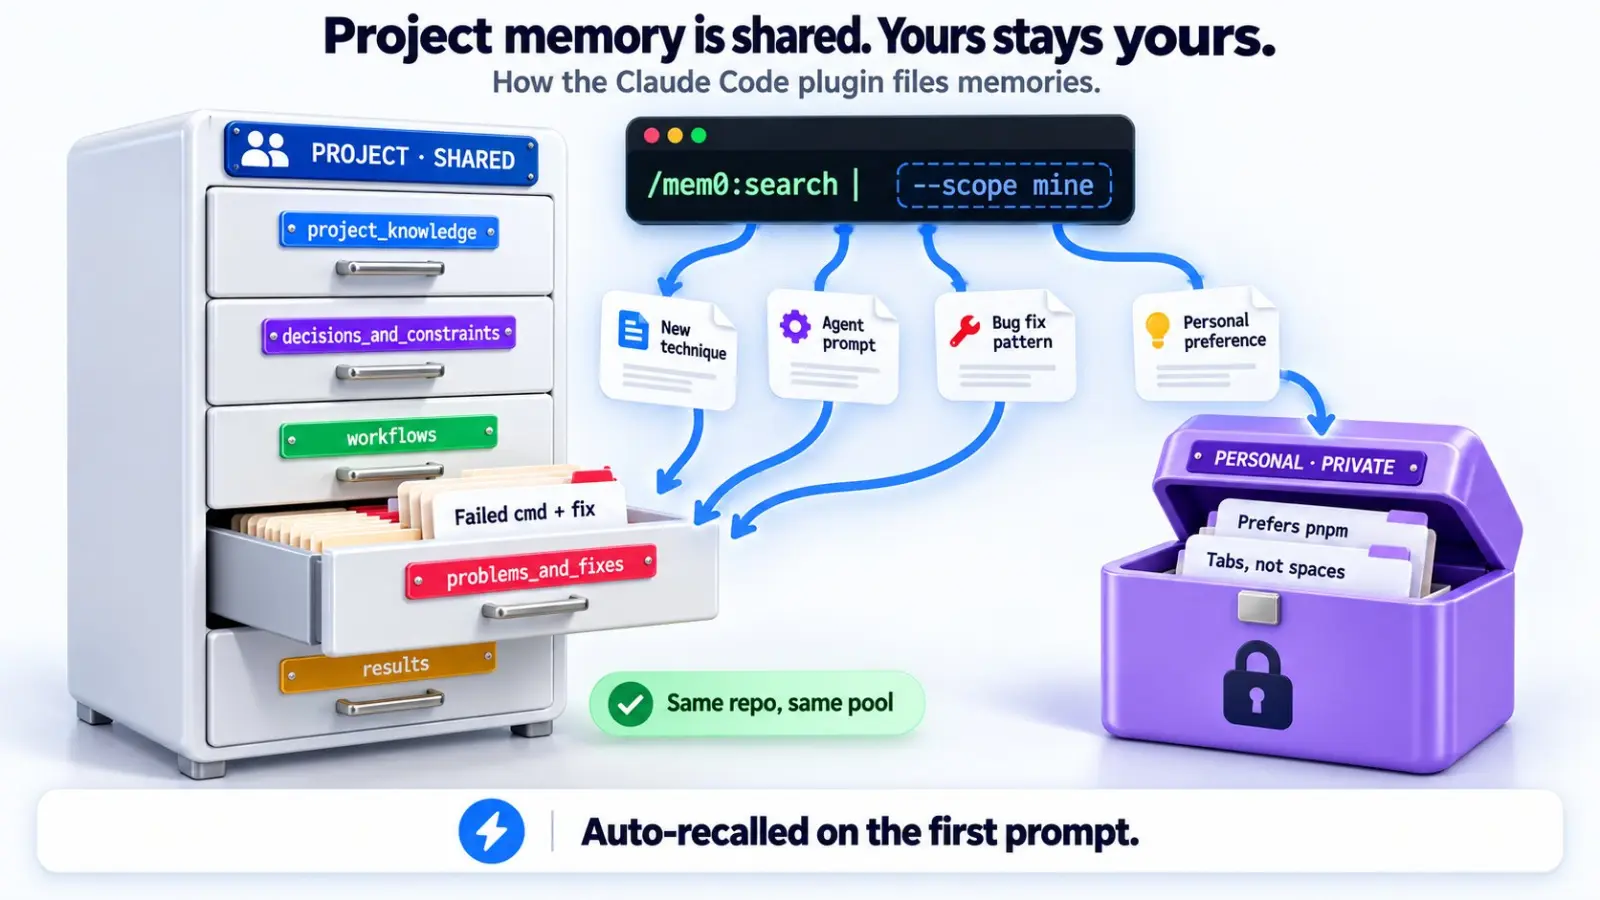
- 召回:新会话里,如果你的第一条提示不少于 20 个字符,插件会自动搜一次,最多注入 5 条相关记忆;之后想主动查,用 /mem0:search。
记忆分两类:项目记忆按仓库共享,存约定、决策、能跑的命令、踩过的坑和修法,同一个仓库的人读写同一个池子;个人偏好只归你自己。/mem0:search 支持这几个参数:
/mem0:search 上次解析器的报错是怎么修的? --category problems_and_fixes
/mem0:search 我习惯用 pnpm 还是 npm? --scope mine
category 可选 project_knowledge、decisions_and_constraints、workflows、problems_and_fixes、results;scope 可选 repo、dir、mine。显式搜索默认返回 3 条,输出总量默认限制在 4000 字符以内。其他命令包括:/mem0:status 看配置和 key 是否生效,/mem0:remember 让 Claude 在回复里记下某件事,/mem0:forget 删除你在这个仓库的记忆(项目共享记忆默认保留),/mem0:pause 和 /mem0:resume 暂停和恢复捕获。
装好后建议自己验证一次:告诉 Claude 记住一个临时的验收标记,结束会话,新开一个会话用 /mem0:search 问它,结果里能看到这个标记就说明链路通了。提取在后台跑,第一次搜空了就等一会儿再搜。
要注意的是,这个插件走的是云端,对话内容会上传到 Mem0。用在公司仓库之前,先想清楚代码和对话能不能出本地;不想上传的话,可以只用开源 SDK 自建,或者选本地方案,比如这篇讲的 claude-mem:claude-mem 安装与使用教程:给 Claude Code 加上跨会话记忆。
记忆和规则文件各管什么
插件记的是“过程里产生的东西”:踩过的坑、做过的决定、跑通的命令。而项目长期不变的规范,比如代码风格、目录约定、禁止项,更适合写进规则文件,让工具每次启动都读。以 Codex 为例,可以参考这篇:AGENTS.md,把项目规范写给 Codex,看懂并就近生效。两者配合着用:规则文件管“必须怎么做”,记忆层管“上次发生过什么”。
总结
Mem0 的思路说穿了很简单:写入时不替你拍板,每条事实带上绝对日期、挂上和旧记忆的关联,只加不改地存下来;查的时候再让语义、关键词、实体三路信号一起打分,把最相关的几条捞回来。
用起来也不重:Python 里 add 和 search 两个方法就能跑通,团队可以自己搭服务,Claude Code 用户装个插件就能让它记住项目。代价是插件走云端、会上传对话,开源版新算法也有一批默认值和接口变动要适配。如果你通过 AIGoCode 使用 Claude Code,这个插件与接入渠道无关,按上面的步骤配置即可。
参考链接
- Mem0 GitHub:https://github.com/mem0ai/mem0
- Claude Code 插件文档:https://docs.mem0.ai/integrations/claude-code
- 开源版迁移指南(新算法与默认值变化):https://docs.mem0.ai/migration/oss-v2-to-v3
- 更新日志与跑分说明:https://docs.mem0.ai/changelog/highlights