用过 Agent Skill 的人大多有这种体会:那份 SKILL.md 基本是写完就定死了。要么自己手写,要么让一个强模型一次性生成,好不好用全看第一版。想让它变好只能回头手改,改完也说不清是真的变好了还是感觉变好了。
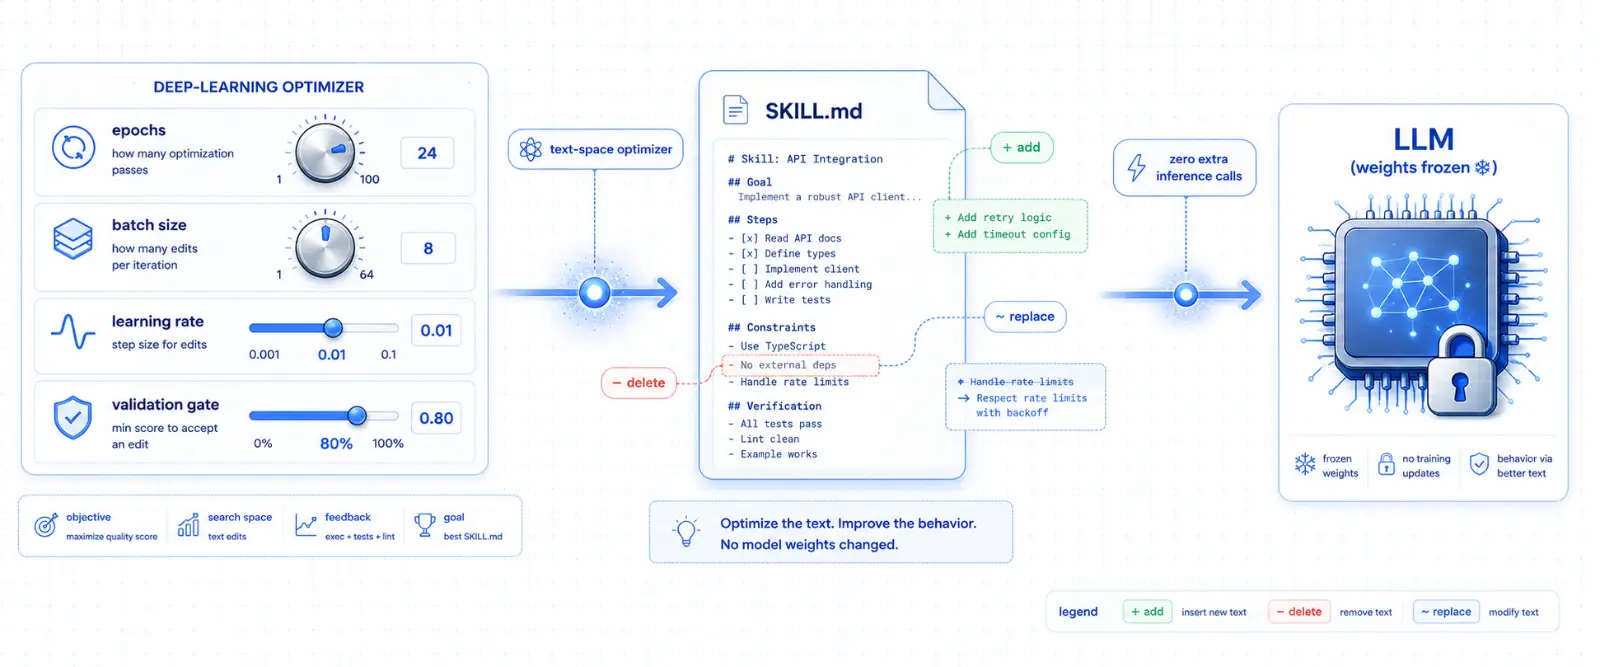
微软开源的 SkillOpt 想改变的就是这一点。它把训练神经网络的那套方法,包括 epoch、batch size、学习率和验证集门槛,搬到了纯文本的 Skill 文档上。模型权重一点不动,被“训练”的是 Skill 文件本身。
这篇适合经常给 Claude Code、Codex 写 Skill 或调 Prompt 的开发者,会讲 SkillOpt 的工作原理、论文给出的效果数据、安装和 WebUI 用法,以及新加入的 SkillOpt-Sleep。
SkillOpt 的思路:把 Skill 文档当成可训练参数
把训练模型的类比拆开看就很好理解:
- Skill 文档等于可训练参数:平时训练模型调的是权重,SkillOpt 把 SKILL.md 当作唯一的可训练状态,目标模型保持冻结,全程只修改这一份文档。
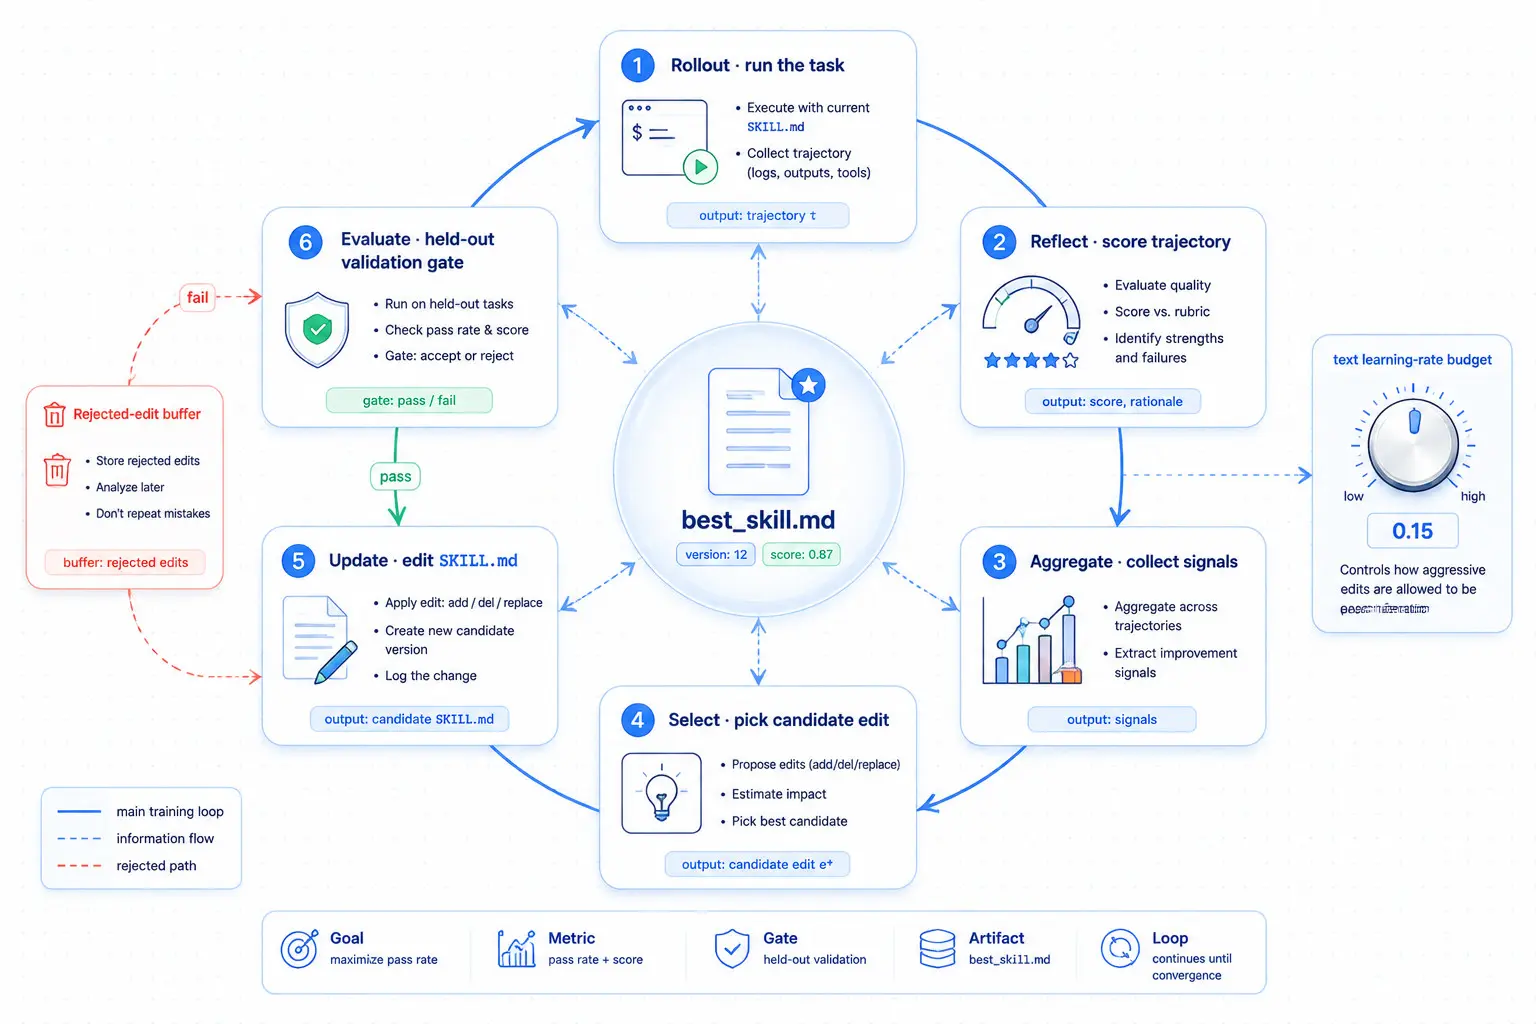
- 优化器是另一个模型:一个 optimizer 模型观察 Skill 在任务中的表现并打分,再把评分转化成对文档的具体编辑,比如增加、删除或替换一段。每次改动幅度有上限,不会一下子改掉一大片。
- 验证集门槛只接受真实进步:这是最关键的一步。候选改动只有在留出的验证集上分数确实提高,才会被采纳;没有提升的改动进入拒绝缓存,不会污染主文档。这样就避免了模型自我改写越改越偏的问题。
此外它还借鉴了文本学习率预算、按 epoch 进行的慢速更新和元更新等设计。完整的训练循环是:执行任务 → 反思 → 汇总 → 筛选 → 更新文档 → 评估,一轮接一轮。
如果你还没写过 Skill,可以先看 给 Codex 写第一个 Skill,把重复 Prompt 固化成工作流,有了第一版再考虑用 SkillOpt 去优化它。
SkillOpt 效果:论文里的数据
以下数据来自项目论文(arXiv:2605.23904),未经本文实测:
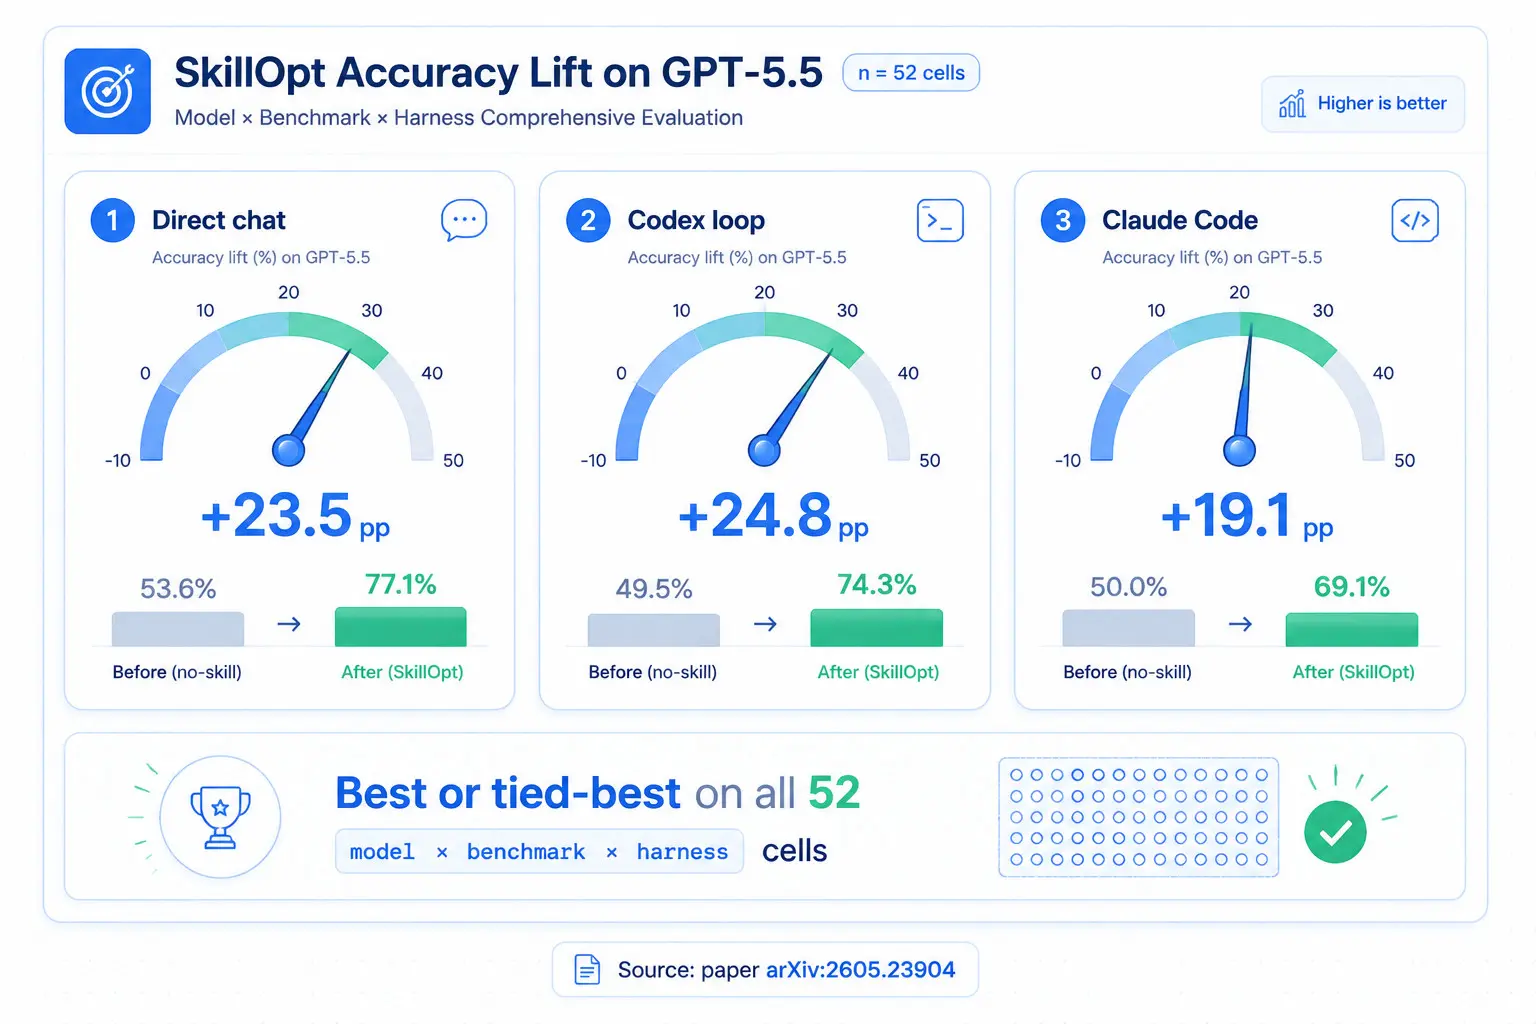
- 在 6 个基准、7 个目标模型、3 种执行环境(直接对话、Codex CLI、Claude Code CLI)组成的 52 个评测格子里,SkillOpt 全部取得最好或并列最好的成绩。
- 以 GPT-5.5 为目标模型,与不提供 Skill 的基线相比,平均准确率在直接对话中提升 23.5 分,在 Codex agentic loop 中提升 24.8 分,在 Claude Code 中提升 19.1 分。
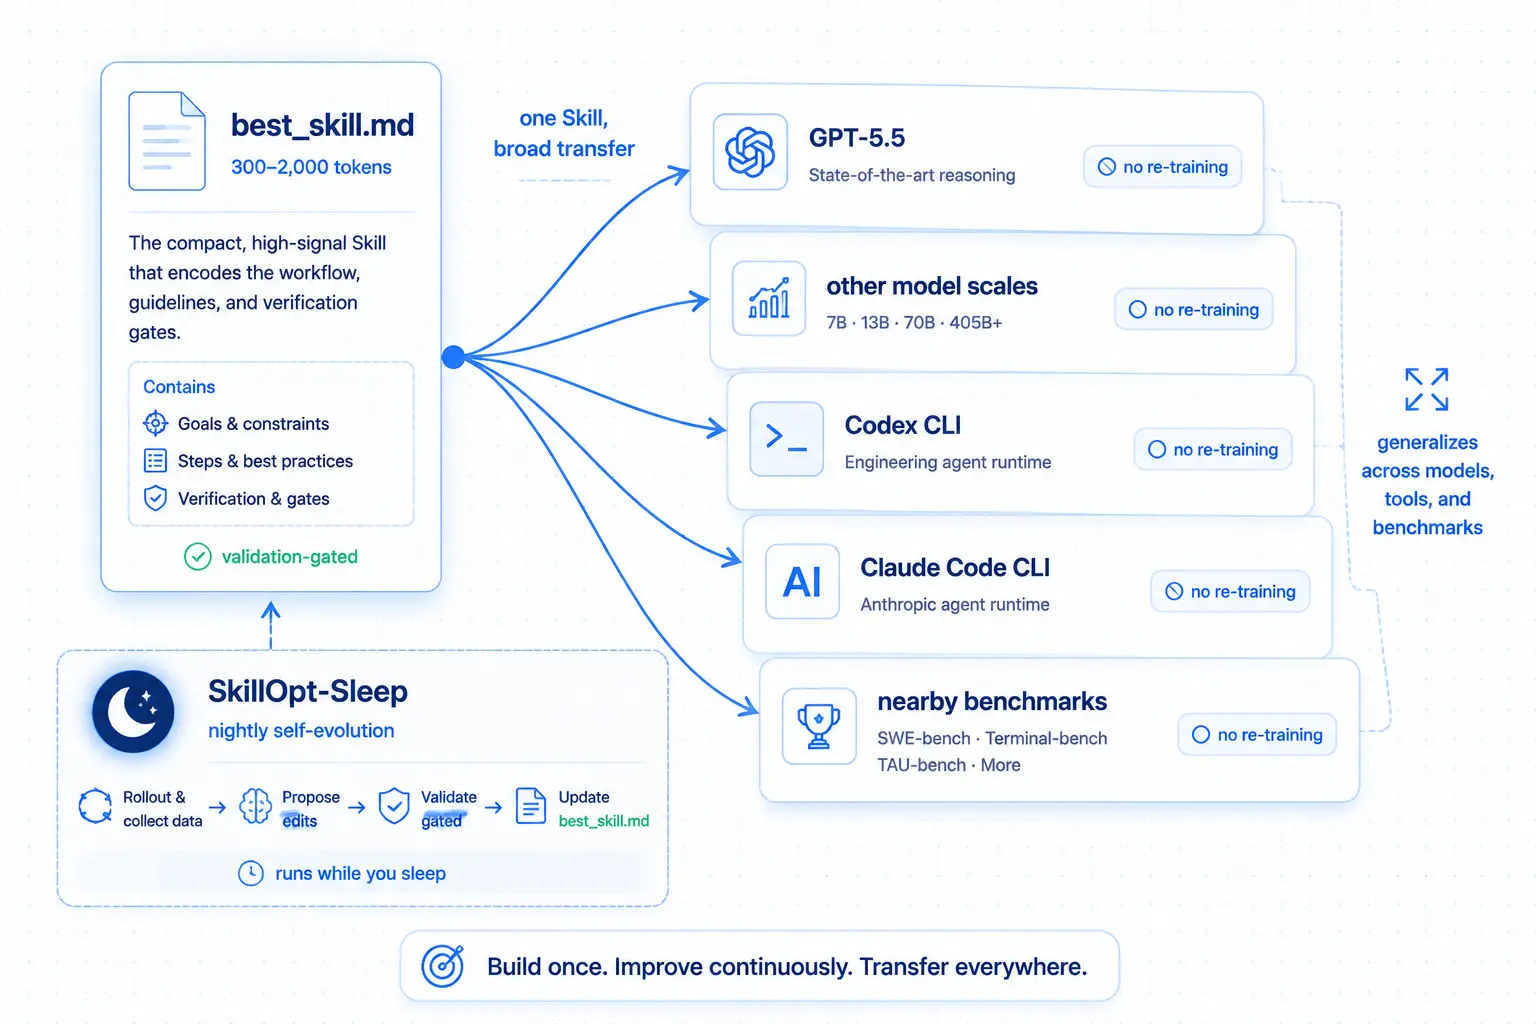
更有价值的是迁移性。论文显示,训练出来的 Skill 可以跨模型规模迁移,可以在 Codex 和 Claude Code 两种环境之间通用,也能迁移到相近的基准上,不必重新训练。
最终部署的产物是一个 best_skill.md,通常几百到两千 token,直接交给未改动的目标模型使用,部署时不增加额外的推理调用。
SkillOpt 安装与上手
SkillOpt 已发布到 PyPI(截至 2026 年 10 月最新版本为 v0.2.0),要求 Python 3.10 及以上:
pip install skillopt
后端支持比较全:聊天后端有 OpenAI、Azure、Claude、Qwen、MiniMax,执行后端可以接 Codex CLI 和 Claude Code CLI。兼容 OpenAI 接口的服务,README 建议先试内置的 openai_compatible 后端,不行再自己加代码。
想接入自己的后端或基准,仓库的 docs/guide 下有对应指南,可以照着 qwen 或 searchqa 的模板改。
想实时观察训练过程,可以在仓库目录里安装并启动 WebUI 面板:
pip install -e ".[webui]"
python -m skillopt_webui.app
SkillOpt-Sleep:夜间离线进化
v0.2.0 的主要新功能是 SkillOpt-Sleep,以 skillopt-sleep 命令行工具的形式提供。它是一个夜间离线的自我进化引擎:在你不用电脑的时候回顾过去的会话、挖掘高频任务并重放,再把通过验证门槛的 Skill 固化下来。
它面向本地编程 Agent(Claude Code、Codex、Copilot 等)。需要注意的是,README 说明 Claude Code、Codex、Copilot、Devin 的集成插件和 MCP 文件放在仓库源码里,不在 PyPI 的安装包中,要用这些集成需要从仓库获取。
限制与注意事项
- 数据来自论文:上面的提升幅度是论文在特定基准上的结果,换到你自己的任务上效果要自己验证。
- 需要验证集:验证门槛是 SkillOpt 的核心,没有一组能打分的任务和留出数据,就发挥不了它的优势。
- 训练有成本:优化过程要反复调用目标模型和 optimizer 模型,正式跑之前先估算 token 用量。
- 实验功能默认保守:v0.2.0 的一些多目标、重放等实验选项没有全部暴露成 CLI 参数,主命令行保持保守默认值。
总结
SkillOpt 的价值不在于又一个让 AI 自己改 Prompt 的工具,而在于把这件事做得像一个正经的优化器:有验证门槛、有学习率、有拒绝缓存,只接受经过验证的进步。即使不直接使用,“把 Skill 文档当参数训练、每一步都过验证”这个思路,也值得经常写 Skill 的人借鉴。想找现成的工程流程 Skill 作为起点,可以参考 agent-skills:Addy Osmani 给 AI 编程 Agent 写的 25 个工程流程 Skill。
如果你在 AIGoCode 上使用 Claude Code 或 Codex,可以拿自己最常用的一份 Skill 做个小实验,看看迭代后的效果。