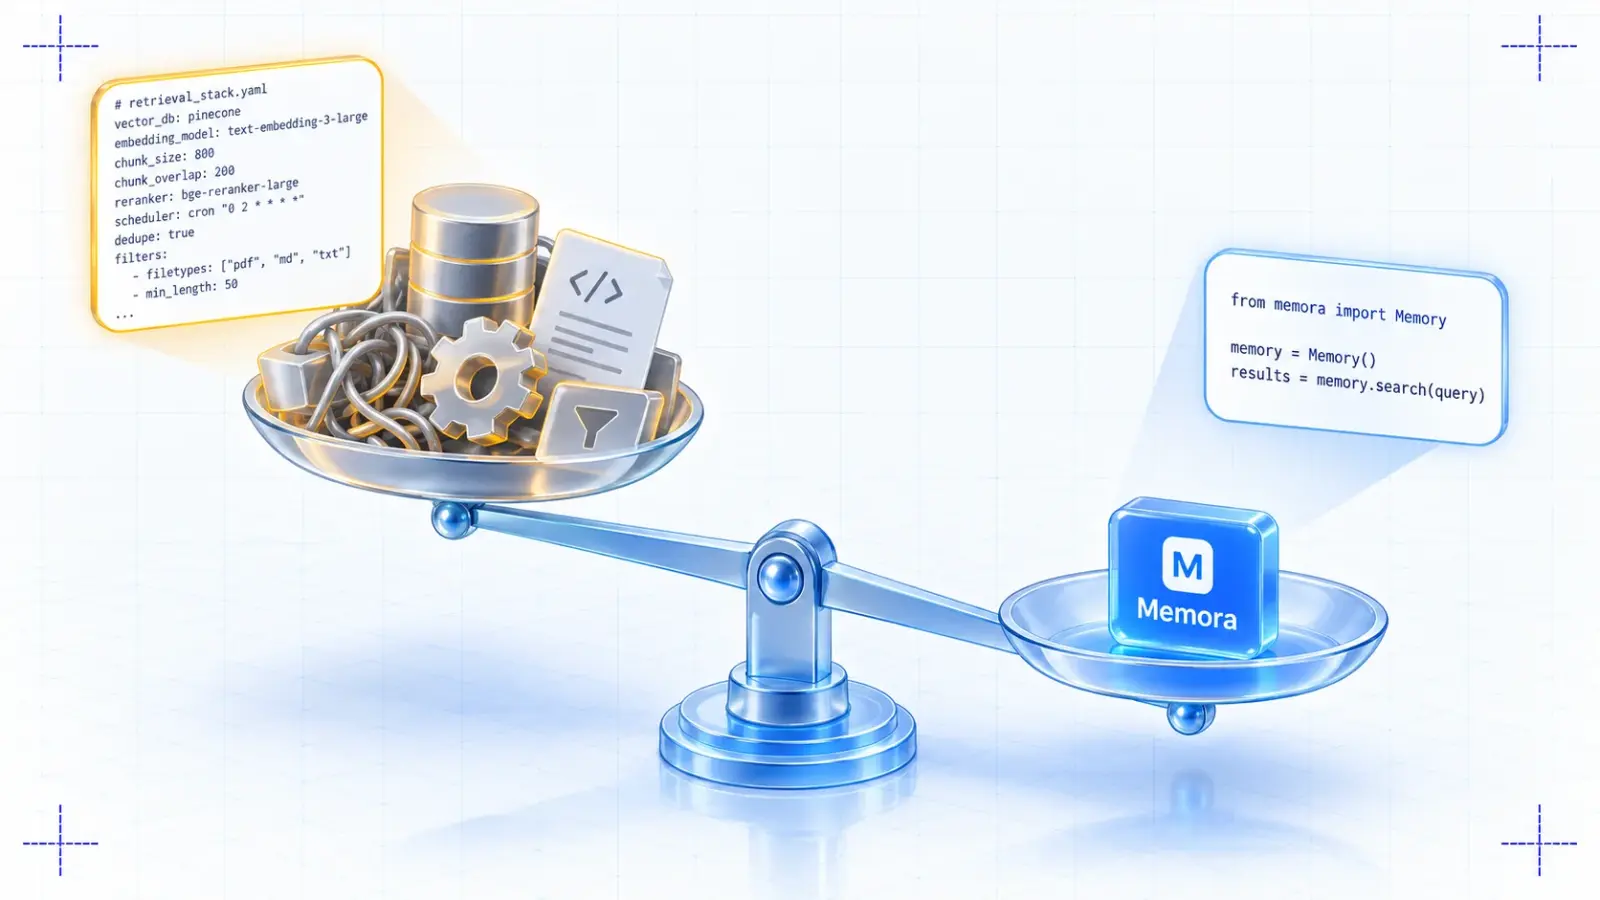
给自己的 AI 产品加记忆,很多人的第一步是上一个向量数据库。接下来就停不下来了:写分块策略、选 embedding 模型、调 top-k、处理重复内容,还要手写一套逻辑,判断用户上个月说的话这个月还算不算数。两周过去,做的全是基础设施,产品本身一行没动。
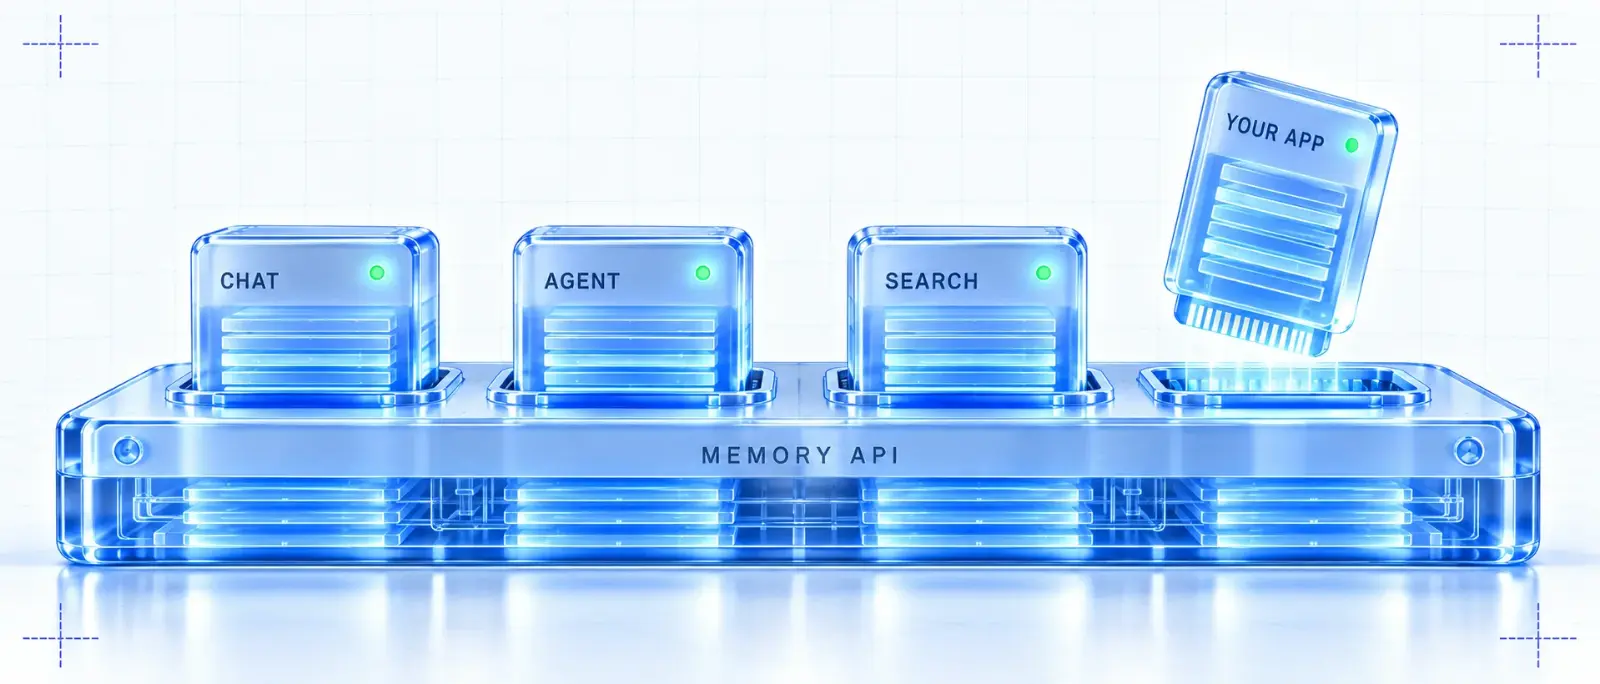
supermemory 把这一层打包成了一套 API。它用 TypeScript 编写,MIT 协议,到 2026 年 11 月 GitHub star 超过 3 万。存记忆、取记忆、拿用户画像都有现成的方法,不用自己碰向量库和 embedding 管线,也可以整套部署在自己的机器上。
这篇适合正在给 AI 应用或 Agent 做记忆层的开发者。下面讲 supermemory 的核心用法、记忆和 RAG 的区别、用户画像怎么用、本地部署怎么做,以及选型前要注意的地方。
supermemory 的核心用法:装包和三个方法
先装 SDK,Node 和 Python 都有:
npm install supermemory
pip install supermemory
存一条记忆:
await client.add({
  content: "User loves TypeScript and prefers functional patterns",
  containerTag: "user_123",
});
取的时候一次拿回两样东西,用户画像和相关记忆:
const { profile, searchResults } = await client.profile({
  containerTag: "user_123",
  q: "What programming style does the user prefer?",
});
containerTag 是记忆的隔离单位,可以按用户、按项目、按客户划分,彼此不会串。需要单独检索时还有 client.search(),默认是混合模式:一次查询同时查知识库里的文档和这个用户的个人记忆,结果合并返回。比如问「怎么部署」,它既能给出部署文档,也能带上这个用户以前的部署偏好。
框架这边也有现成的封装。按官方 README,Vercel AI SDK、LangChain、LangGraph、OpenAI Agents SDK、Mastra、Agno、n8n 等都有对应的接入方式。
记忆和 RAG 有什么区别
这是选型时最该想清楚的一点。
RAG 是无状态的:问一个问题,它去文档里找相关的段落,不管谁来问,结果都一样。它检索的是知识。
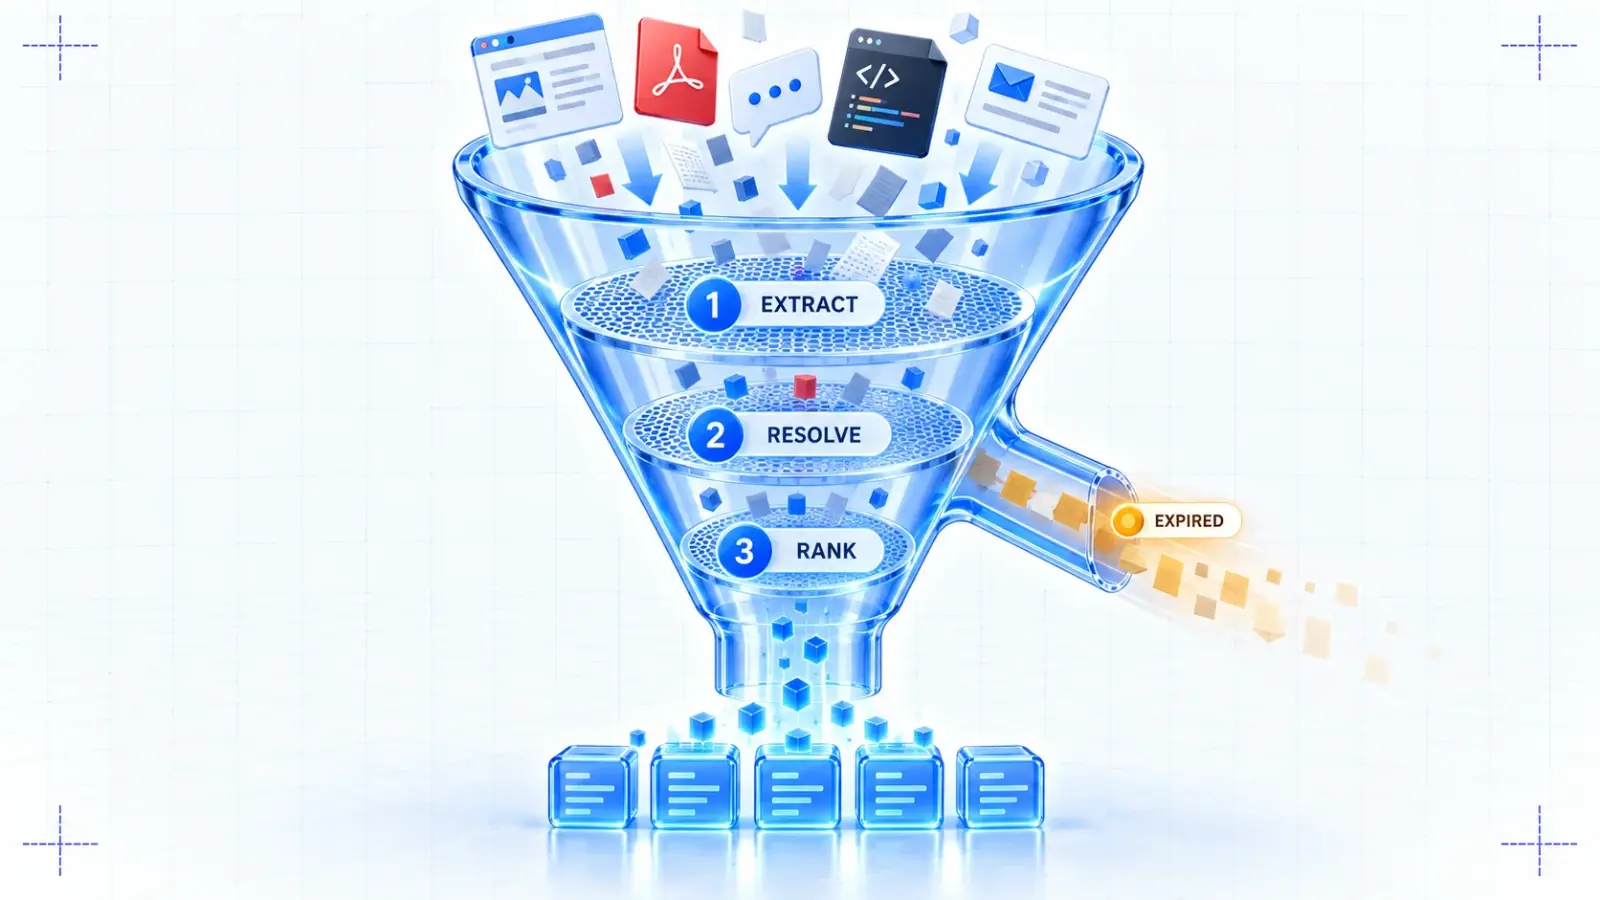
记忆检索的是关于「这个人」的事实,而且这些事实会变。用户三个月前说「我住在纽约」,上周说「我刚搬到旧金山」,两句话互相冲突,后一句应该覆盖前一句。普通向量库做不了这个判断,只会把两条都找出来,让模型自己纠结。
supermemory 的引擎专门处理这类问题:从对话里抽取事实,跟踪事实的变化,遇到矛盾时做消解。它还支持自动遗忘,像「我明天要考试」这种天生带有效期的信息,过了时间就会失效,不会一直留在库里污染上下文。
如果你只是想给 Claude Code 这类编程工具加跨会话记忆,而不是做自己的 AI 产品,也可以看看 claude-mem 的安装与使用;想了解 Agent 记忆分层的另一种思路,可以参考 Hindsight 的 retain、recall、reflect 用法。
用户画像:不用先想好该检索什么
传统记忆方案有个隐藏门槛:你得先知道该检索什么,才能检索到。
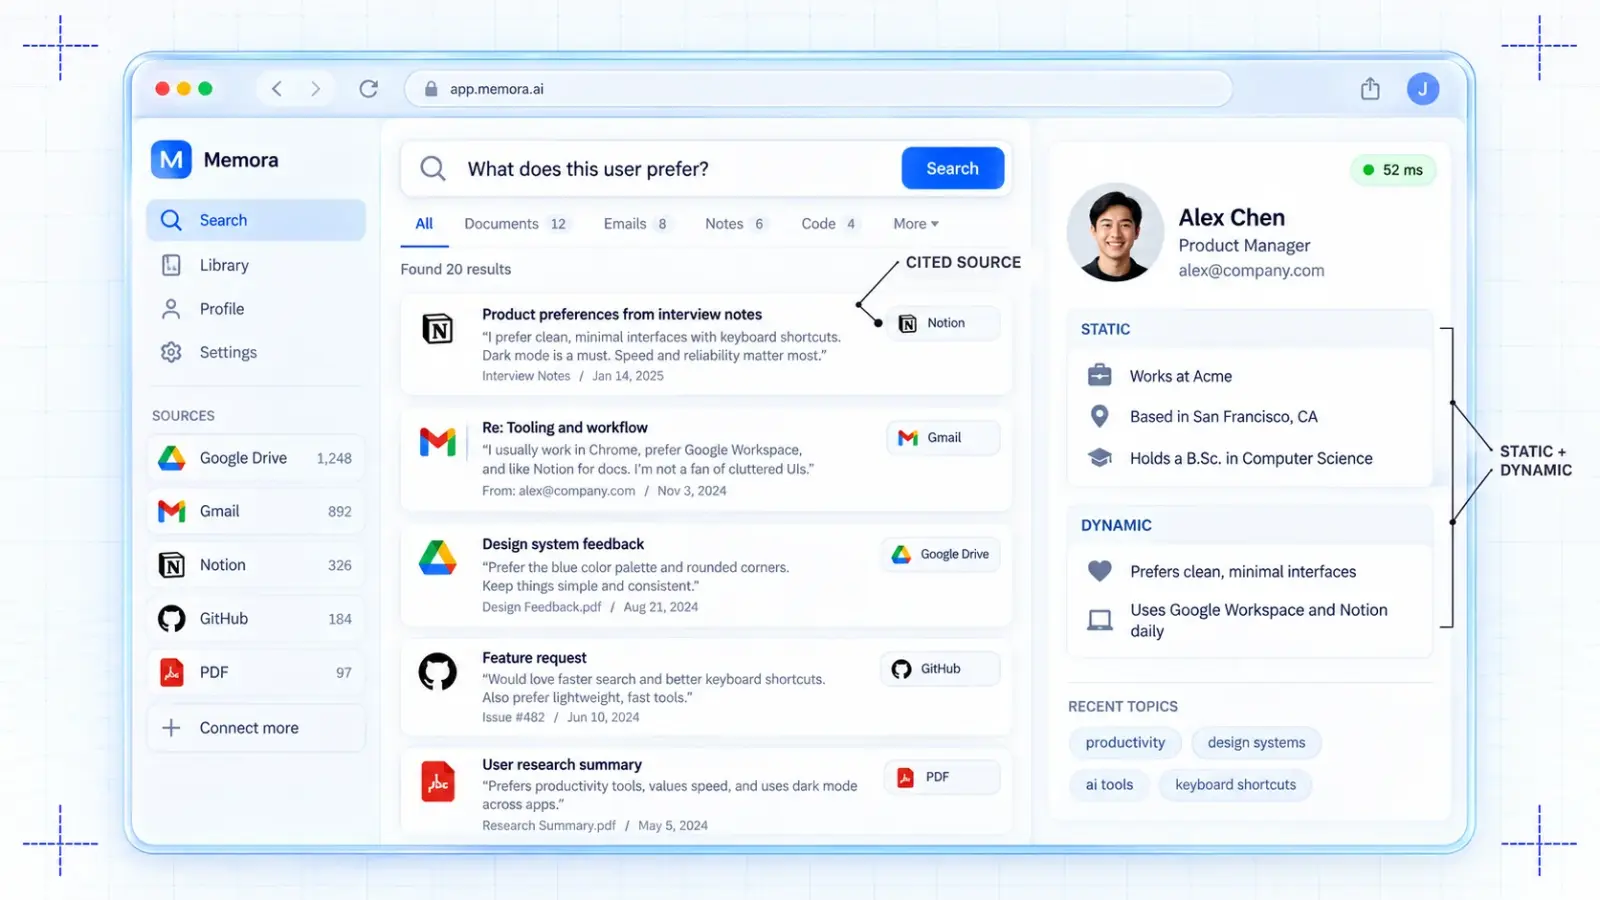
supermemory 会为每个用户自动维护一份画像,分两层:static 是长期事实,比如「Acme 的资深工程师」「偏好深色模式」「用 Vim」;dynamic 是近期在忙的事,比如「正在做认证迁移」「在排查限流问题」。
一次调用就能拿到,官方给出的耗时约 50 毫秒。拿到之后直接拼进 system prompt,Agent 开口之前就知道自己在和谁说话。这个设计省掉的是「该检索什么」这一步决策,对做产品的人来说,比召回率多几个百分点更实用。
supermemory 本地部署:数据留在自己机器上
很多记忆服务只提供云端 API,数据必须出门。supermemory 有本地版本,README 给了两种安装方式:官网的一键安装脚本,或者直接用 npx:
npx supermemory local
用安装脚本装好后,运行 supermemory-server 启动服务。第一次启动会自动配置内置的图引擎、本地 embedding 和凭据,然后打印一个 API Key,完整的 Memory API(文档、记忆、用户画像、混合搜索)运行在 localhost:6767 上。
客户端只需要改一个字段:
const client = new Supermemory({
  apiKey: "sm_...",
  baseURL: "http://localhost:6767",
});
本地版的几个要点:
- 模型可以自己选。 支持 OpenAI、Anthropic、Gemini、Groq,或者任何 OpenAI 兼容端点,首次启动有交互式向导。
- embedding 默认在本地跑。 默认用本地的
Xenova/bge-base-en-v1.5,不需要 Key;也可以换成 OpenAI、Gemini 或 Ollama。 - 可以做到文本记忆离线。 模型接 Ollama、设置
SUPERMEMORY_DISABLE_TELEMETRY=1关闭遥测后,本地文本和文件输入可以离线使用(首次需要下载 embedding 模型);URL 内容抓取仍然依赖托管的读取服务。 - 数据集中在一个目录。 所有内容都在
~/.supermemory里,备份和迁移就是拷贝这个文件夹。 - 和云端是同一套 API。 本地原型跑通后,上线只需要改
baseURL。
官方也提供了 Docker 镜像(支持 Linux amd64 和 arm64),API 同样监听 6767 端口,本地请求也必须带 API Key。
如果只是想给手上的 Claude Code、Cursor、Codex 加记忆,不用碰 API:官方提供了这几个工具的插件,也有 MCP server 可以直接连接。
选型前要注意的地方
- 这是有商业产品的开源项目。 仓库是 MIT 协议,同时有托管平台和企业版。本地版功能够用,但和企业版不完全对等,长期重度使用前最好先对比一下差异。
- 它是一整套上下文系统。 记忆、RAG、数据连接器、文件处理捆在一起,好处是省事,代价是绑定。如果只需要一个纯向量检索,这套东西偏重。
- 评测成绩看看就好。 官方称在 LongMemEval、LoCoMo、ConvoMem 三个记忆评测上排名第一,这类数据可以参考,但真正决定用不用的,是接入成本和你自己的业务数据表现。
总结
supermemory 的价值在于把记忆层做成了现成的 API:装包、调用 add 和 profile、用 containerTag 隔离用户,事实更新、矛盾消解和过期遗忘交给它处理,需要时还能整套部署到本地。如果你已经在分块和 top-k 上耗了好几天,可以先在本地起一个试试,不用 Key、不用向量库,半小时左右就能判断合不合用。
想在 AIGoCode 上用 Claude Code 或 Codex 来写这类记忆接入代码,可以先看 AIGoCode 使用指南 完成接入。
参考来源
- supermemory GitHub 仓库:https://github.com/supermemoryai/supermemory
- 官方文档:https://supermemory.ai/docs
- 本地部署文档:https://supermemory.ai/docs/self-hosting/overview