在本地跑大模型,最卡脖子的是显存。一张 12 GB 或 16 GB 的游戏显卡,通常只能装下 7B、14B 这一档模型,聊天还行,真用来写代码、跑 Agent 就不够用。参数上百亿的大模型,按常规做法需要几百 GB 显存的服务器;退回去用 API,Claude Code 跑一下午,token 账单又不低。
Strata 试图把这两头接起来:它把 Qwen3.8-Flash-Next 这个 125B 参数的模型搬到普通游戏电脑上运行,支持 NVIDIA 或 AMD 显卡,12 GB 显存起步,Windows 和 Linux 都能安装。运行后会在本机提供 OpenAI 和 Anthropic 兼容接口,Claude Code、Codex 改一下地址就能接入,数据不离开本机。
这篇文章适合有一张 12 GB 以上显卡、想给 Claude Code 或 Codex 配一个本地模型后端的开发者。下面依次说明 Strata 的工作原理、项目公布的性能数据、硬件要求与安装步骤,以及接入 Claude Code 和 Codex 的配置方法。
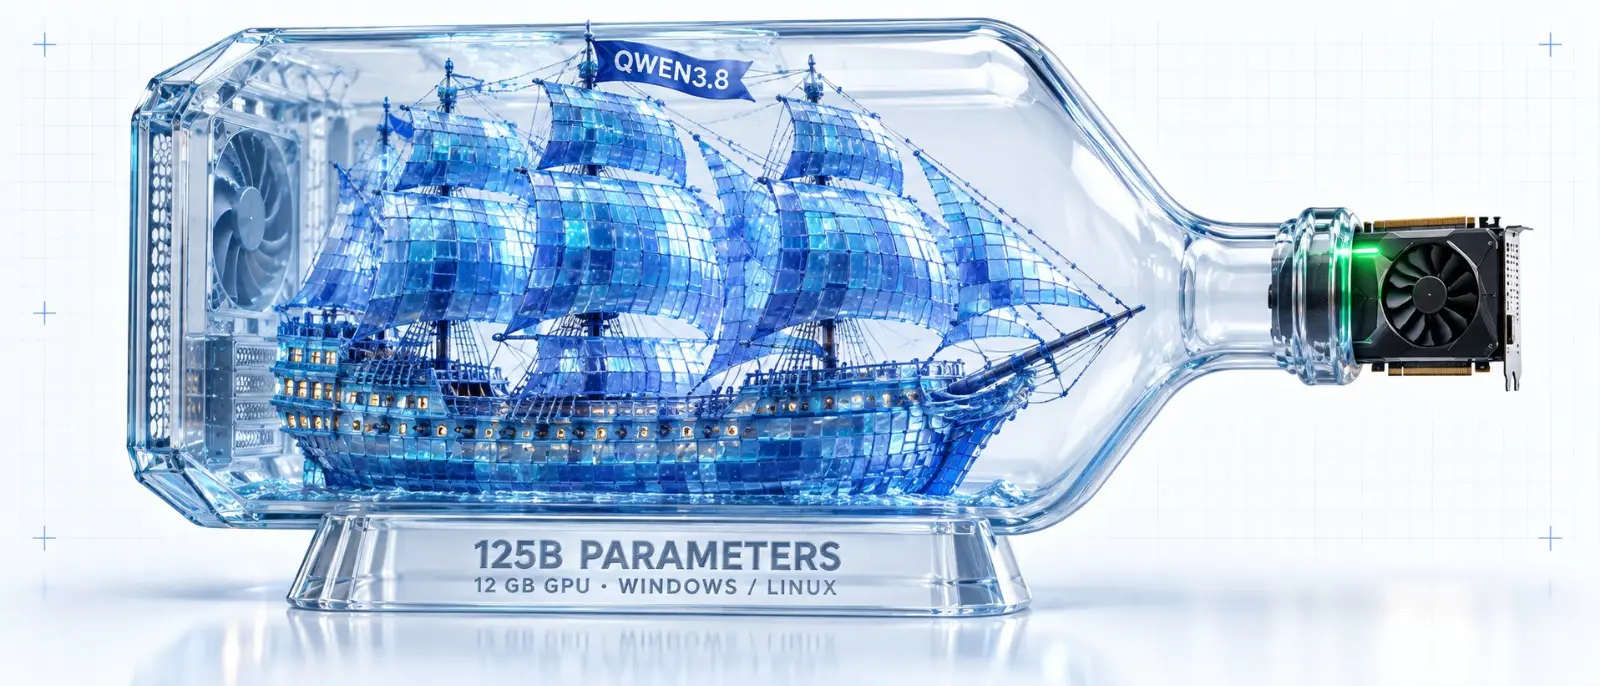
12G 显存如何运行 125B 模型
MoE 模型的专家调度
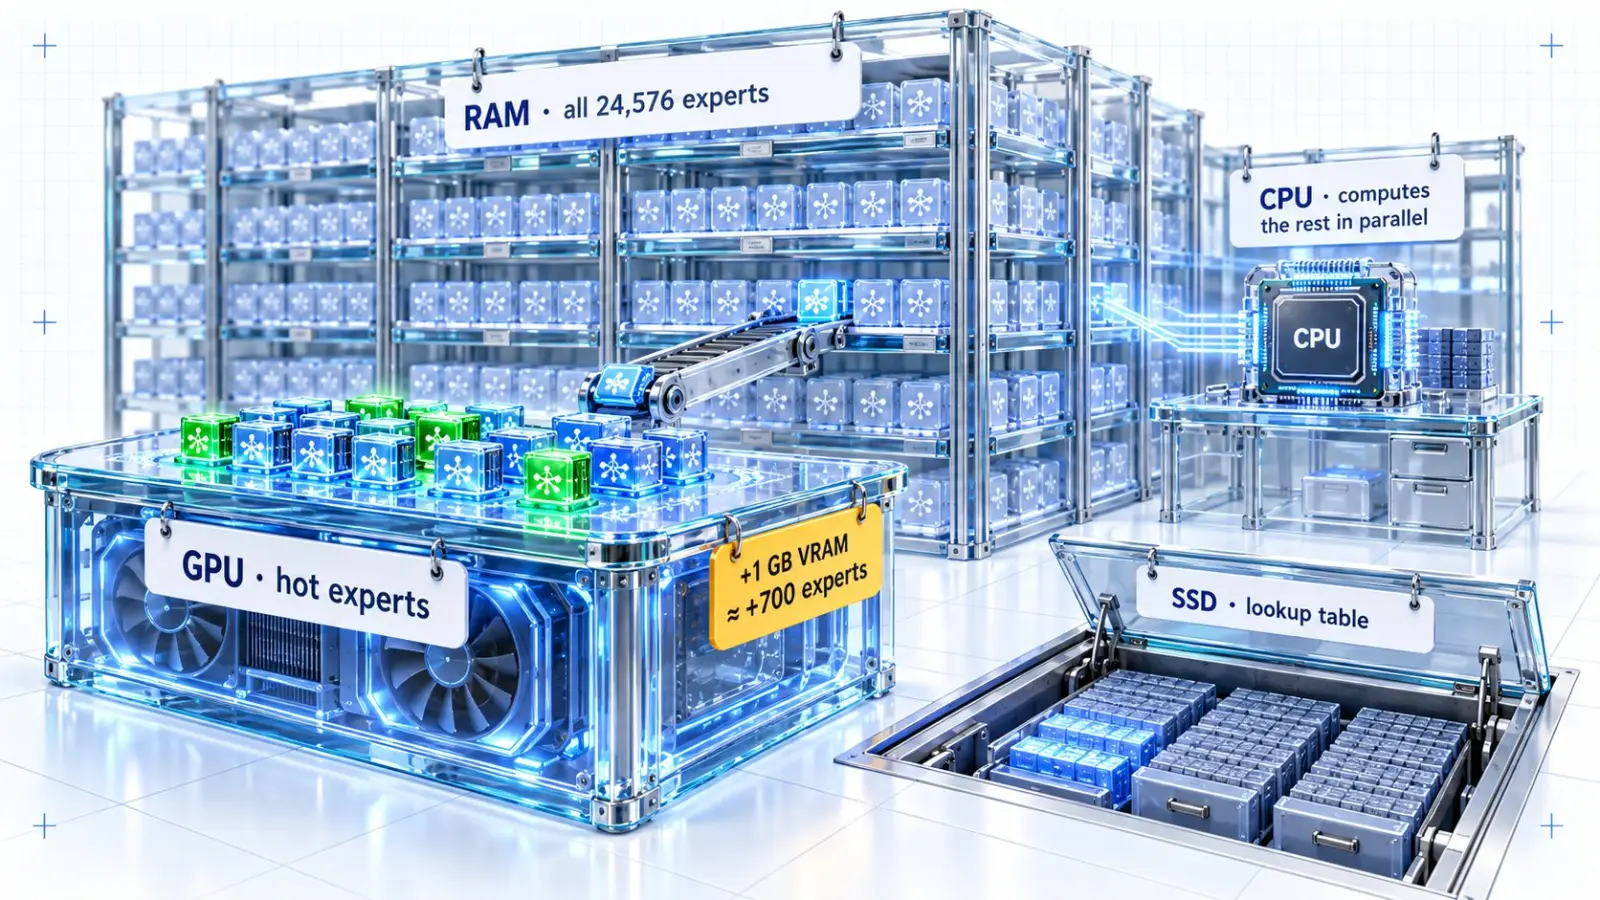
能装下的前提是:这是一个 MoE(混合专家)模型。整个模型拆成 24,576 个小专家,每生成一个词只用到其中 10 个,不需要把所有专家都放进显卡。
Strata 做的事情,是给这些专家安排位置:
- 显存放最常用的部分:每个词都要计算的公共部分,加上被调用最多的几千个专家,常驻显存。Strata 会在对话过程中统计调用频率,把近期调用多的专家挪到显卡上。
- 内存放全部专家:24,576 个专家在内存里各有一份。某个词需要的专家不在显卡上时,由 CPU 直接在内存中计算,与显卡同时进行,互不等待。
- SSD 放查找表:SSD 上有一张二十多 GB 的查找表,每个词只读取其中几行,占用带宽很少。
因此,对 Strata 来说显存容量比显卡算力更重要。显存每多 1 GB,大约能多放 700 个专家,CPU 就少算 700 个。
推测解码加速
模型内置一个小型草稿层,一次先猜出后面几个词,再由大模型一次性验证这些猜测:猜对的保留,猜错的由大模型重写。每个词最终都由大模型确定,输出结果与不使用推测时完全一致,速度可提升 1.6 到 1.8 倍。
性能数据:项目公布的测试结果
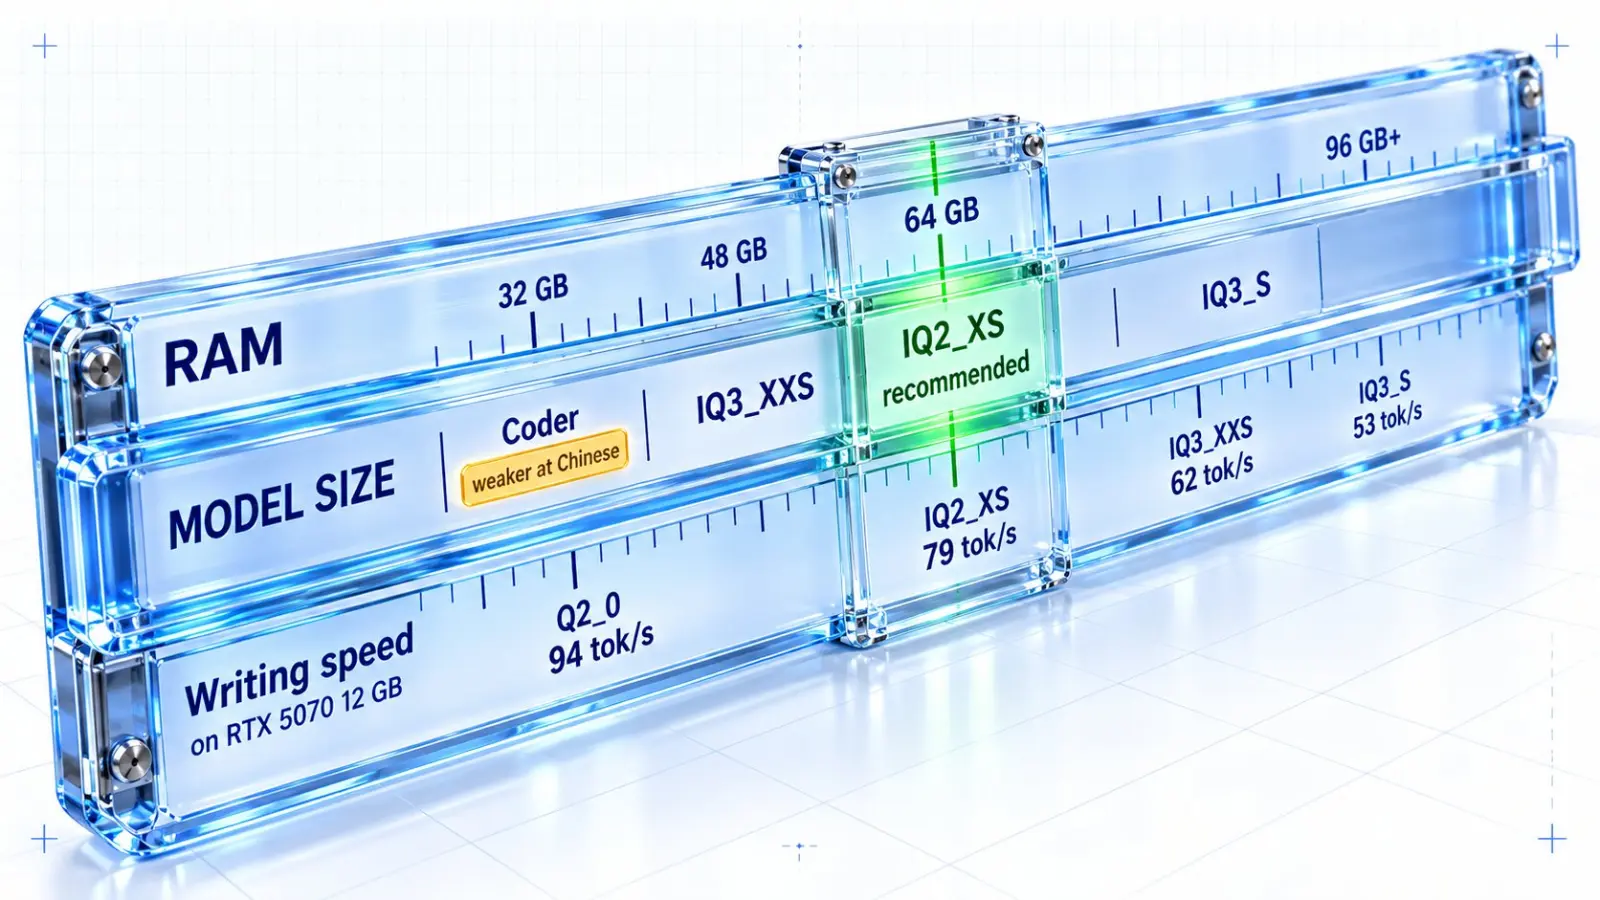
以下数据来自项目 README,测试条件为 4K 输出、32K 输入(单位:token/秒),本文未实测:
| 量化档位 | RTX 5070 12G 生成 | RTX 5070 12G 读取 | RX 9070 XT 16G 生成 | RX 9070 XT 16G 读取 |
|---|---|---|---|---|
| Q2_0 | 94 | 2,650 | 60 | 1,160 |
| IQ2_XS | 79 | 2,090 | 52 | 1,110 |
| IQ3_XXS | 62 | 1,750 | — | — |
| IQ3_S | 53 | 1,620 | — | — |
| Coder | 55 | 2,180 | 44 | 1,420 |
RTX 5070 测试机配 64 GB 内存。每秒 60 个 token 已经快于人的阅读速度。
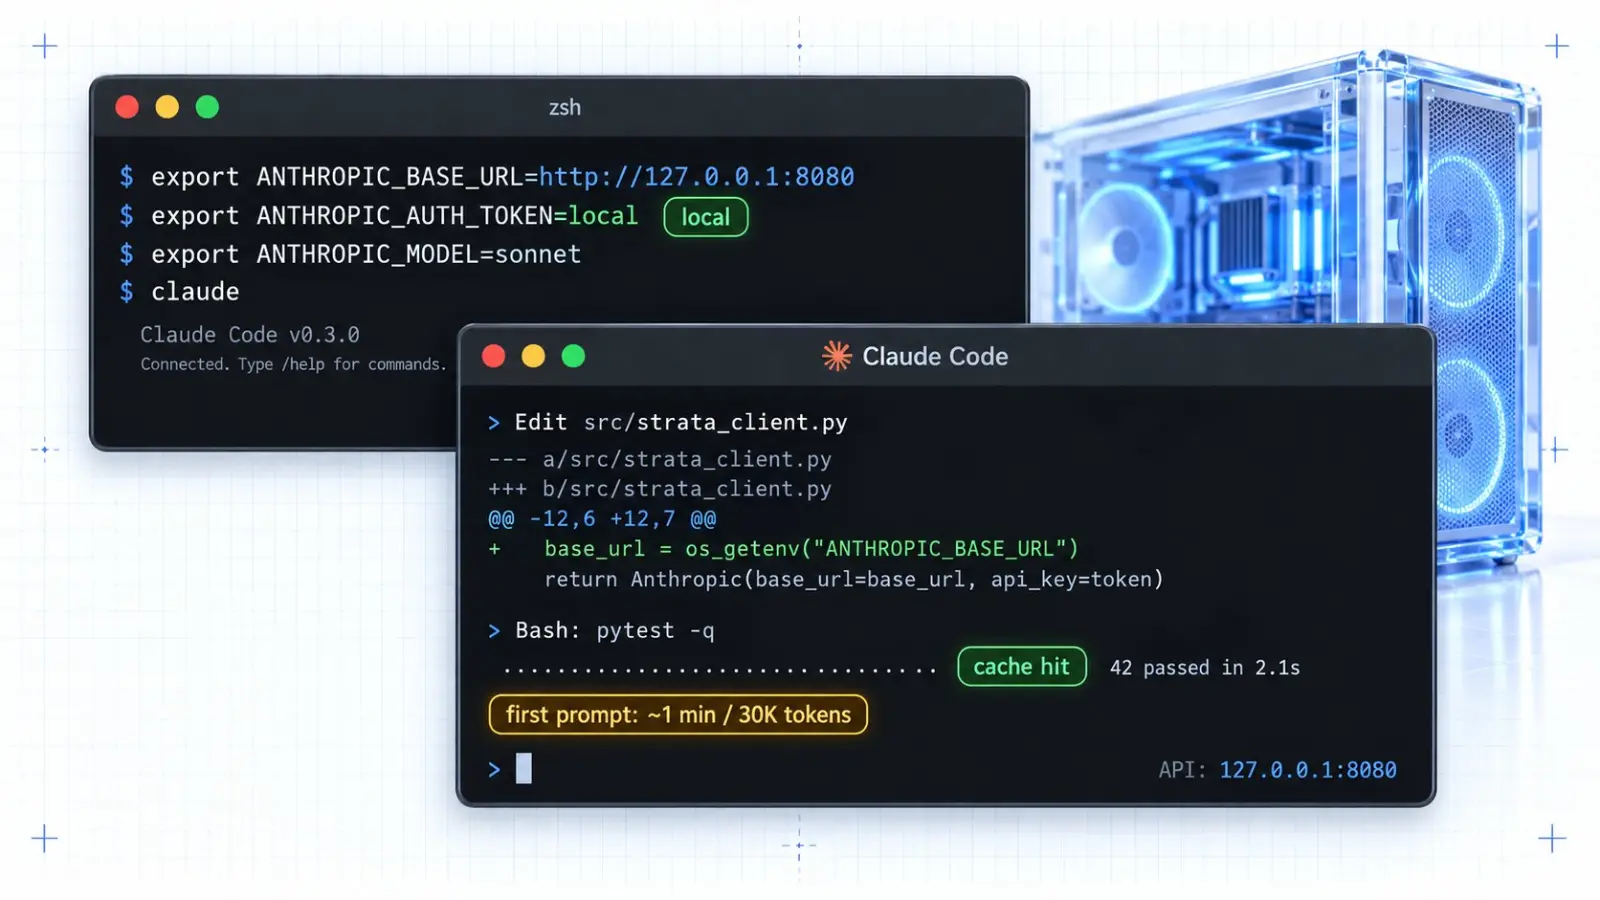
需要注意的是第一条消息:长 prompt 第一次需要完整读入,大约每 3 万 token 需要一分钟。之后 Strata 会缓存对话,只读取新增部分,后续回复几秒内就开始输出。Agent 类用法系统提示词很长、一轮轮往下进行,正好能利用这个缓存。
硬件要求与安装步骤
硬件要求
| 项目 | 要求 |
|---|---|
| 显卡 | NVIDIA GeForce RTX 20/30/40/50 系列;或 AMD Radeon RX 6800/6900、7700 XT/7800 XT、7900 XT/XTX、9060 XT、9070/9070 XT、AI PRO R9700 |
| 显存 | 12 GB 起 |
| 内存 | 32 GB 起,64 GB 可运行所有档位 |
| 硬盘 | 约 80 GB 可用空间,推荐 SSD |
| 系统 | Windows 10/11 或 Linux,驱动保持最新 |
Apple Silicon Mac、Intel Arc 等平台目前为实验性支持。
方式一:让 Claude Code 或 Codex 自动安装
把下面这句话直接交给 Claude Code 或 Codex:
Set up Strata on this PC for me: https://github.com/Niko1221/Strata - follow docs/AI_SETUP.md in that repository.
它会检查显卡、内存和硬盘,选择合适的档位,完成安装和启动,并告诉你如何接入。
方式二:手动安装
下载仓库后,Windows 双击 START-HERE.bat;Linux 执行:
git clone https://github.com/Niko1221/Strata.git
cd Strata
./setup.sh
安装器会询问使用哪个档位、上下文开多大、是否启用识图,一路回车即为推荐配置。随后下载约 70 GB 的模型文件,中断后重新运行会继续下载。安装完成后浏览器会自动打开 http://127.0.0.1:8080,包含聊天页面和实时查看 GPU、CPU、内存占用的 Monitor 页面。
按内存选择量化档位
| 内存 | 推荐档位 |
|---|---|
| 32 GB | Coder |
| 48 GB | IQ2_XS(或最快的 Q2_0) |
| 64 GB | IQ2_XS(推荐),或 IQ3_XXS / IQ3_S |
| 96 GB 及以上 | IQ3_S |
Coder 档位是砍掉一半专家的编程专用版,可以装进 32 GB 内存,代码能力保留得不错,但中文能力明显变弱。日常需要中文对话的话,内存允许时建议选完整专家的档位。
首次启动的注意事项
模型启动时需要向内存加载 35 到 55 GB 数据,电脑可能卡顿 1 到 3 分钟,第一次最久。这属于正常现象,不要急着关闭窗口。
接入 Claude Code 和 Codex
Claude Code 配置
Claude Code 使用 Anthropic 接口,设置三个环境变量即可:
export ANTHROPIC_BASE_URL=http://127.0.0.1:8080
export ANTHROPIC_AUTH_TOKEN=local
export ANTHROPIC_MODEL=sonnet
claude
模型名需要填一个 Claude Code 认可的名称,否则无法启动;Strata 端会忽略这个名称。
Claude Code 每次请求都会在系统提示词中插入一段会变化的计费标记,Strata 专门把它固定住,使系统提示词和工具列表每一轮都能命中缓存,不用从头读取。
Codex 配置
Codex 使用 Responses 接口,在 ~/.codex/config.toml 中添加一个 provider:
model = "strata"
model_provider = "strata"
model_context_window = 32768

[model_providers.strata]
name = "Strata (local)"
base_url = "http://127.0.0.1:8080/v1"
wire_api = "responses"
stream_idle_timeout_ms = 600000
model_context_window 填写安装时选择的上下文大小。Windows 上 Codex 的沙箱可能拒绝所有 shell 命令,启动时加上 -c 'windows.sandbox="unelevated"' 即可。
其他 OpenAI 兼容应用
其他支持 OpenAI 接口的应用,base URL 填 http://127.0.0.1:8080/v1,API key 和模型名可以随意填写。
使用前的预期
不要期待它在本机达到顶级闭源模型的水平,这是压缩到 2 到 3 bit 的量化版本。它的价值在于:原本用来打游戏的电脑,可以运行一个 125B 模型作为 Agent 后端,不按 token 计费,代码也不离开本机。
总结
如果你有一张 12 GB 以上的显卡和 64 GB 内存,又想给 Claude Code 或 Codex 配一个本地后端,Strata 值得腾出 80 GB 硬盘试一试。项目更新频繁,安装前建议先查看最新的 release 说明。