用 Claude Code 久了,很多人会好奇:它为什么能连续改十几个文件不乱、上下文快满时还能接着干、执行命令前又知道该不该问你?这些问题的答案大多不在模型里,而在模型外面的工程设计里。
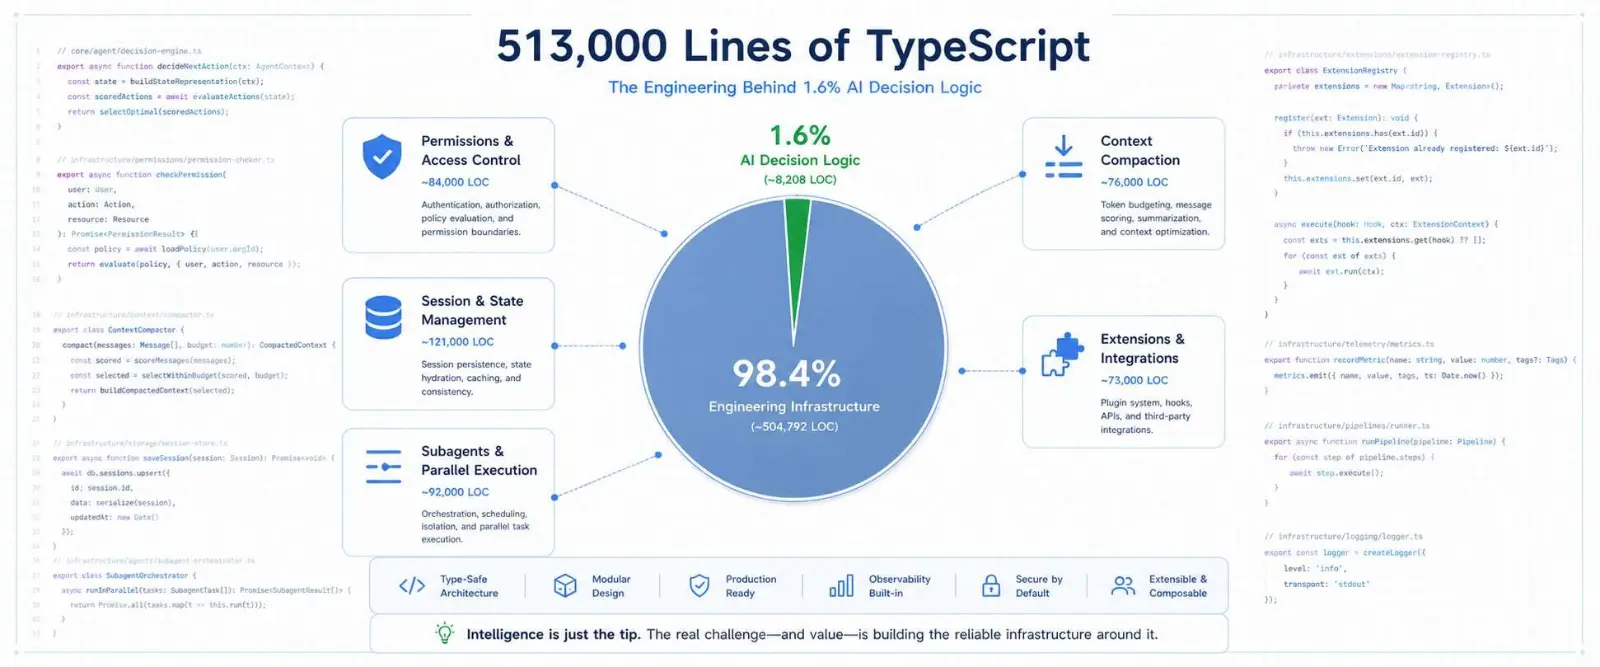
MBZUAI 和 UCL 的研究团队发表了一篇论文《Dive into Claude Code》(arXiv 2604.14228),对 Claude Code v2.1.88 公开的 TypeScript 源码做了系统拆解:约 1900 个文件、约 51.2 万行代码。论文给出的结论是,真正属于 AI 决策逻辑的代码只占约 1.6%,其余约 98.4% 是确定性的基础设施,包括权限、上下文管理、工具调度和故障恢复。
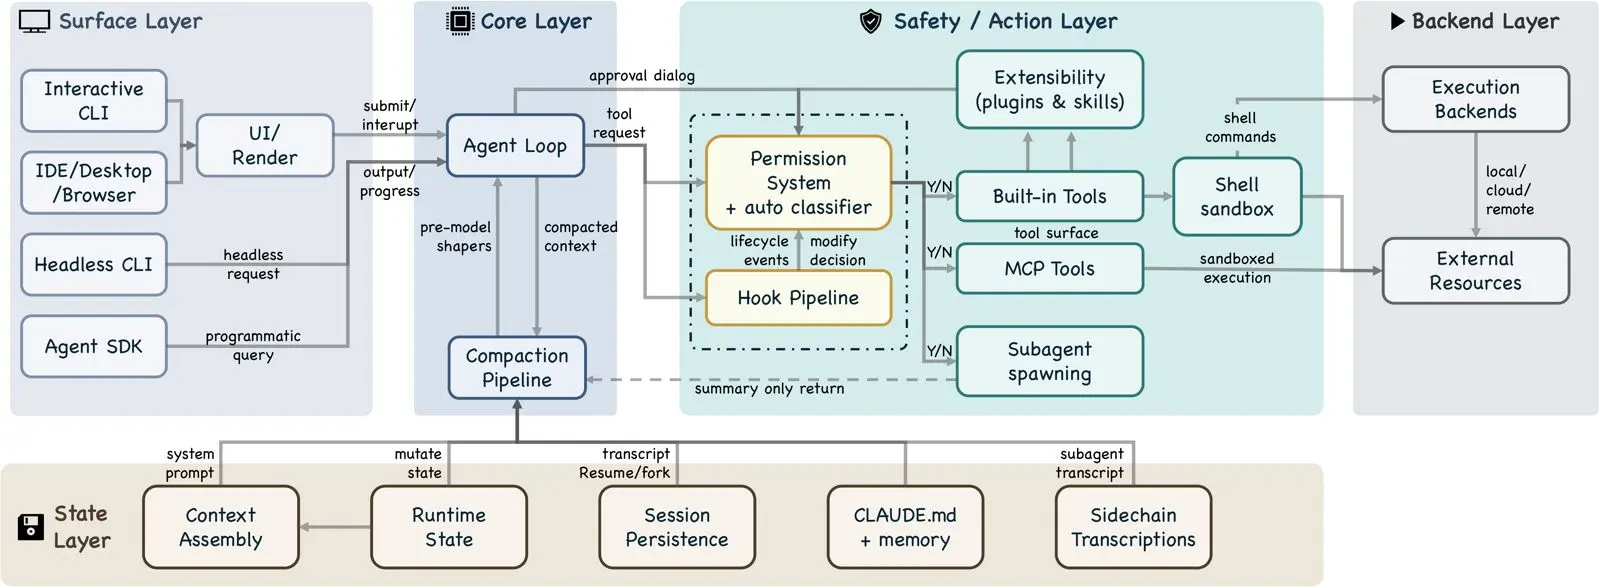
这篇文章按论文的结构,整理 Claude Code 架构里最值得了解的几块:核心循环、上下文压缩、权限系统、扩展机制、子 Agent 和会话存储,最后说说这些设计对日常使用有什么启发。适合想用好 Claude Code,或者正在自己做 AI Agent 的开发者。
Claude Code 架构的核心:一个 while 循环
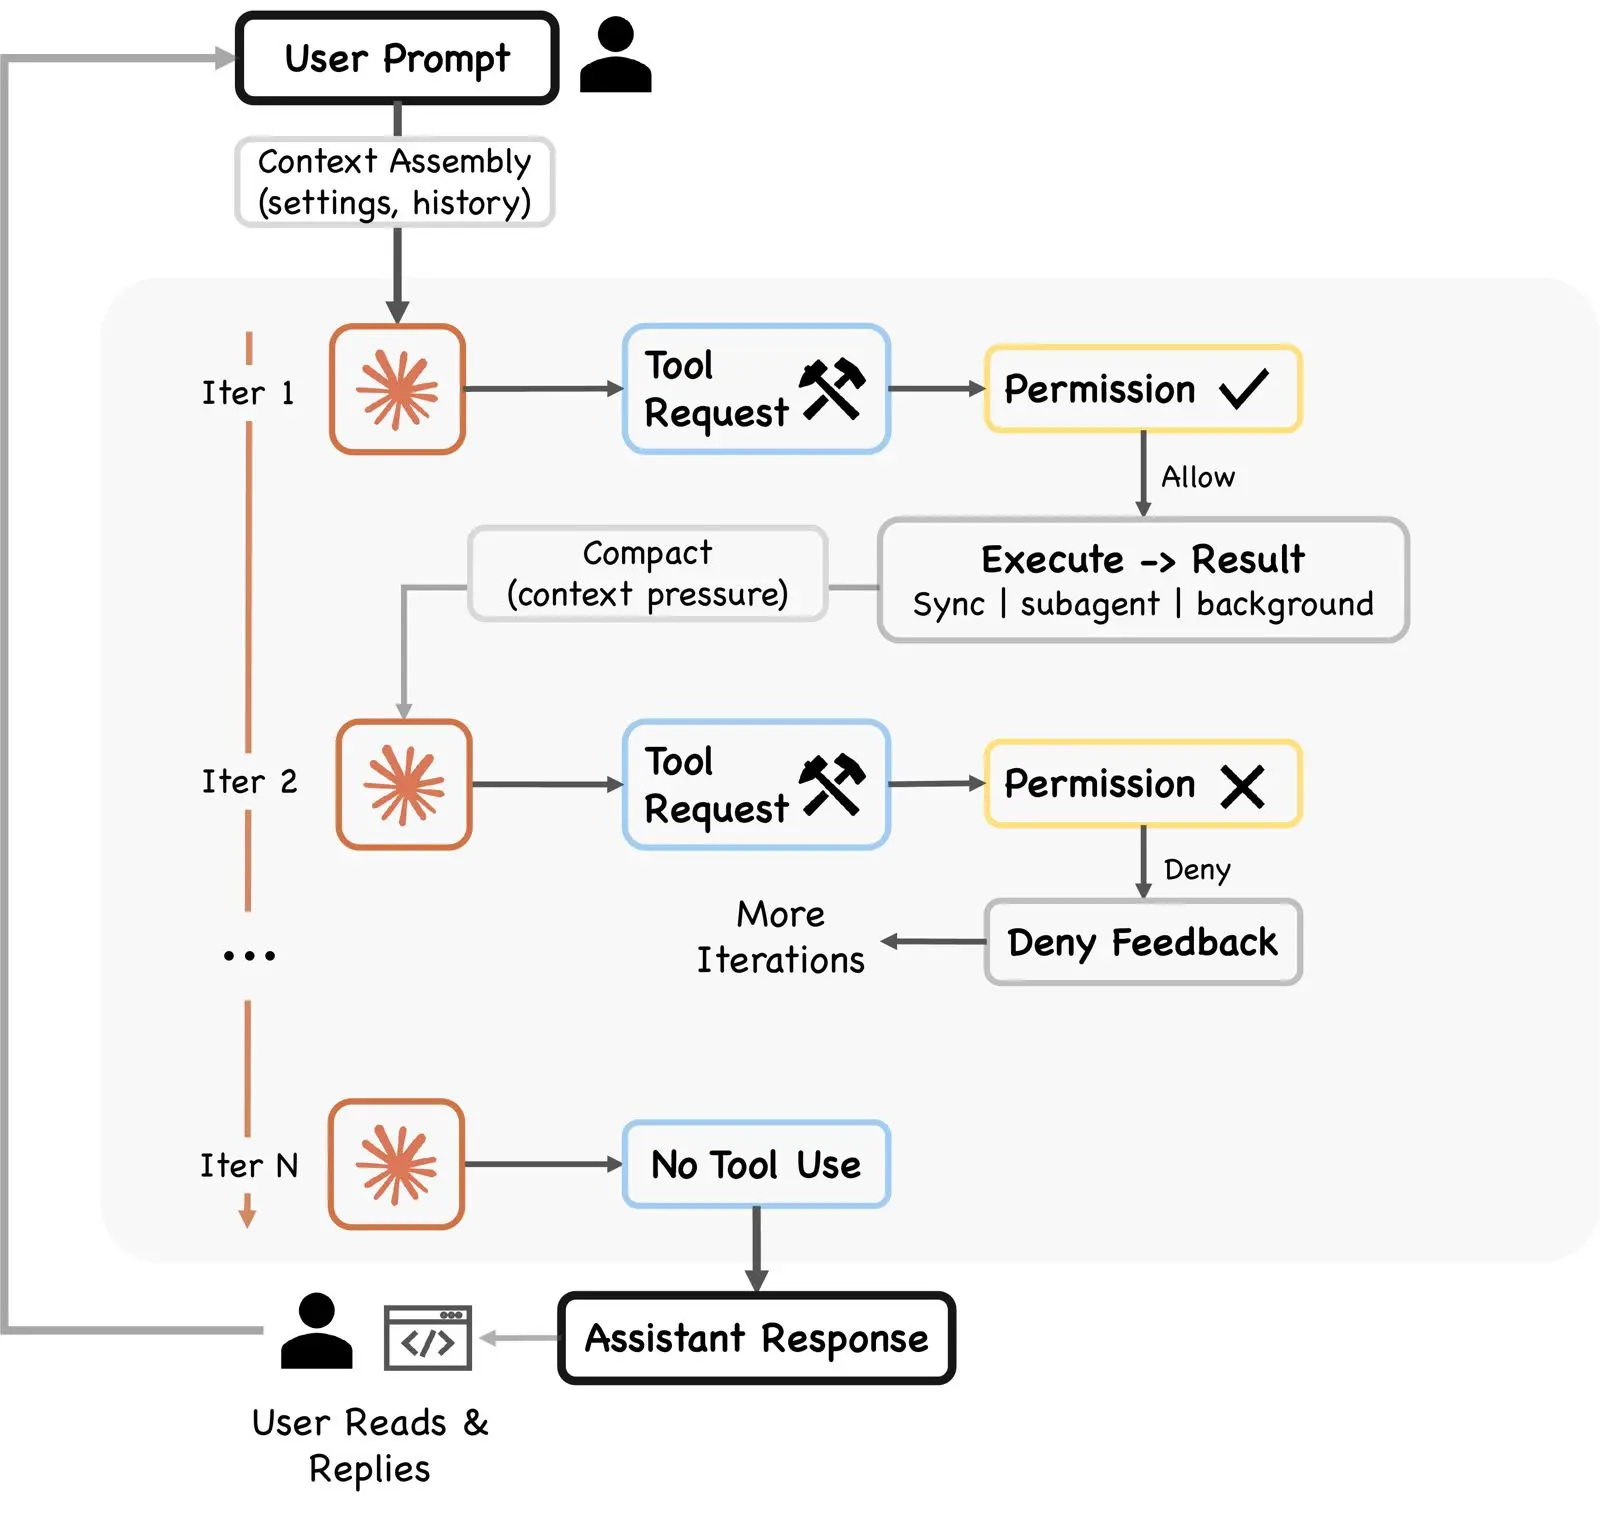
Claude Code 的核心循环很简单:调用模型,执行模型请求的工具,把结果交回模型,重复,直到任务完成。
这里没有复杂的规划器、状态机或多步编排图。模型读上下文,决定下一步做什么,调用工具,观察结果,再继续。什么时候停下来,也由模型自己决定。
论文把这种结构叫作“Kernel + Harness”:一个很薄的 AI 内核,外面包着一层很厚的确定性外壳。模型负责思考,外壳负责兜底,工程上的复杂度几乎都在循环外面。换句话说,Claude Code 不是靠精巧的编排让 AI 更聪明,而是靠工程系统让 AI 不出事。
5 级上下文压缩
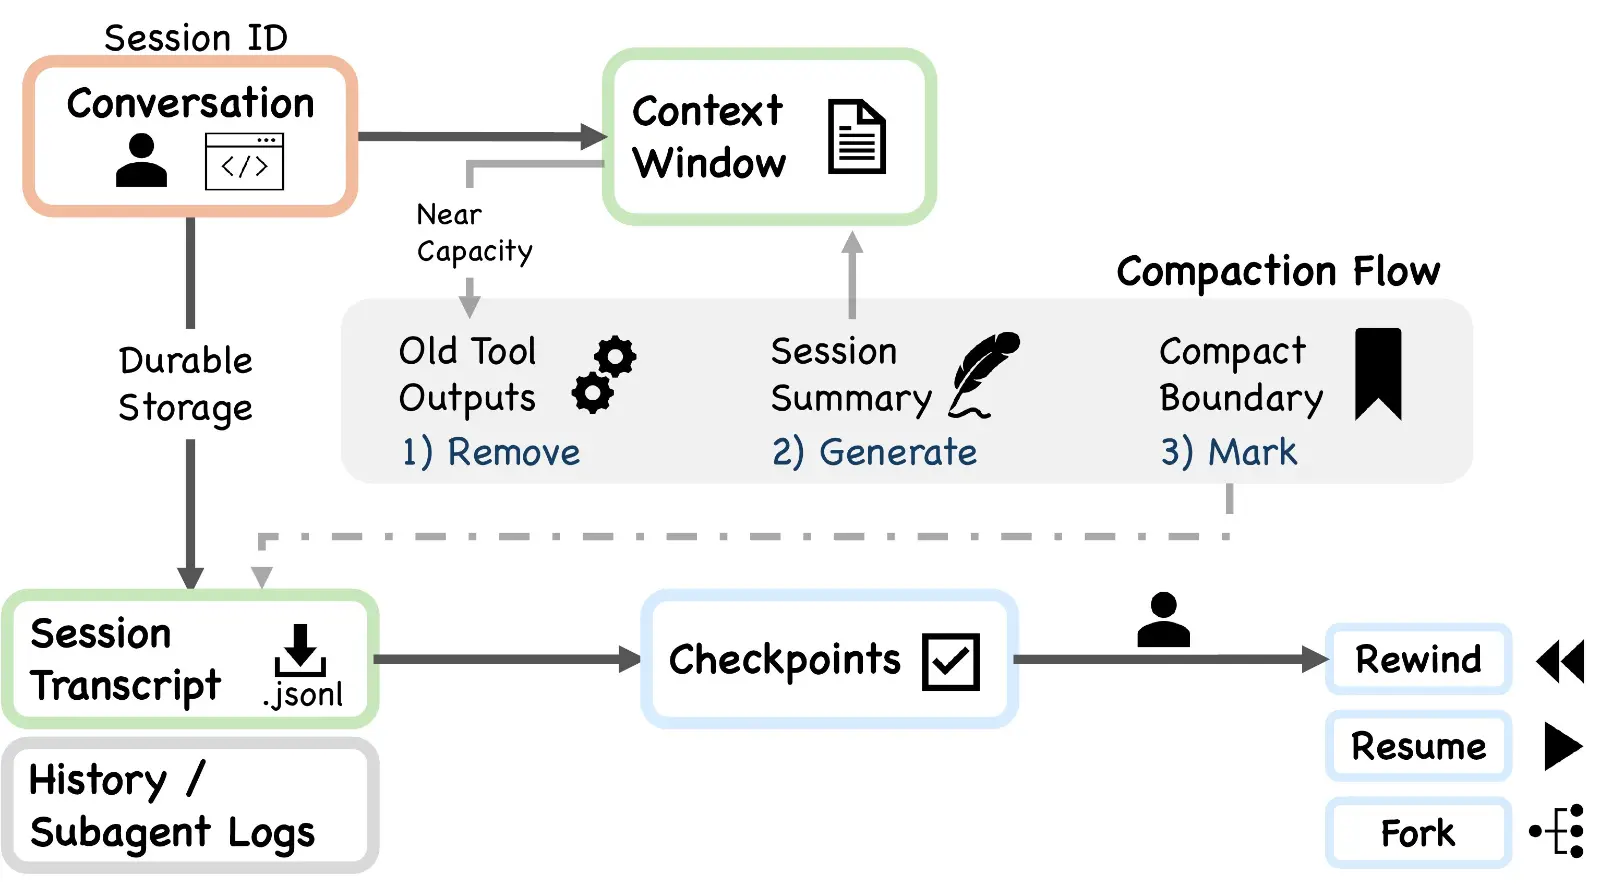
一个复杂的多文件调试会话,填满上下文窗口的速度比想象中快。Claude Code 在每次调用模型前,会按从便宜到昂贵的顺序依次考虑五个压缩阶段:
- Budget reduction:削减工具输出的预览长度;
- Snip:删掉会话前面已经用不上的工具结果;
- Microcompact:压缩特定片段;
- Context collapse:把大段对话折叠成摘要;
- Auto-compact:对整个会话做总结,作为最后手段。
能在便宜的阶段解决,就不动昂贵的阶段。大多数时候前几级就能腾出足够空间。
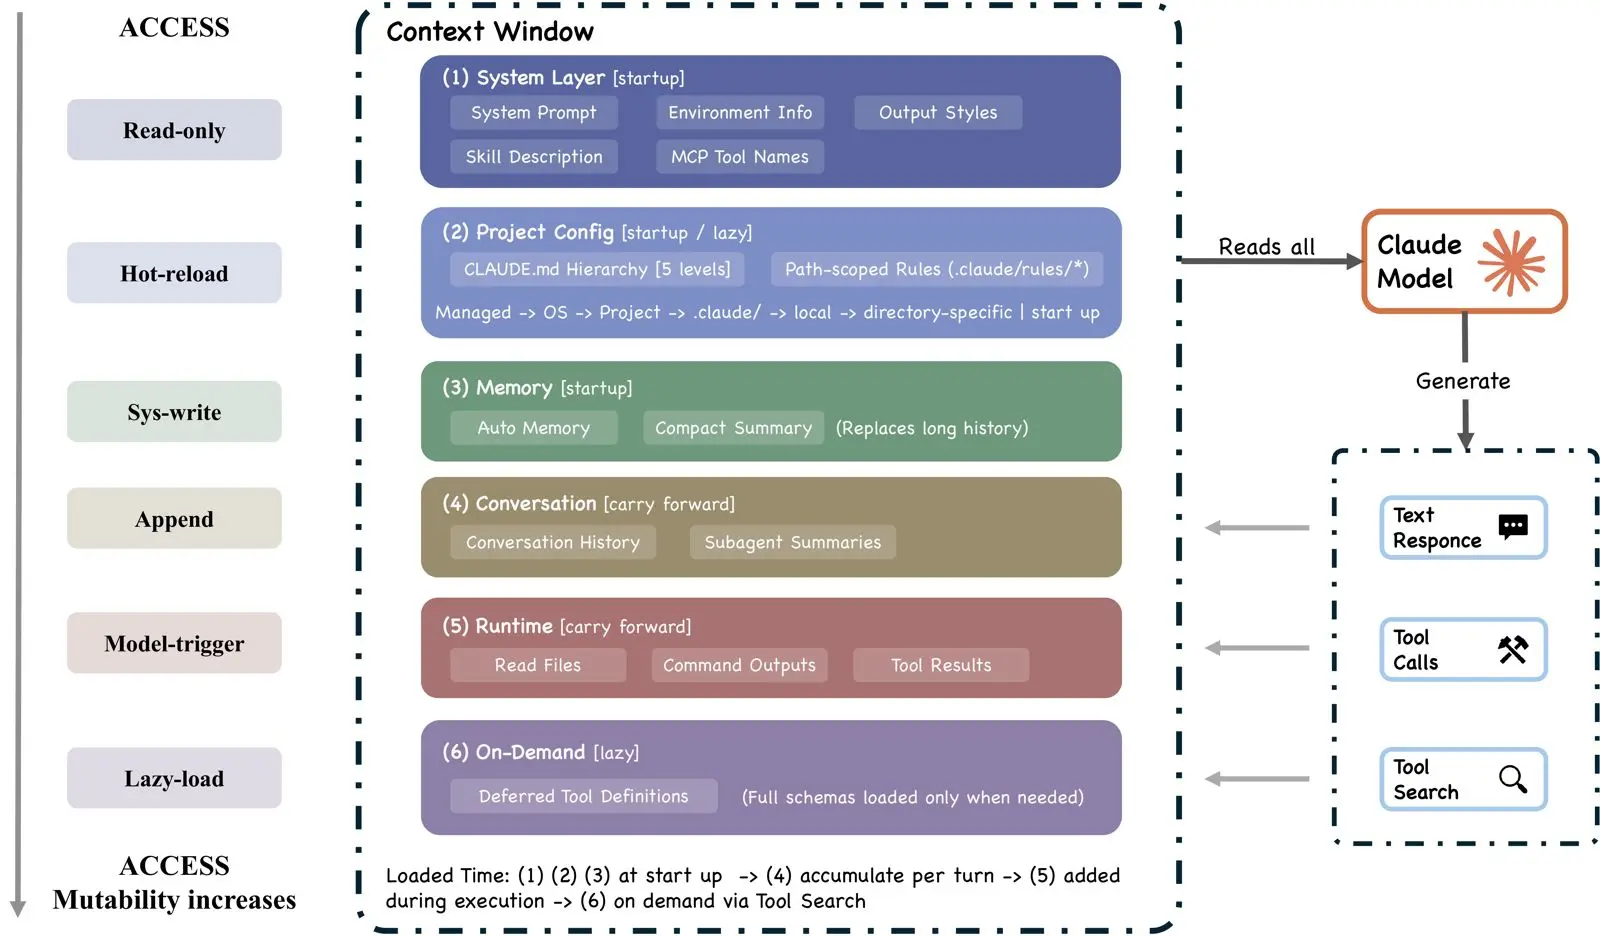
CLAUDE.md 在这套机制里地位特殊:它在压缩后会重新从磁盘读取,所以写在里面的项目约定、架构决策和编码规范不会因为压缩而丢失。这也是社区反复建议“把最重要的规则写进 CLAUDE.md”的原因。我们之前在 Claude Code 配额为什么消耗这么快 里也提到过,上下文管理直接影响 token 消耗。
权限系统:7 种模式,层层把关
论文把 Claude Code 的安全设计概括为“默认拒绝、逐次评估”,大致可以分成三层:
- 工具注册过滤:被禁用的工具直接从模型能看到的工具列表里移除,模型连调用的机会都没有;
- 单次调用检查:每次工具调用都根据工具名、参数和工作目录做规则匹配;
- 交互式询问:没有匹配的规则时实时询问用户,用户的回答会成为当前会话的规则。
权限模式共有 7 种,从 plan、default、acceptEdits,到用分类器自动判断的 auto,再到 dontAsk 和完全信任的 bypassPermissions(只适合沙箱环境)。规则可以来自组织策略、用户、项目、本地配置、命令行参数和当前会话等多个层级。设计思路是:不粗暴地全部拦截,只拦真正需要人来判断的操作。
4 种扩展机制,成本各不相同
| 机制 | 上下文成本 | 适合做什么 |
|---|---|---|
| Hooks | 几乎为零 | 事件触发的确定性脚本,模型不参与 |
| Skills | 低 | 可复用的操作说明和模板,模型按需加载 |
| Plugins | 中 | 打包好的一组命令、Agent、Hook 等 |
| MCP | 高 | 完整的外部服务集成 |
不是所有事情都该用 MCP。一个 MCP 服务的工具描述可能就占几千 token,接上五六个,光工具列表就会吃掉一大块上下文。比较稳的思路是:能用 Hook 解决的不用 Skill,能用 Skill 解决的不上 MCP。Hook 的实际用法可以看我们写的 用 Claude Code Hooks 装上三道硬护栏。
子 Agent:上下文隔离,只交回结论
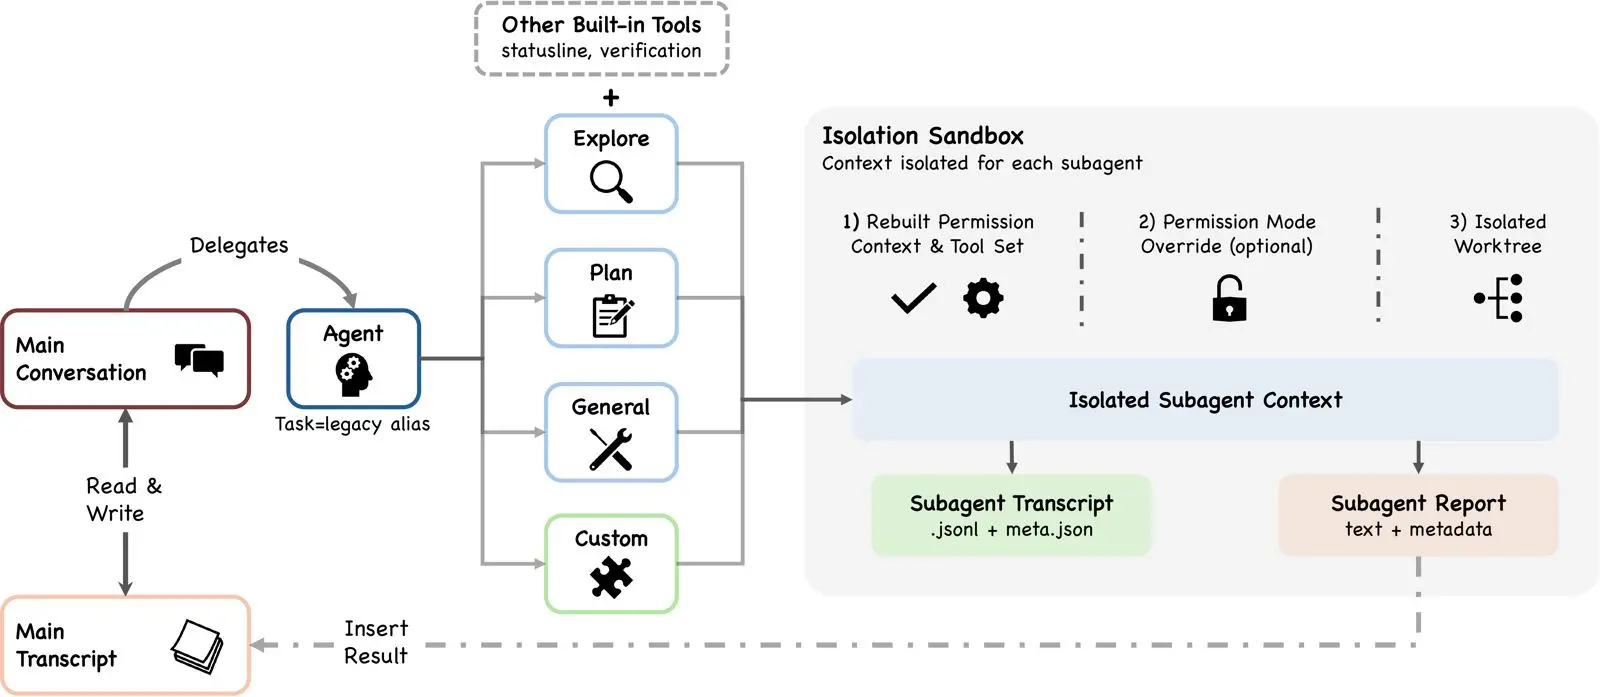
Claude Code 拆分任务时会启动子 Agent。每个子 Agent 有自己独立的对话记录(论文称为 sidechain),执行方式可以是同进程、独立 git worktree 或远程环境。
关键在于返回方式:子 Agent 内部可能消耗了大量 token,交回父 Agent 的通常只是一段简短的结论。比如让 Claude Code 重构一个模块,它可能派一个子 Agent 跑测试、另一个检查类型,主会话只收到“测试全部通过”“类型检查没问题”这样的结果,上下文保持干净。需要注意的是,上下文隔离不等于文件隔离,多个子 Agent 改同一批文件时,是否互相影响取决于所用的执行方式。
会话存储:只追加,不覆盖
会话记录以 JSONL 文件保存在本机的 Claude Code 项目目录下,采用只追加的方式写入,从不原地覆盖。这让会话可以完整审计,也能通过 claude --continue 或 /resume 恢复到之前的状态。
新开会话有一种“冷启动成本”:一个已经跑了一段时间的会话,知道你的文件结构、命名习惯和哪些测试容易失败;新会话则什么都不知道。所以 claude --continue 不只是“接着聊”,而是接着用一个已经积累了上下文的 Agent。
这套架构对日常使用的启发
- 重要规则写进 CLAUDE.md:它在压缩后会被重新读取,比在对话里反复强调更可靠。
- 扩展从轻到重选:先考虑 Hook 和 Skill,MCP 按需接入,用不到的及时关掉。
- 大任务交给子 Agent:让主会话只接收结论,减少上下文被细节撑满的情况。
- 长期项目用 continue 或 resume:保留已有积累,减少重复解释。
- 权限模式按场景选:日常开发用默认或 acceptEdits,完全信任的模式只在沙箱里用。
总结
论文对 Claude Code 的拆解可以概括成一句话:把模型当成一个能力很强、但需要严格管理的同事。模型只负责决定下一步做什么,其余的代码都在解决“怎么让它安全地做、高效地做、做完还能接着做”。对做 AI 产品的人来说,这也说明了一件事:模型选择和提示词只是起点,决定产品体验的往往是模型周围那一大圈工程。
想直接体验这套设计,可以在 AIGoCode 上接入 Claude Code,在自己的项目里试一试。
参考链接
- 论文(arXiv):https://arxiv.org/abs/2604.14228
- 论文仓库 Dive-into-Claude-Code:https://github.com/VILA-Lab/Dive-into-Claude-Code
- Claude Code 官方文档:https://code.claude.com/docs