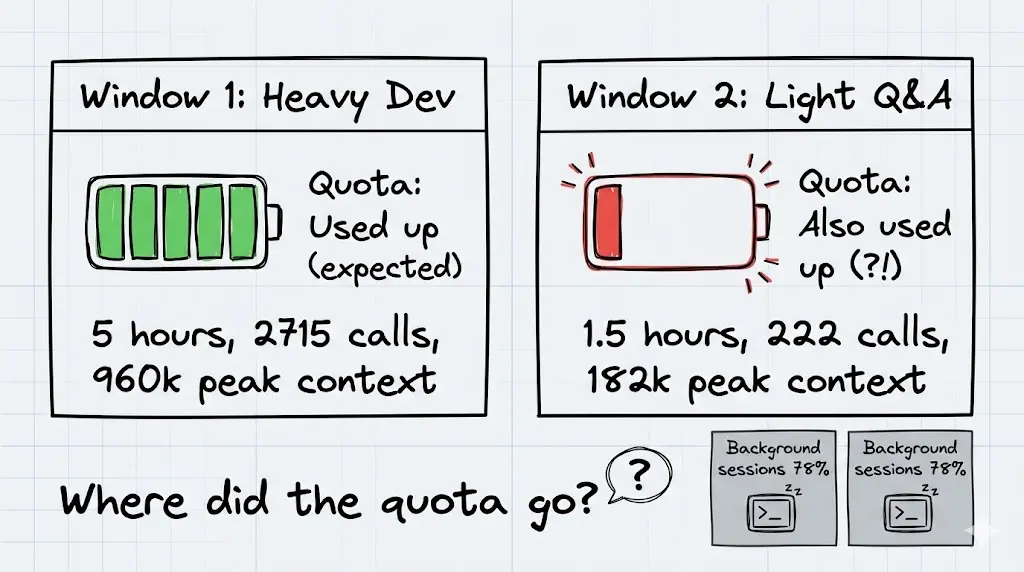
不少 Claude Code 订阅用户都遇到过这种情况:前一天重度开发 5 个小时才用完一个配额窗口,第二天只是问答和小改动,1.5 小时就被提示到达用量上限。明明用得更少,配额却掉得更快。
2026 年春天,社区里有人把 Claude Code 本地的会话日志全部拿出来,分析了约 12 万条 API 调用记录,指出两个可能的原因:prompt cache 的存活时间(TTL)变短,以及缓存读取在配额上的计算方式。后来 Claude Code 团队也在 GitHub 上做了回应,官方文档也补上了相关的控制项。
这篇适合在用 Claude Code、觉得配额或账单消耗快、想弄清原因并做点调整的开发者。下面会讲 prompt cache 是怎么影响 Claude Code 配额消耗的、社区分析发现了什么、官方怎么解释,以及现在可以用哪些命令和设置去排查和控制。
prompt cache 和 TTL:Claude Code 配额消耗的关键
Claude Code 每轮对话都会把系统提示、工具定义和历史消息发给模型。为了避免重复计算,API 会把这些前缀缓存起来,下一轮直接读缓存。按 Anthropic 官方定价,缓存相关的价格是这样的:
| 类型 | 相对基础输入价格 |
|---|---|
| 5 分钟缓存写入 | 1.25 倍 |
| 1 小时缓存写入 | 2 倍 |
| 缓存读取 | 0.1 倍 |
也就是说,以 5 分钟 TTL 计,一次缓存写入的价格是读取的 12.5 倍。只要缓存还活着,后续每轮的成本都很低;一旦过期,下一轮就要把整段上下文重新写一遍。
缓存能活多久就是 TTL。每次命中缓存都会重新计时,所以连续工作时缓存一直是热的;中间停得比 TTL 长,回来的第一轮就会变慢、变贵。上下文越大,这一下重写的代价越高。
社区分析发现了什么
发现一:缓存 TTL 从 1 小时回到了 5 分钟
GitHub Issue #46829 的作者从两台机器、两个账户的 JSONL 日志里统计了每次调用的缓存 token 分布,给出一条时间线(以下均为原文提到的数据,未经官方确认):
- 2 月 1 日到 3 月 5 日,缓存写入几乎全部走 1 小时 TTL;
- 3 月 6 日起,5 分钟 TTL 重新出现,到 3 月 8 日已占约 83%;
- 按作者估算,三个月里 Sonnet 用户多花约 949 美元、Opus 用户多花约 1,581 美元,整体多花约 17.1%;2 月浪费率约 1.1%,3 月升到约 25.9%。
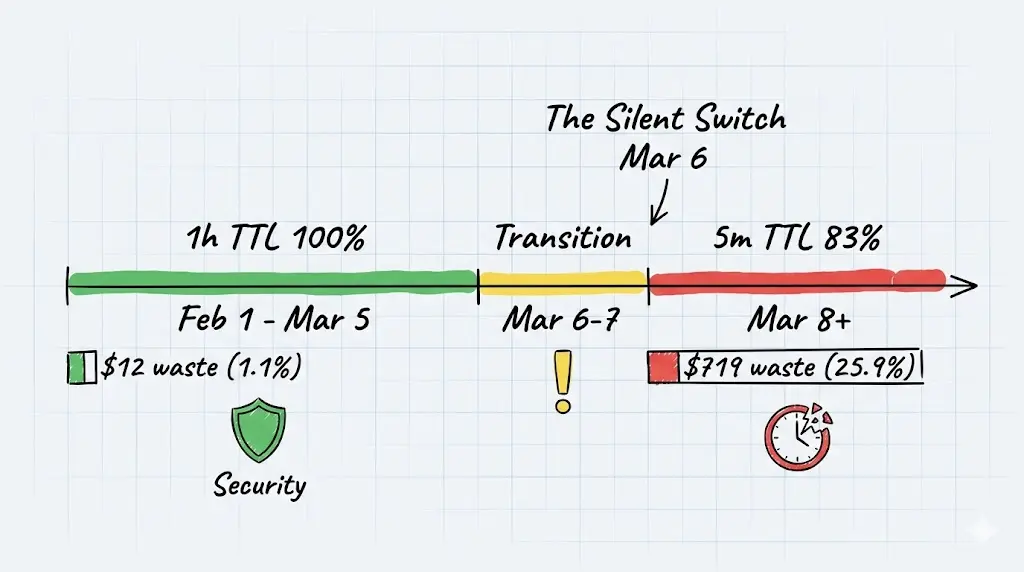
5 分钟 TTL 的影响很直观:写代码中途停下来看 6 分钟文档,缓存就过期了,下一条消息要把整段上下文重新写入。
发现二:缓存读取可能也在大量消耗配额
另一个 Issue(#45756)来自一位 Max 5x 用户,他对比了两个使用窗口(同样为原文提到的数据):
| 窗口一 | 窗口二 | |
|---|---|---|
| 时长 | 约 5 小时重度开发 | 约 1.5 小时问答和小改动 |
| API 调用 | 2,715 次 | 222 次 |
| 峰值上下文 | 约 96 万 token | 约 18 万 token |
| 结果 | 刚好用完配额 | 同样用完配额 |
作者据此推测缓存读取可能按接近全价计入配额。他还发现,自己另外两个开在后台、没在用的会话,因为自动压缩、跑 hook 等操作,贡献了约 78% 的消耗。
官方怎么回应
截至 2026 年 10 月,两个 Issue 的状态不同:#46829 已被关闭(标记为 not planned),#45756 仍是 open。
在 #46829 下,Claude Code 团队的 Boris Cherny 做了解释,要点是:
- 1 小时缓存不是一定更省:它的写入更贵、读取更便宜,划不划算取决于使用方式。比如一个只查询一次的子 Agent,用 1 小时缓存反而是多花钱;
- 他们一直在试验不同的 TTL 策略,已经在部分场景给订阅用户默认启用 1 小时缓存,但像子 Agent 这类很少被续用的请求仍保持 5 分钟;
- 关闭遥测的用户也会关闭实验开关,客户端会读取默认值 5 分钟;
- 实际节省远没有 12 倍那么多,只是一个小的改进。
换句话说,社区观察到的 TTL 变化是真实存在的策略调整,但「每次都按 12 倍多付钱」的估算偏高。至于缓存读取到底怎么计入订阅配额,官方没有给出逐项公式,这一点本文也不下结论。
现在 Claude Code 的 TTL 规则
官方文档现在写明了 Claude Code 每类请求默认用哪种 TTL:
| 请求类别 | 订阅、额度内 | 超出额度用 usage credits、API key 或云厂商 |
|---|---|---|
主对话(交互、-p、Agent SDK) | 1 小时 | 5 分钟 |
| 其他(子 Agent、workflow、teammates、压缩、会话标题等) | 5 分钟(少数服务端控制的辅助请求为 1 小时) | 5 分钟 |
如果想自己指定,可以用以下控制项(需要 Claude Code v2.1.242 或更高版本,取值只能是 5m 或 1h):
- 主对话:设置项
promptCacheTtl或环境变量CLAUDE_CODE_PROMPT_CACHE_TTL; - 主对话以外:设置项
subagentPromptCacheTtl或环境变量CLAUDE_CODE_SUBAGENT_PROMPT_CACHE_TTL; ENABLE_PROMPT_CACHING_1H=1请求 1 小时 TTL,FORCE_PROMPT_CACHING_5M=1强制 5 分钟,后者优先级最高。
例如用 API key 时想让主对话保持 1 小时缓存:
export CLAUDE_CODE_PROMPT_CACHE_TTL=1h
claude
注意 1 小时缓存的写入价格更高。如果你习惯连续工作、很少中途离开超过 5 分钟,开 1 小时并不划算。
排查 Claude Code 配额消耗:先看 /usage
动手调整之前,先确认钱花在了哪里:
/usage:订阅用户能看到配额进度条和用量构成,近期占比超过 10% 的行为(如长上下文、缓存未命中)会被单独标出;会话区块里还有一行Prompt cache (main),显示缓存命中比例、未命中次数和缓存当前是热还是冷(需要 v2.1.251 或更高版本)。/context:看当前上下文被什么占满了。- 状态栏:把上下文用量常驻在终端底部,做法可以参考 Claude Code 上下文快满了却不知道?用 Claude HUD 加一条实时状态栏。
- 本地日志:Claude Code 的会话记录保存在
~/.claude/projects/下的 JSONL 文件里。原文提到社区有人开源了分析工具cnighswonger/claude-code-cache-fix,可以用来统计自己的缓存情况,使用前建议先看清它读取和修改了什么。
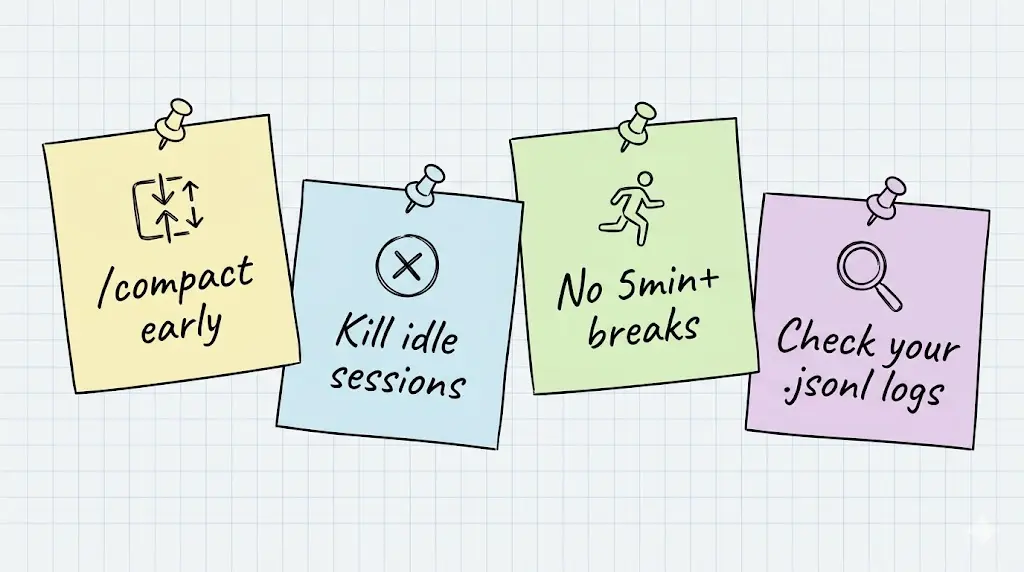
控制 Claude Code 配额消耗的几个做法
- 在自然断点手动
/compact:官方文档建议在任务之间压缩,而不是等自动压缩在任务中途触发。缓存还热的时候压缩,大部分内容能从缓存读取,成本较低;离开很久再压缩,就要把整段历史当作未缓存输入重新处理。 - 放弃一条思路时用
/rewind:回退到已缓存的前缀,比压缩更省。 - 关掉不用的会话:后台会话也可能因为压缩、hook 等操作继续消耗同一份配额。
- 避免中途切换会让缓存失效的东西:切换模型、修改 effort、启用或停用插件、增删 MCP 服务器、升级 Claude Code,都可能让下一轮缓存未命中。
- 控制上下文大小:上下文越大,每次缓存过期后的重写越贵。1M 上下文很方便,但也意味着每次失效的代价更高。
如果你通过 API 或中转服务使用 Claude Code,按 token 计费时也可以用同样的思路核对一次任务的实际消耗,具体步骤见 AIGoCode 额度消耗比预期快:如何核对一次任务的用量。
总结
Claude Code 配额消耗快,常见原因不是「用得多」,而是缓存过期后的整段重写、过大的上下文,以及在后台悄悄运行的会话。社区当时的分析把问题指向了 TTL 变化,官方的回应则说明这是有意的策略调整,节省幅度也没有估算的那么大。
现在比较实际的做法是:先用 /usage 和 /context 看清消耗构成,再决定要不要调整 TTL、什么时候手动压缩、哪些会话该关掉。
想按自己的节奏使用 Claude Code、按实际用量计费,可以在 AIGoCode 上直接使用 Claude Code 和 Codex。
参考链接
- Cache TTL 分析 Issue #46829:https://github.com/anthropics/claude-code/issues/46829
- 配额异常 Issue #45756:https://github.com/anthropics/claude-code/issues/45756
- Claude Code 文档:Prompt caching:https://code.claude.com/docs/en/prompt-caching
- Claude Code 文档:Manage costs:https://code.claude.com/docs/en/costs
- Anthropic 文档:Prompt caching 定价:https://platform.claude.com/docs/en/build-with-claude/prompt-caching#pricing