用 Claude Code 久了会发现,它的回复里经常有大段铺垫、复述和客套,真正要用的可能只有一两句话。问一个 React 重渲染的问题,它会先解释浅比较、引用和渲染周期,最后才告诉你「用 useMemo 包一下」。
Caveman 是一个开源 Skill,思路很直接:给 Claude Code 加一条回复风格约束,让它先给答案、一句只讲一件事,删掉寒暄和缓冲句,但代码、命令、路径和报错信息一个字符都不改。它最早在 2026 年 4 月以玩笑项目的形式出现,现在已经扩展成一套覆盖 30 多个编程 Agent 的省 token 工具。
这篇适合想控制 Claude Code token 消耗的开发者。下面会讲 Caveman 的原理和回复规则、各档位怎么用、怎么安装,以及项目自己公布的实测数据:它在哪些场景能帮 Claude Code 省 token,在哪些场景反而不划算。
Caveman 是什么,怎么帮 Claude Code 省 token
Caveman 的核心是一个回复风格 Skill。装上后,同一个问题的回答会从这样:
"The reason your React component is re-rendering is likely because you are creating a new object reference on each render cycle. When you pass an inline object as a prop, React shallow comparison sees it as a different object every time, which triggers a re-render. I would recommend using useMemo to memoize the object."
变成这样:
"New object ref each render, so React re-renders. Wrap the prop in useMemo."
信息没少,字数少了很多。按项目 README 的统计,这个例子从 63 个 token 降到 20 个。
它没有什么黑科技,就是一套写给模型的回复规则:
| 规则 | 含义 |
|---|---|
| 先给答案 | 按「对象 + 动作 + 原因 + 下一步」组织,不寒暄、不复述 |
| 一句一件事 | 参考飞机维修手册用的受控英语 ASD-STE100,每句不超过 20 词 |
| 不丢关键语义 | 冠词可以删,not、never、only 这类词不能删,数字和单位保持准确 |
| 内容原样保留 | 代码、命令、路径、报错信息逐字保留 |
| 知道何时停 | 安全警告、不可逆操作、用户困惑时,恢复完整句子 |
| 不改你的提示词 | 只压缩模型输出,不改写你的输入 |
需要说明的是,Caveman 只影响模型最后输出给你看的文字,不砍模型的思考过程。
说得少,会不会答得更差
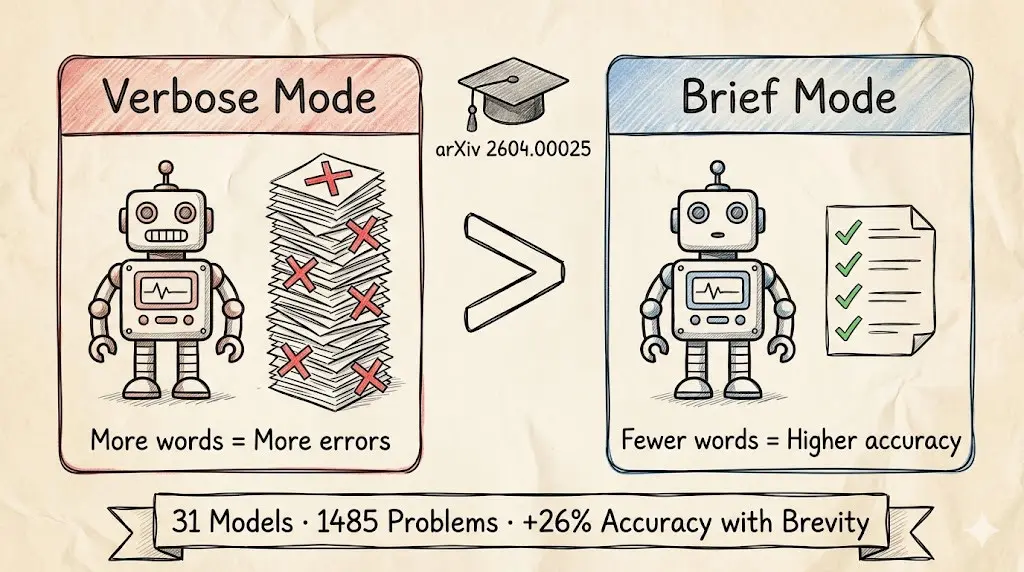
直觉上,回复短了容易丢信息。原文引用了论文 Brevity Constraints Reverse Performance Hierarchies in Language Models(arXiv:2604.00025):研究团队用 31 个模型(0.5B 到 405B)测试 1485 道题,发现在 7.7% 的题目上,大模型反而比小模型差 28.4 个百分点,原因是模型越大越容易啰嗦,在冗长推导中引入错误;限制大模型简短作答后,这部分题目的准确率提升了 26 个百分点。
Caveman 项目也列了几项外部验证:JetBrains 用 86 个真实编程任务做配对 A/B 测试,没有发现可测量的质量下降;Elastic 把这套方法改造到 Elasticsearch 场景,回复 token 减少 63.6%。项目同时引用 Adobe Research 的研究提醒:压缩用户的提示词会让答案变差,所以 Caveman 只压缩输出,不碰你的输入。
到底能省多少:先看项目自己的诚实数据
原文作者早期用旧版 Skill 跑过 10 项开发任务,解释类任务省得最多,平均从 1214 降到 294 token:
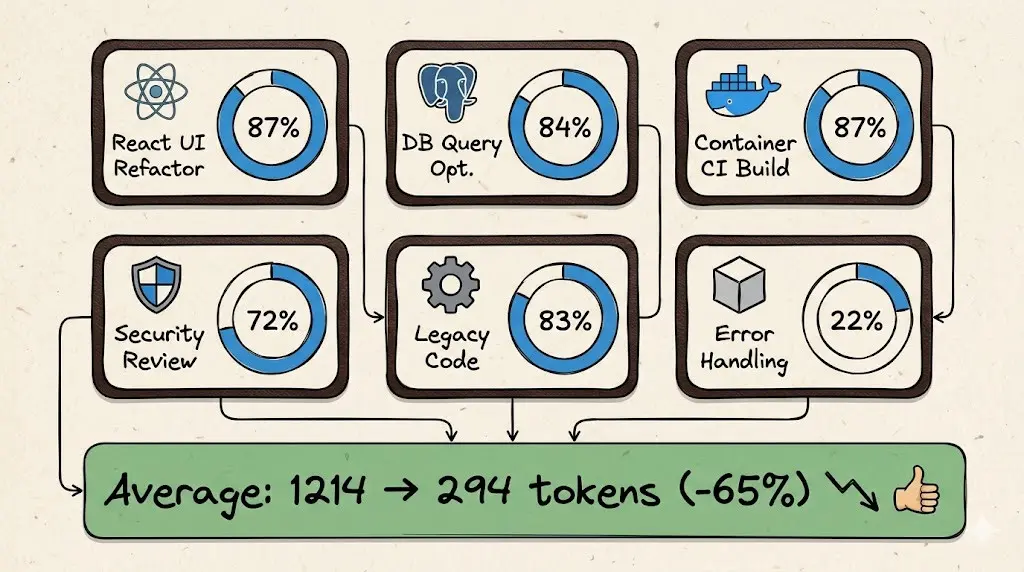
这组数据是和模型默认的冗长回复比较的。现在项目在 README 和 Honest Numbers 页面里用了更严格的基线:和一句简单的「Answer concisely.」相比,在 claude-opus-5-5 上测 10 个开发问题:
| 指令 | 输出 token |
|---|---|
| 不加任何指令 | 6,983 |
Answer concisely. | 4,334 |
/caveman | 4,119 |
/ultracave | 2,693 |
也就是说,新模型本来就能听懂「简洁一点」,在这个基础上,/caveman 的中位数只多省约 3%,/ultracave 多省约 35%(基于 3.1.0 版规则测得,样本量小)。
项目还明确写了 Caveman 不划算的情况:
- 规则本身要占输入 token:README 估计约 1,160 个 token。本来就很短的问答,省下的输出可能抵不过这部分开销。
- 按请求计费的工具省不了钱:比如 GitHub Copilot 按 premium request 计费,回答再短也是一次请求。
- Agent 会话的账单大头是输入:真实编程会话里,大部分 token 花在读代码、工具结果和缓存重读上,只压缩输出的效果有限。有用户统计 662 个 Claude Code 会话,输出只占全部 token 的 0.3%。
所以判断 Caveman 值不值,最可靠的方法是在同一个任务上开关各跑一次,对比账单或用量页面。项目的建议也是:如果同一任务开了 Caveman 反而更贵,就对这类工作关掉它。
为了覆盖输入这一块,Caveman 4.0 增加了本地代理等组件,比如在模型读取前压缩日志、JSON、CSV 和测试输出,项目称整场会话的输入 token 平均减少 33.2%(HTML 暂无压缩器,结果反而变差)。这些属于完整 CLI 的功能,和下面单独装 Skill 是两回事。
档位与常用命令
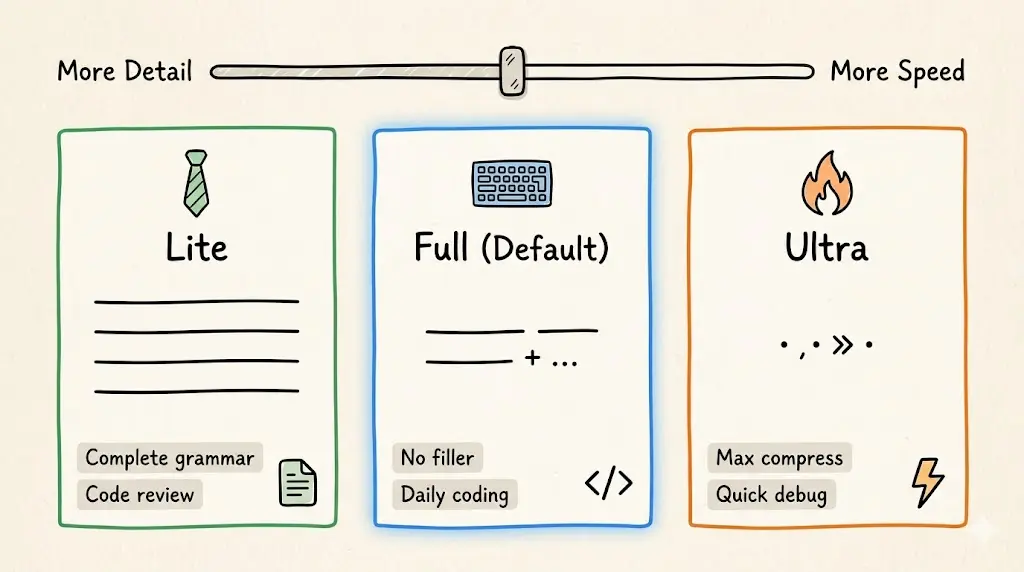
原文介绍的是旧版的 Lite / Full / Ultra 三档。按项目当前 README,Skill 的档位命令是:
| 命令 | 效果 | 示例回复 |
|---|---|---|
/caveman | 默认档,句子精简但完整可读 | New object ref each render, so React re-renders. Wrap the prop in useMemo. |
/ultracave | 接近关键词的极限压缩 | Inline object prop, new ref, re-render. useMemo. |
/megacave | 用文言文压缩 | 新參照致重繪。useMemo。 |
/caveman status 查看当前模式,/caveman off 或直接说 stop caveman 关掉。另外还有几个实用命令:
/caveman-commit:生成一行 Conventional Commit 提交信息。/caveman-review:一行一个问题的代码审查,如L42: 🔴 null deref. Guard it./caveman-compress <file>:压缩 CLAUDE.md 这类记忆文件并备份原文件。注意这个命令会把文件内容发给你配置的模型服务商。/caveman-stats:读取本次 Claude Code 会话的实际 token 用量。
装的 Skill 越多,规则本身占的上下文也越多,这笔账可以参考 ECC 一次装进 Claude Code 292 个 skill,先算清你的上下文账。
日常用法可以这样分:写给别人看的内容(PR 描述、文档)保持正常回复;自己调试、反复问小问题时开 /caveman;上下文都在脑子里、只要一个方向提示时用 /ultracave。
安装 Caveman
只想要缩短回复的 Skill:
npx skills add JuliusBrussee/caveman -g
装好后输入 /caveman 启用(Codex 里用 $caveman),说 stop caveman 恢复正常。卸载用 npx skills remove JuliusBrussee/caveman -g。
想让 Claude Code 每次会话自动启用,可以用插件方式安装:
claude plugin marketplace add JuliusBrussee/caveman && claude plugin install caveman@caveman
完整工具(包含输入压缩、模型自动选择等组件)用 CLI 安装,需要 Node.js 22.13 或更高版本:
npx @caveman-ai/cli@latest
安装前有两点隐私设置值得看一眼:单独的 Skill 在本地运行、不发送数据;CLI 默认会上报使用统计(命令、token 数等,不含提示词和代码),可以用 caveman telemetry off 或设置 DO_NOT_TRACK=1 关闭。Auto 模型路由功能需要登录,开启后会把你的最新请求等内容发送到 Caveman Cloud。
总结
Caveman 证明了一件事:同一个模型,换一种说话方式,阅读体验差别很大。它适合输出偏长、你需要快速扫读结论的场景,比如调试和代码问答;但在提示词开销占比高、按请求计费、或者会话主要花在读代码的场景里,单靠缩短回复省不了多少。
最稳妥的做法是先装 Skill,用 /caveman-stats 和服务商的用量页面在自己的任务上对比一周,再决定要不要长期开着。对比时怎么核对一次任务实际用了多少,可以参考 AIGoCode 额度消耗比预期快:如何核对一次任务的用量。
想在自己的项目里对比开关 Caveman 的用量差别,可以在 AIGoCode 上直接使用 Claude Code 和 Codex。
参考链接
- Caveman GitHub 仓库:https://github.com/JuliusBrussee/caveman
- Caveman Honest Numbers:https://github.com/JuliusBrussee/caveman/blob/main/docs/HONEST-NUMBERS.md
- 论文 Brevity Constraints Reverse Performance Hierarchies in Language Models:https://arxiv.org/abs/2604.00025