做长文档问答时,最常见的尴尬是:向量数据库返回的内容看起来相关,却不是你要的那个答案。你问“第三季度营收是多少”,它给你一段“公司业务概述”。合同里的“违约赔偿”和“终止条件”用词很近,相似度也高,但根本不是同一条条款。
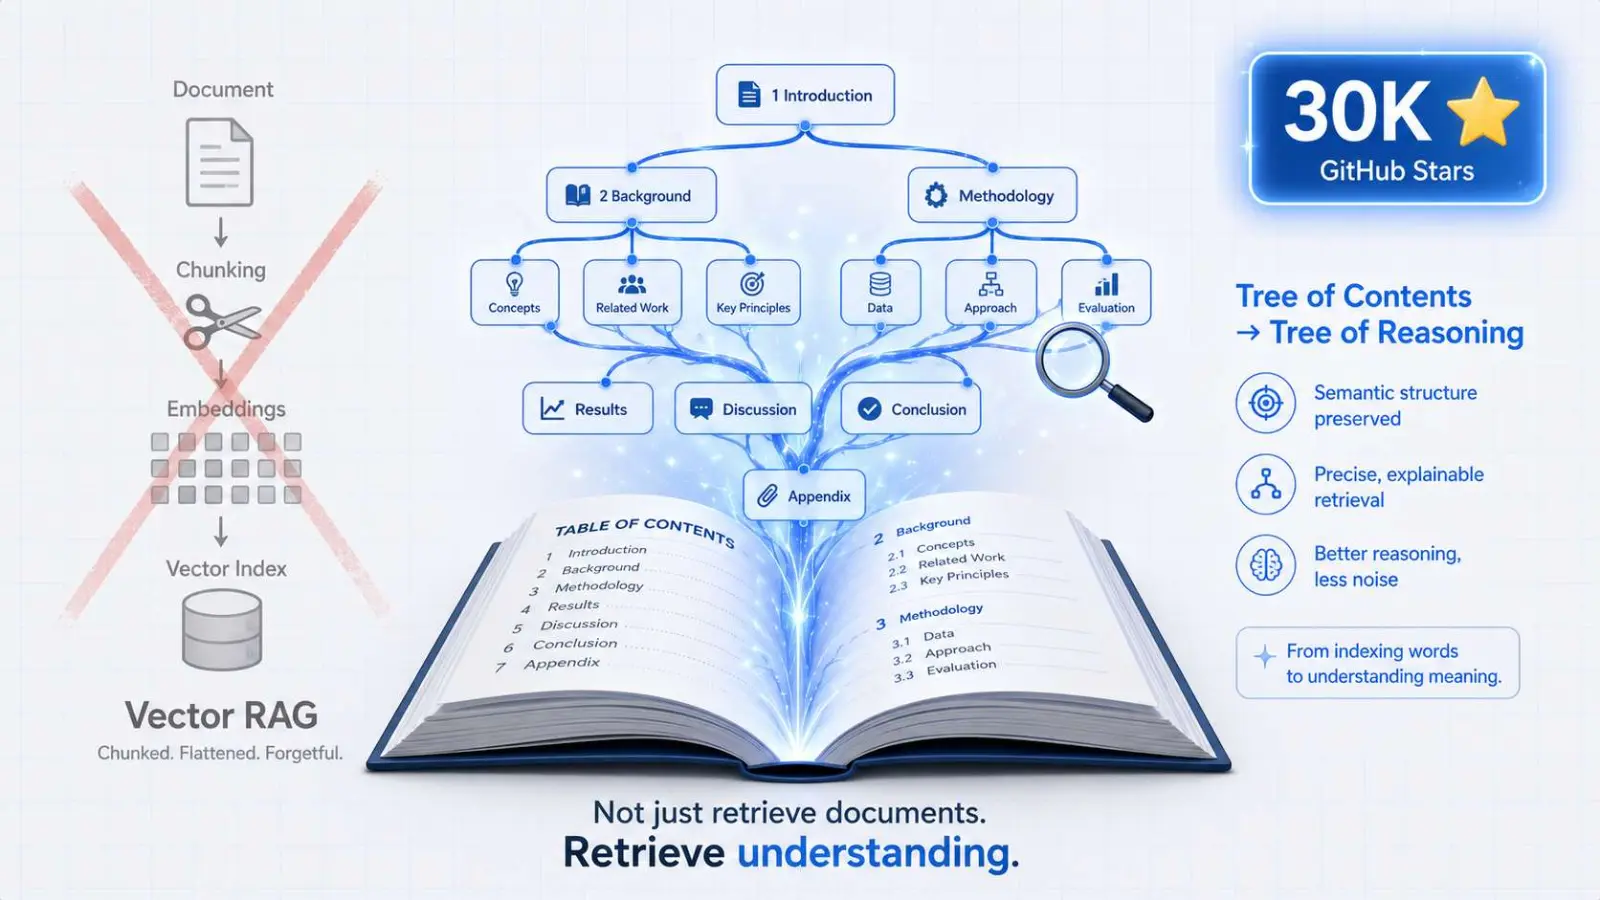
相似并不等于相关。PageIndex 的做法是不建向量索引,而是给文档生成一棵目录树,再让模型沿着这棵树一层层推理,找到该读的章节。GitHub 上目前超过 4 万 star(截至 2026 年 11 月),MIT 协议。
这篇讲它和向量 RAG 差在哪、怎么安装调用,以及本地版和云服务各自适合什么场景。
它是什么:用目录树代替向量库
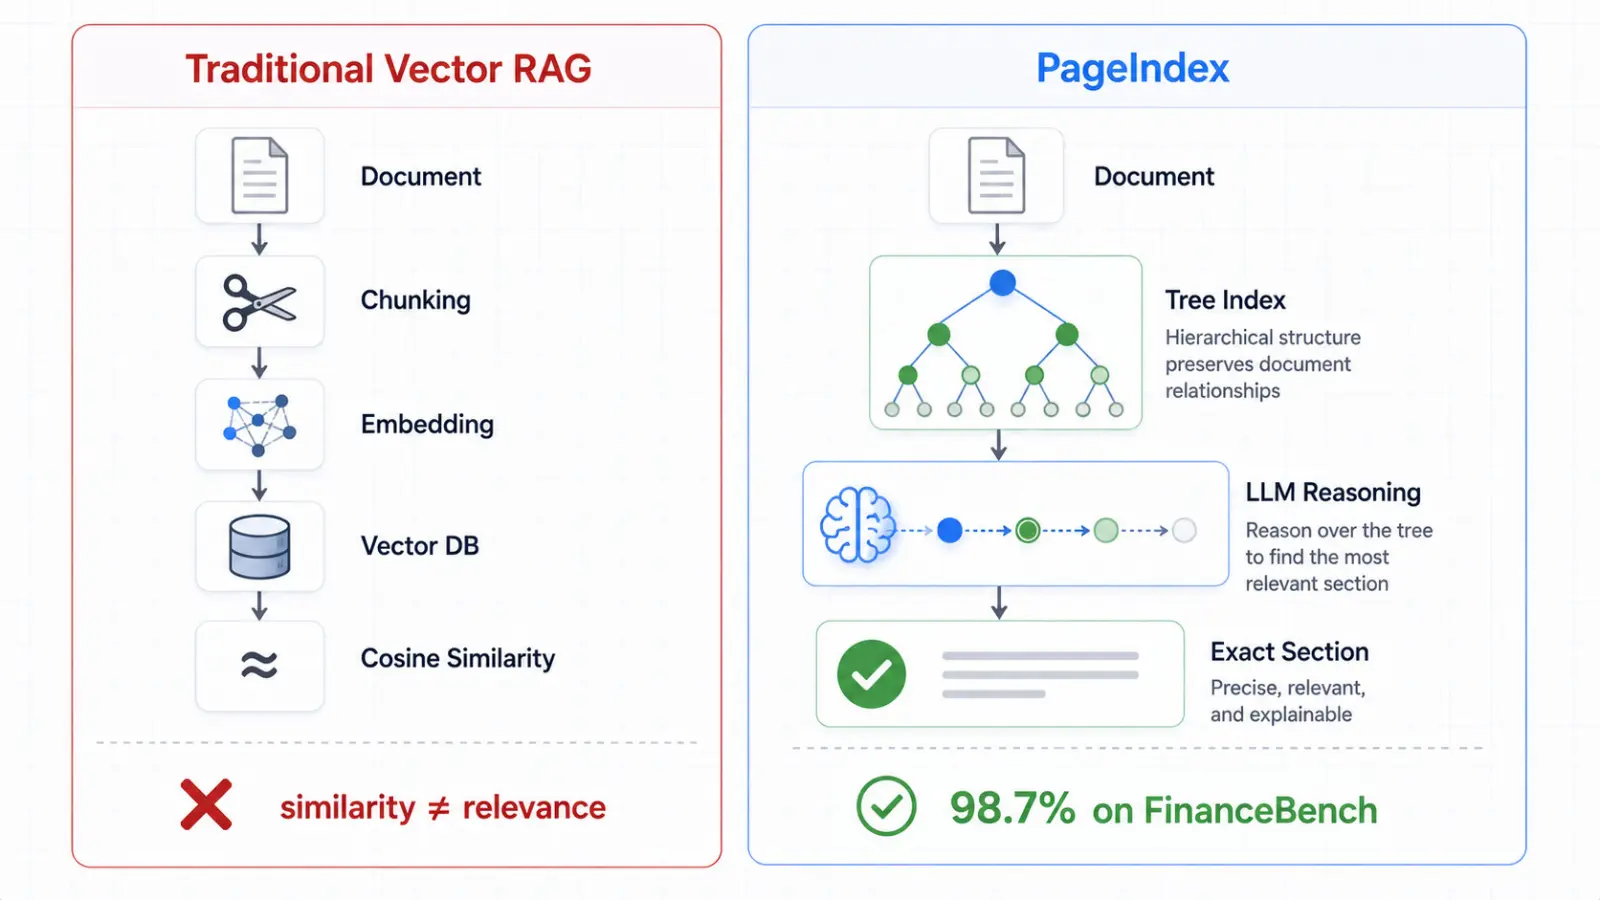
PageIndex 称自己是无向量、基于推理的 RAG。传统流程通常是:文档切块、向量化、写入向量数据库,查询时按相似度找最近的块。PageIndex 的流程是:先为文档生成树状索引,查询时由模型从根节点往下判断该走哪个分支,逐步缩小范围。
可以把它理解成翻财报的方式:先看目录,进到对应章节,再落到具体表格,而不是把每一页都扫一遍。官方也用 AlphaGo 的树搜索来类比:不穷举所有可能,而是沿着更有希望的路径深入。
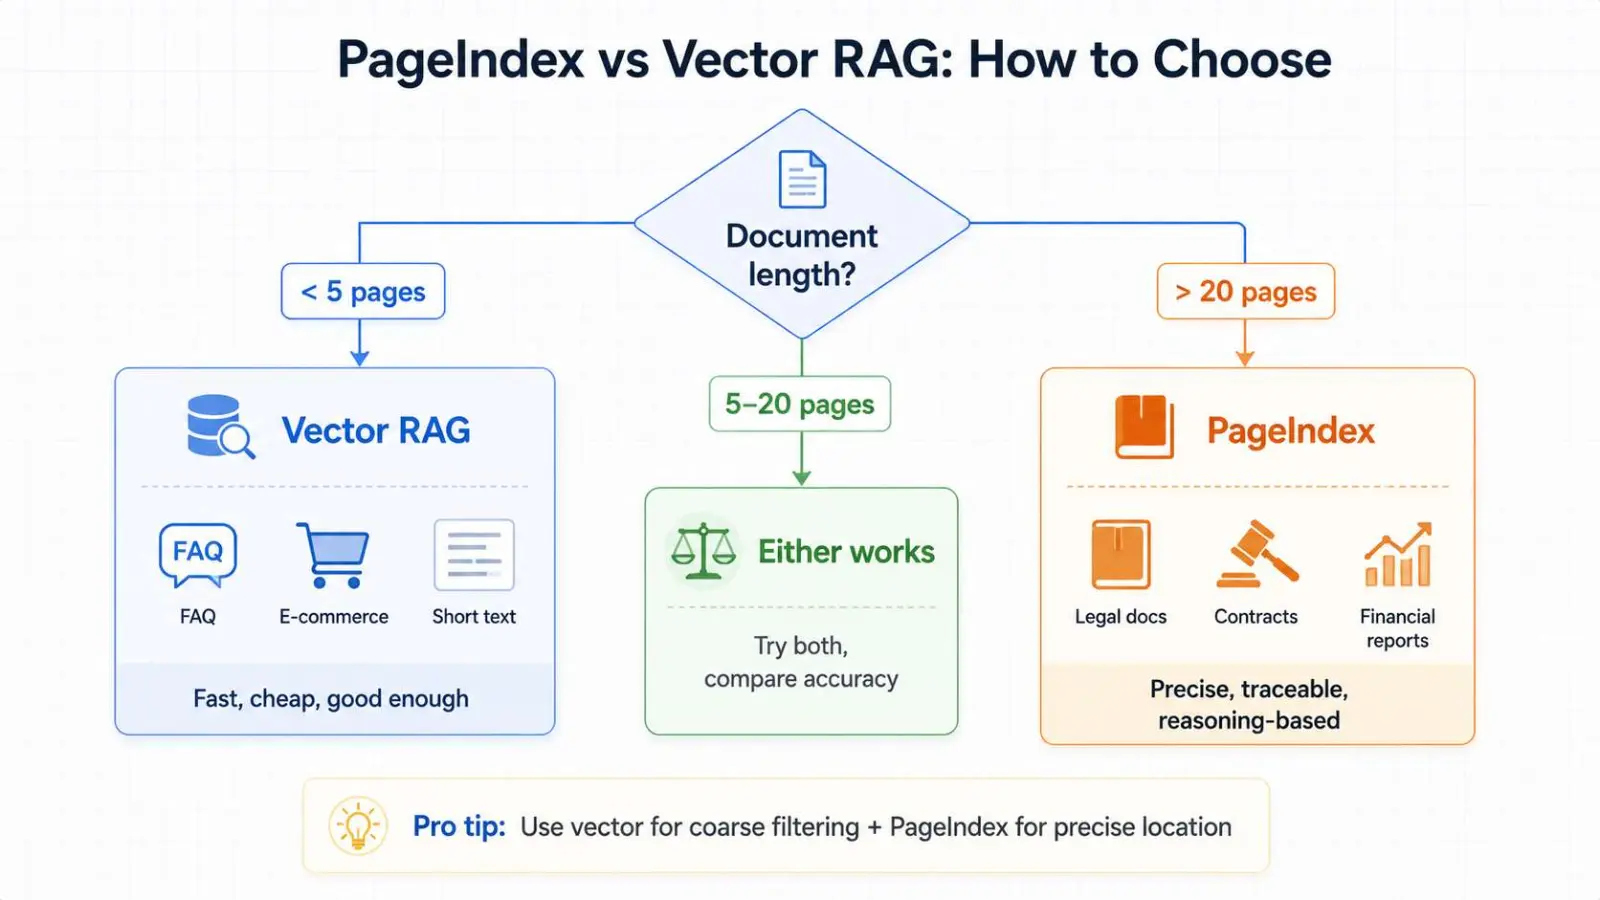
它更针对合同、财报、监管文件、技术手册这类结构清楚、需要精确定位的长文档。短文本、FAQ,或已经有成熟向量检索设施的团队,不一定非换这一套。
官方怎么验证效果
VectifyAI 在仓库和博客里公布:基于 PageIndex 构建的 Mafin 2.5,在 FinanceBench(从真实上市公司财报里回答具体问题的基准)上达到 98.7% 准确率,并开源了评估结果。FinanceBench 这类问题往往要定位到某个表格的某一行,同一份文件里“营收”“利润”“毛利”会反复出现,只靠向量相似度很容易走错章节。
需要分开看的是:98.7% 对应的是官方这篇评估里的 Mafin 2.5,而不是把开源 SDK 的每一次本地调用都等同于这个数字。完整数据和说明见 Mafin 2.5 评估仓库 和官方博客。
官方后来还做了另一组 Financial QA 基准,比较不同模型在 PageIndex 检索下的准确率和费用,细节在 pageindex-benchmarks。
怎么安装和调用
当前官方推荐用 Python SDK,不再需要先手动 clone 再装一长串依赖:
pip install -U pageindex
本地模式用你自己的模型密钥,在机器上建树、检索和问答。官方示例是:
import os
from pageindex import PageIndexClient

os.environ["OPENAI_API_KEY"] = "your-openai-key"

client = PageIndexClient(
    index="gpt-6-luna",
    chat="gpt-6-sol",
)
doc_id = client.submit_document("report.pdf")["doc_id"]

answer = client.chat("What was the 2023 operating margin?", doc_id=doc_id)
print(answer)
官方的模型建议是:建索引用基础模型就够,因为树结构主要来自文档版式,索引模型更多是做摘要和整理;真正沿树检索的 chat 模型,则尽量用更强的。仓库里也写了,如果已有 Claude 订阅,可以安装 pip install -U "pageindex[claude]",把模型名写成 claude-code/haiku、claude-code/opus 这种形式,走 Claude Code 的用量,不必再单独配 API Key。具体以当前文档为准。
树索引是一次性成本。官方本地基准给出的量级大约是每页 0.001 美元(索引模型用 gpt-5.6-luna 时),1000 页课本大概一美元出头、几分钟量级,之后的提问可以复用这棵树。索引时间随页数增加,同一组 9 到 1098 页的测试文档大约在 13 秒到 4.5 分钟。这些数字来自官方 README,实际费用取决于你用的模型和文档密度。
本地版和云服务怎么选
开源的本地模式适合文字型 PDF,以及希望索引留在自己机器上的工作流。PageIndex Cloud 则把解析、OCR、图像理解、树构建和存储放到云端,聊天和检索层仍然可以用你自己的模型。从本地切到云,主要是增加 PageIndex 的 API Key,并把 index 设为 cloud。
按官方对照表,有几处差别值得先看清楚:
| 项目 | 本地 | Cloud |
|---|---|---|
| 文档类型 | 文字型 PDF | 文字、扫描件和图像较多的文档 |
| 索引和存储 | 在你的机器上 | 由 PageIndex 托管 |
| 引用粒度 | 页级 | 块级 |
| OCR 与图像理解 | 无 | 有 |
| MCP server | 无 | 有 |
| 跨大量文档的 File System | 无 | 有 |
也就是说,把 PageIndex 接到 Claude Code 或 Cursor 的 MCP,目前属于云服务能力;把索引扩展到整个文档库、而不只是单份文件,也是云端的 PageIndex File System。在线文档分析入口是 app.pageindex.ai,开发者文档在 docs.pageindex.ai。
如果已经在用知识图谱路线整理仓库和笔记,可以对照graphify:把代码库、PDF 和笔记变成可提问的知识图谱。两者都想让 Agent 少翻无效内容,一条走图谱,一条走文档目录树,适用对象并不完全相同。
和向量 RAG 怎么搭配
向量检索并没有过时。短文本、FAQ、商品搜索这类“看起来像不像”就够用的场景,它通常更直接;团队如果已经有向量库,也不必为了换思路推倒重来。PageIndex 更适合结构清楚、需要精确定位到章节或表格的长文档。
官方也提到一种组合方式:先用向量检索做粗筛,再在留下的文档上用 PageIndex 做精确定位。选择时看的是文档类型,而不是哪个方案更新。
小结
PageIndex 没有在“切块加向量”上继续打补丁,而是换成目录树和沿树推理。本地 SDK 已经能用一行安装跑起来;要接 MCP、处理扫描件,或在整个文档库上检索,需要看云服务的能力边界。评估数字请以官方公布的方法和来源为准,不要把某一篇基准成绩直接当成自己这次调用的结果。
在 Claude Code 里查文档时如果要用到云端或其他模型接口,也可以先看AIGoCode 使用指南。