服务器半夜告警,SSH 上去看 top,CPU 不高;换 iostat,磁盘也正常;再翻 dmesg,一屏日志看不出问题。等你想起来看网络,那一波抖动早就过去了。
正规的监控方案通常是 Prometheus 加 Grafana:exporter 一个个装,抓取规则一条条写,仪表盘再一个个拼。一套下来要小半天,而常见的 15 秒采集间隔,照样会漏掉几秒钟的尖刺。
Netdata 是一个开源的实时监控工具,GitHub 上超过 8 万 star。它一条命令装好,自动发现几百个指标、每秒采集,仪表盘自动生成,还给每个指标训练异常检测模型。新版 Netdata Agent 内置了 MCP server,Claude Code 可以直接接入,在终端里问一句"这台机器刚才怎么了",它会自己去查指标。这篇文章介绍 Netdata 的安装、异常检测、Netdata MCP 接入 Claude Code 的方法,以及多台机器的部署方式。
Netdata 安装:装上就有仪表盘
Linux 上用官方的 kickstart 脚本安装。先把脚本下载到本地,再执行:
curl -o /tmp/netdata-kickstart.sh https://get.netdata.cloud/kickstart.sh
sh /tmp/netdata-kickstart.sh --release-channel stable
默认安装的是 nightly 版本,想要稳定版就加上 --release-channel stable。不想上报匿名统计,可以在执行脚本时设置环境变量 DISABLE_TELEMETRY=1。
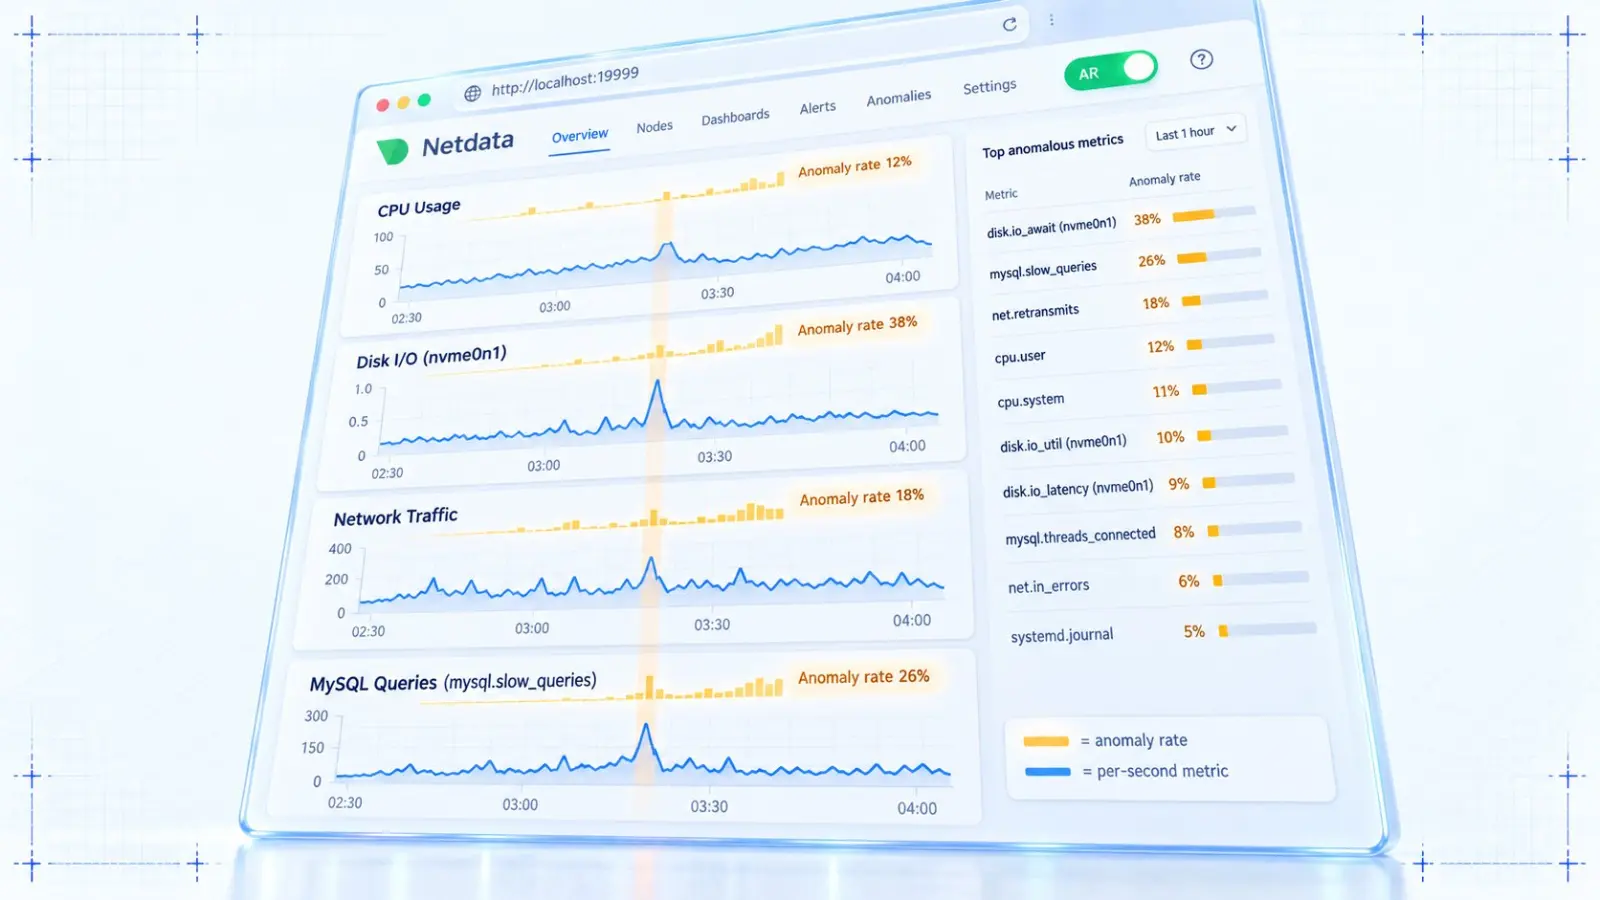
装完用浏览器打开 http://你的IP:19999,不需要任何配置,CPU、内存、磁盘、网卡、每个进程和每个容器的图表已经在实时刷新。机器上如果装了 nginx、MySQL、Redis、PostgreSQL,Netdata 会自动探测并生成对应的图表。
几个特点值得单独说:
- 每秒一个数据点。 很多监控 10 秒、15 秒采一次,一个持续三秒的 CPU 尖刺,在图上会被平均成一个不起眼的小鼓包。Netdata 每秒采集,尖刺是什么样就显示什么样。
- 不用写查询语句。 每张图都能按维度切分、按节点分组、框选时间段放大,不需要学 PromQL。
- 资源占用可控。 官方 README 给出的数据是:生产环境默认约 5% CPU、150MiB 内存;关闭 ML 和告警、使用临时存储时,可以降到 1% 以下 CPU、约 100MiB 内存。
数据默认存在本机,分三层:最近的数据按秒存,更早的按分钟,再往前按小时,缩放图表时自动切换。官方给出的平均存储开销约为每个样本 0.5 字节,磁盘给多大就存多久。
每个指标都有自己的异常检测模型
图表多了也是问题,一台机器几千条曲线,人盯不过来。
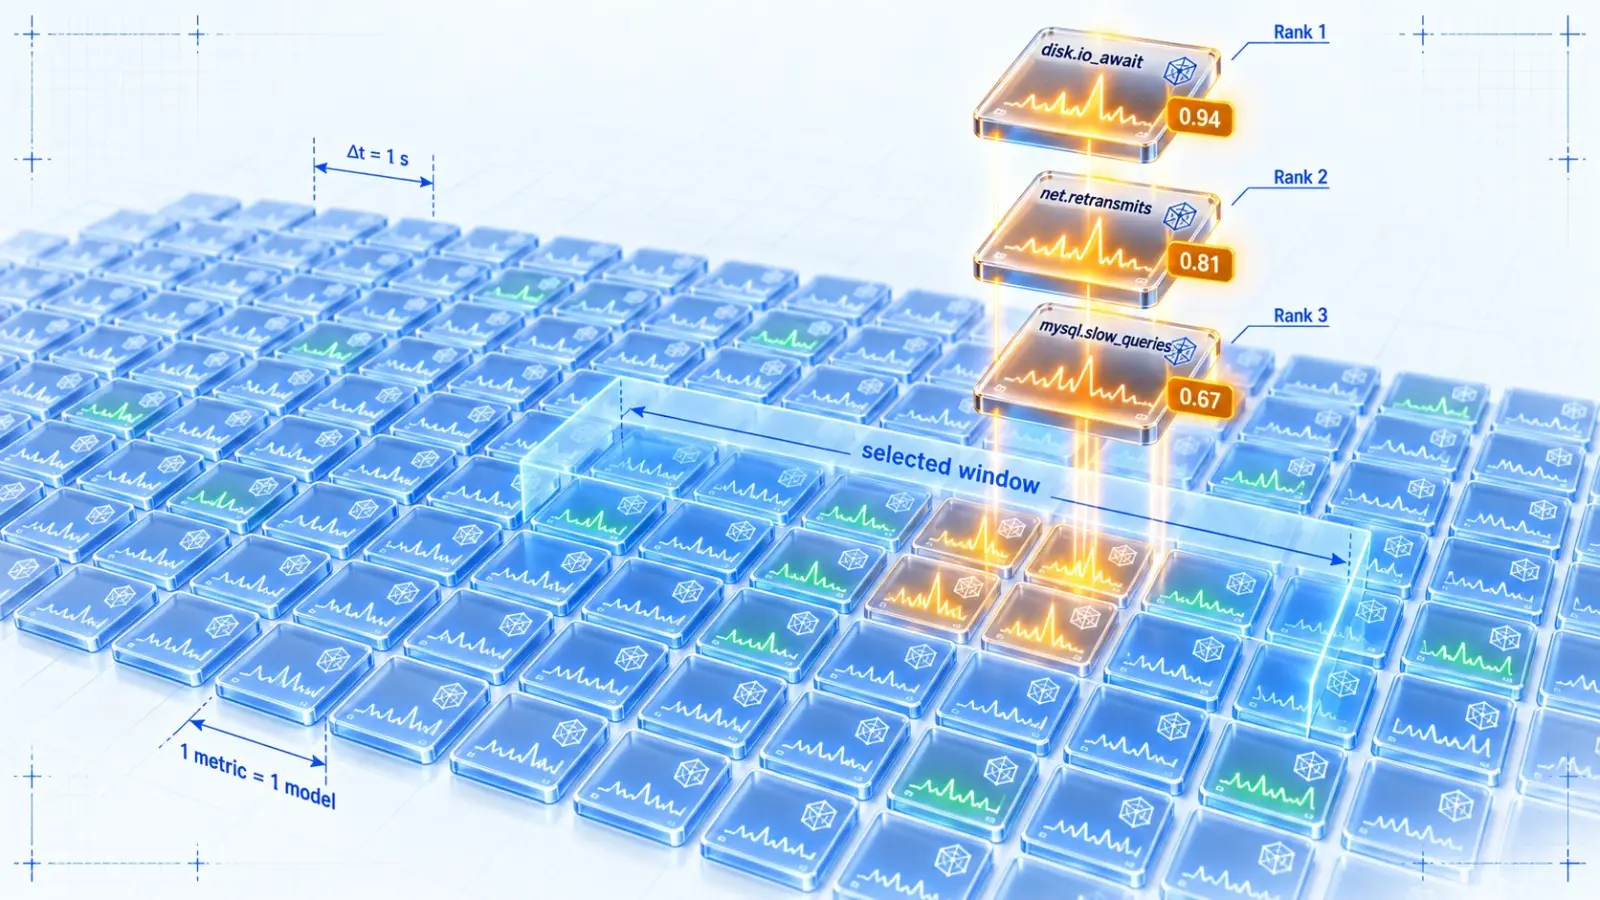
Netdata 在每台机器本地为每个指标单独训练一组无监督模型,学习这条曲线平时的样子。新数据进来时,模型判断它是否正常,并把结果作为异常标记和原始数据一起存储。
在仪表盘上打开 AR(Anomaly Rate)开关,每张图上方会多出一条异常率色带,哪个时间段、哪个指标不对劲,一眼就能看出来。
更实用的是反向排查:出问题时在时间轴上框选那一段,让 Netdata 按异常程度给所有指标打分排序,排在最前面的通常就是问题来源。过去要凭经验猜先看哪张图,现在它会直接给出排查顺序。
告警也是现成的,内置几百条规则,覆盖磁盘快满、内存紧张、网卡丢包等常见情况,通知可以发到邮件、Slack、Telegram、Discord、PagerDuty、Microsoft Teams 等渠道。
Netdata MCP 接入 Claude Code
这是 Netdata 和 AI 编程工具结合最紧密的部分。新版 Netdata Agent 自带 MCP server,地址是 http://你的IP:19999/mcp。根据官方文档,HTTP 和 SSE 方式直连需要 Netdata v2.7.2 及以上版本。
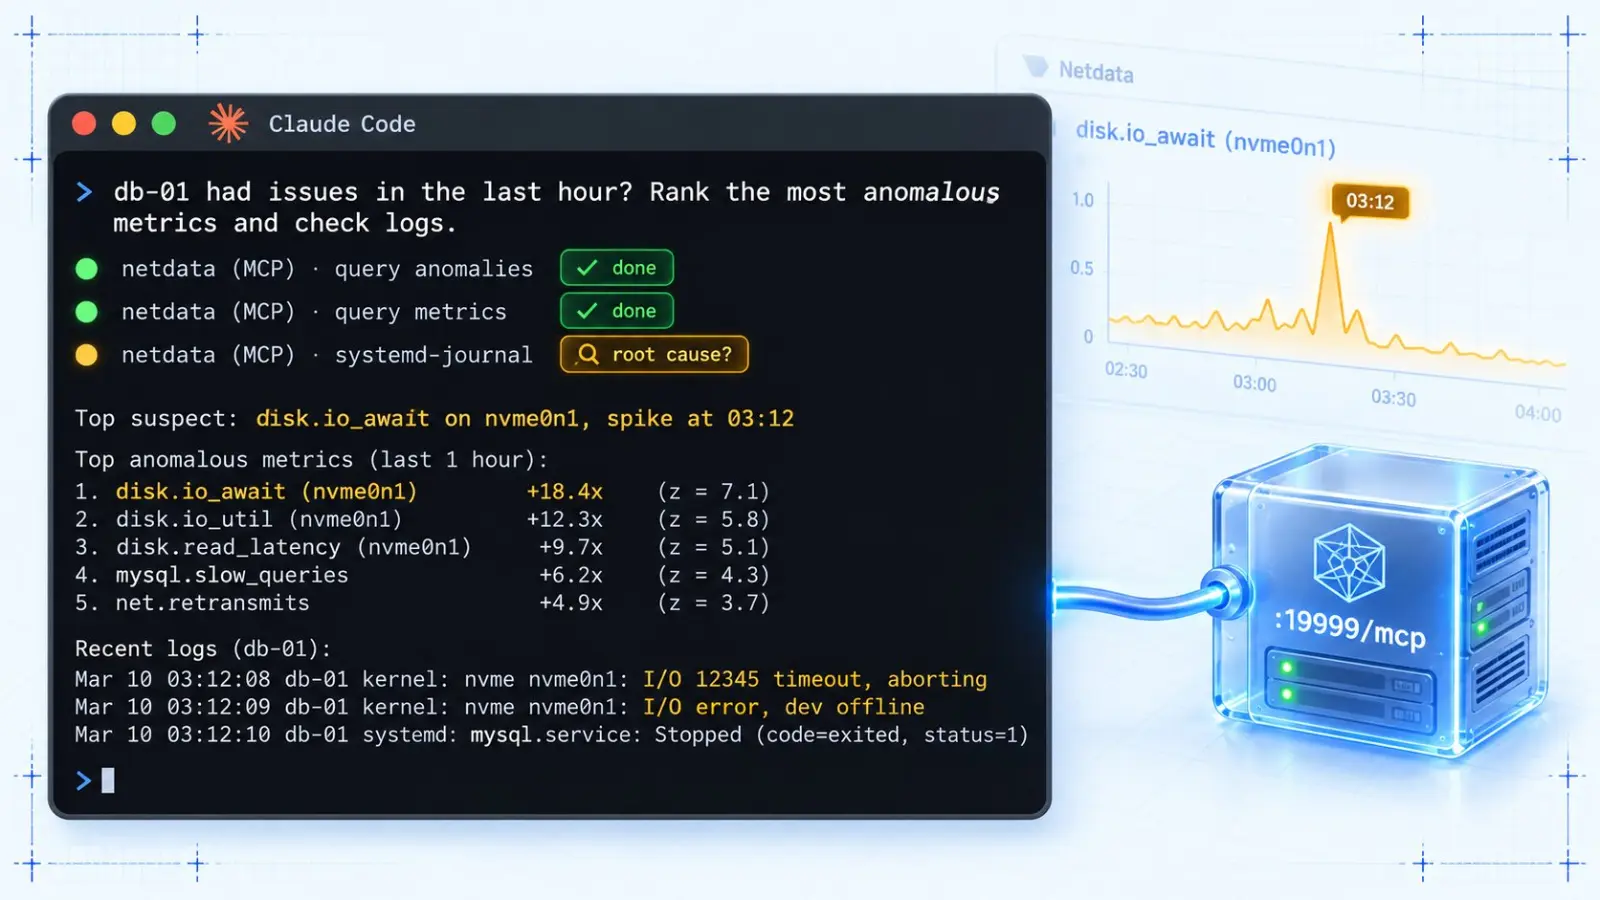
接入之后,AI 可以列出节点和指标、查询任意时间段的数据、查看告警历史、调用异常评分寻找根因;如果接的是 Parent 节点,还能查看 systemd journal 日志和进程列表。
MCP 的 API key 由 Netdata 启动时自动生成,存放在下面这个文件里:
sudo cat /var/lib/netdata/mcp_dev_preview_api_key
然后在 Claude Code 里添加 MCP server,把 key 填进请求头:
claude mcp add --transport http --scope user netdata \
  http://你的IP:19999/mcp \
  --header "Authorization: Bearer 上一步拿到的key"
重新打开一个会话,就可以这样提问:
db-01 这台机器过去一小时有没有异常?如果有,按异常程度列出最可疑的几个指标,再看看同一时间段的日志。
顺利的话,Claude Code 会先调用异常评分挑出可疑指标,再拉取具体数据,最后对照同一时间段的日志。过去要开好几个终端来回切的排查流程,现在你只需要提问,再判断它的结论是否可靠。数据库也可以用类似思路接给 AI,例如 Codex 连数据库怎么防误写?用 MCP Toolbox 只读工具加 writes 审批 介绍的只读工具方案。
只支持 stdio 的客户端(如部分版本的 Claude Desktop、Cursor),可以用 npx mcp-remote 或 Netdata 自带的 nd-mcp 做桥接。
接入前有两点要提前知道:
- 查看日志、进程列表这类敏感操作需要带 key,而这个 key 需要节点关联 Netdata Cloud 后才生效,Cloud 提供免费档。
- MCP 和仪表盘共用 19999 端口。机器在公网上时,记得在
netdata.conf里限制来源:
[web]
    allow mcp from = 10.* 192.168.* localhost
机器多了怎么部署:Parent-Child 与 Netdata Cloud
一台台打开 19999 端口去看,五台以内还行,再多就乱了。
Netdata 的做法是 Parent-Child:每台机器照常安装 Agent,再选一台作为 Parent,其他机器把数据实时推送过去。Parent 上可以查看所有子节点的图表,统一管理告警,数据也能在 Parent 上保留更久;子节点可以只在内存里保留数据,几乎不写盘,适合配置很低的小机器。
想跨机房、跨云查看全局,可以连接 Netdata Cloud。它不存储你的指标数据,而是把各个 Agent 串起来,打开网页时实时从各节点拉取。
如果已经有现成的监控体系,Netdata 也能把数据导出到 Prometheus、InfluxDB、Graphite 等系统,不用二选一。
Netdata 和 Prometheus + Grafana 怎么选
| 对比项 | Netdata | Prometheus + Grafana |
|---|---|---|
| 上手成本 | 一条命令安装,自动发现指标 | 需要逐个配置 exporter、抓取规则和仪表盘 |
| 采集精度 | 默认每秒采集 | 常见配置为 10–15 秒 |
| 异常检测 | 内置每指标 ML 模型和异常排序 | 需要自行搭建 |
| 查询灵活度 | 图表交互为主 | PromQL 灵活,生态成熟 |
| AI 接入 | 内置 MCP server | 需要另找方案 |
大团队已经建好的 Prometheus 体系没必要推倒重来,两套并行完全可以。另外要注意授权方式:Netdata Agent 本体是 GPLv3+ 开源,仪表盘前端(Netdata UI)闭源但免费使用,介意这一点的需要提前了解。
总结
如果你手上有几台云服务器、NAS 或者家里的 homelab,平时出问题全靠 SSH 上去猜,Netdata 值得花十分钟装上:每秒采集、自动仪表盘和异常排序已经能省掉不少排查时间。再把 Netdata MCP 接进 Claude Code,下次机器出问题,可以先让它查一遍指标和日志,你再根据结果做判断。
想在国内稳定使用 Claude Code 做这类运维排查,可以在 AIGoCode 上直接接入。
参考链接
- Netdata GitHub 仓库:https://github.com/netdata/netdata
- Netdata 官方文档:https://learn.netdata.cloud
- Netdata MCP 接入文档:https://learn.netdata.cloud/docs/netdata-ai/mcp