搭过 Agent 的人,多半都被上下文折磨过。记忆散在代码里,知识塞在向量库里,技能又是另一套零件;长任务每一步都在产上下文,要么硬截断丢信息,要么一股脑塞进去烧 token。出错时更烦:传统 RAG 那条检索链像黑盒,返回错了你很难知道它为什么这么选。
火山引擎(字节)开源的 OpenViking,定位是专门给 AI Agent 用的上下文数据库。它不把记忆、知识和技能拆成互不相干的系统,而是用虚拟文件系统把它们统一挂在 viking:// 目录树下,让 Agent 像 ls、tree、read、grep 那样浏览和按需加载。GitHub 仓库超过 4 万 star,协议是 AGPL-3.0。
这篇讲它解决什么、几个关键设计、怎么装和常用命令,以及什么场景值得上、什么场景不必上。
OpenViking 解决的是哪一层问题
一句话:让你像管本地文件一样管 Agent 的「大脑」。
传统 RAG 常见路径是切块、向量化、相似度检索。结构偏平,缺少全局目录视角,检索过程也不容易观察。OpenViking 换成文件系统范式:资源、记忆、技能都挂在有路径、有层级的树上,目录自带摘要,Agent 可以先扫概要,再决定读哪一层细节。
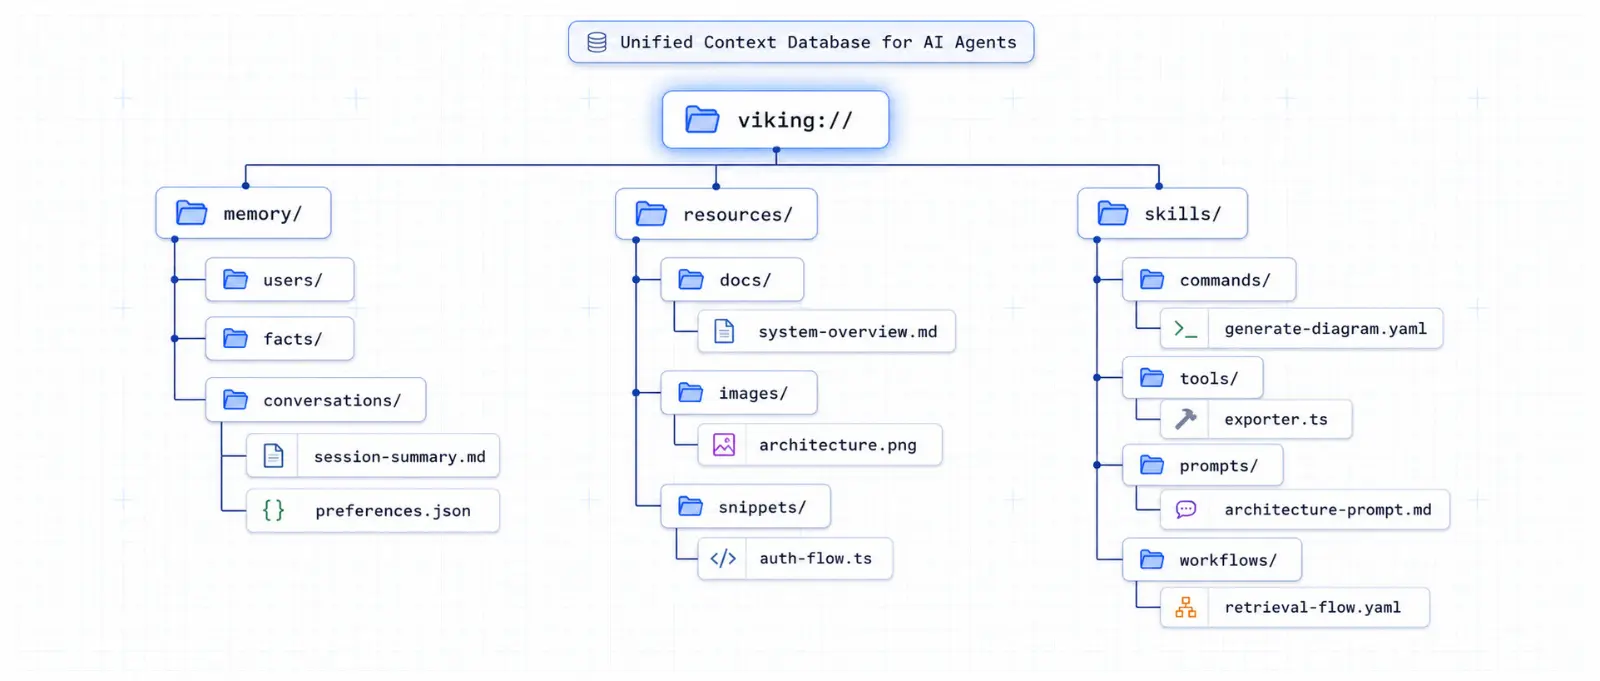
这个转变的意义在于,上下文从「一堆算好相似度的向量」变成「一个能看懂、能调试的目录」。如果你同时在用 Mem0 或 claude-mem 这类记忆层,可以把 OpenViking 理解成更偏「上下文基础设施」的一档:不只记对话,还把知识资源和技能放进同一套可导航的空间。
几个关键设计
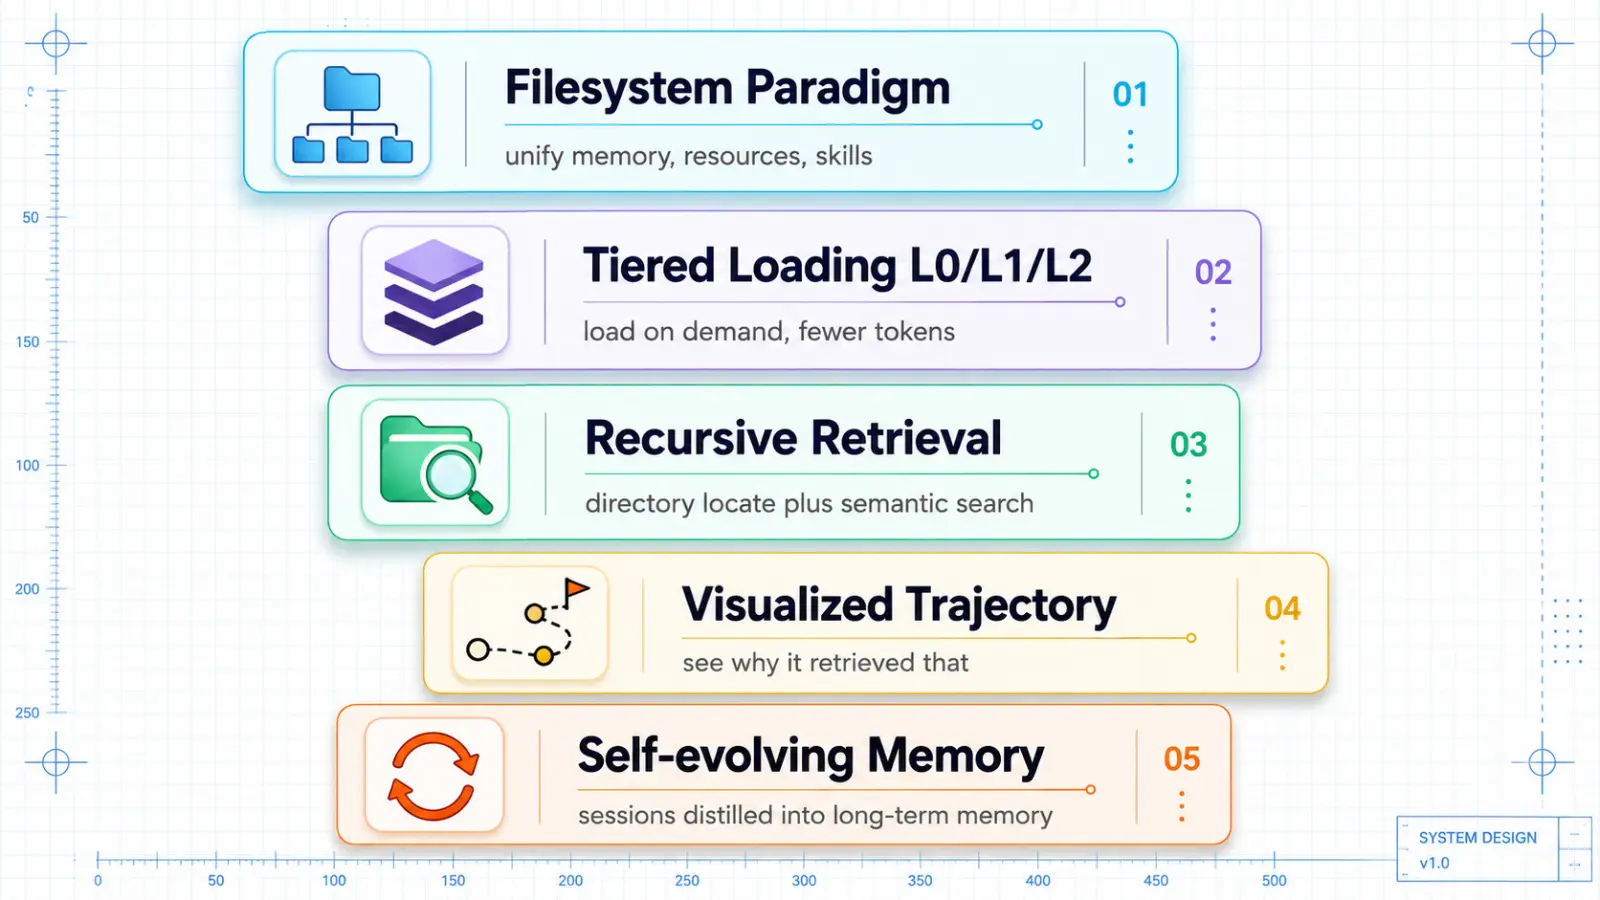
文件系统范式。 记忆、资源、技能统一到一套目录结构,管理方式回到路径和层级,而不是散落在多个黑盒里。
分层加载,省 token。 上下文按 L0 / L1 / L2 分层,先给概要,需要细节再往下取,避免每次把全部内容灌进模型。
目录递归检索。 先沿目录树缩小范围,再在范围内做语义匹配。官方把它和传统平铺向量检索区分开,强调「目录定位 + 语义搜索」。
检索轨迹可观测。 能把检索走过的目录路径呈现出来,出错时更容易看到偏在哪一步。
会话与记忆整理。 对话、资源引用和工具调用可以压缩、抽取成长期记忆;新版本还提供整理已有记忆的命令入口。
怎么安装和初始化
官方提供 Python 包和 CLI。当前主包版本可直接升级安装:
pip install --upgrade 'openviking==0.5.4' 'openviking-sdk==0.1.19'
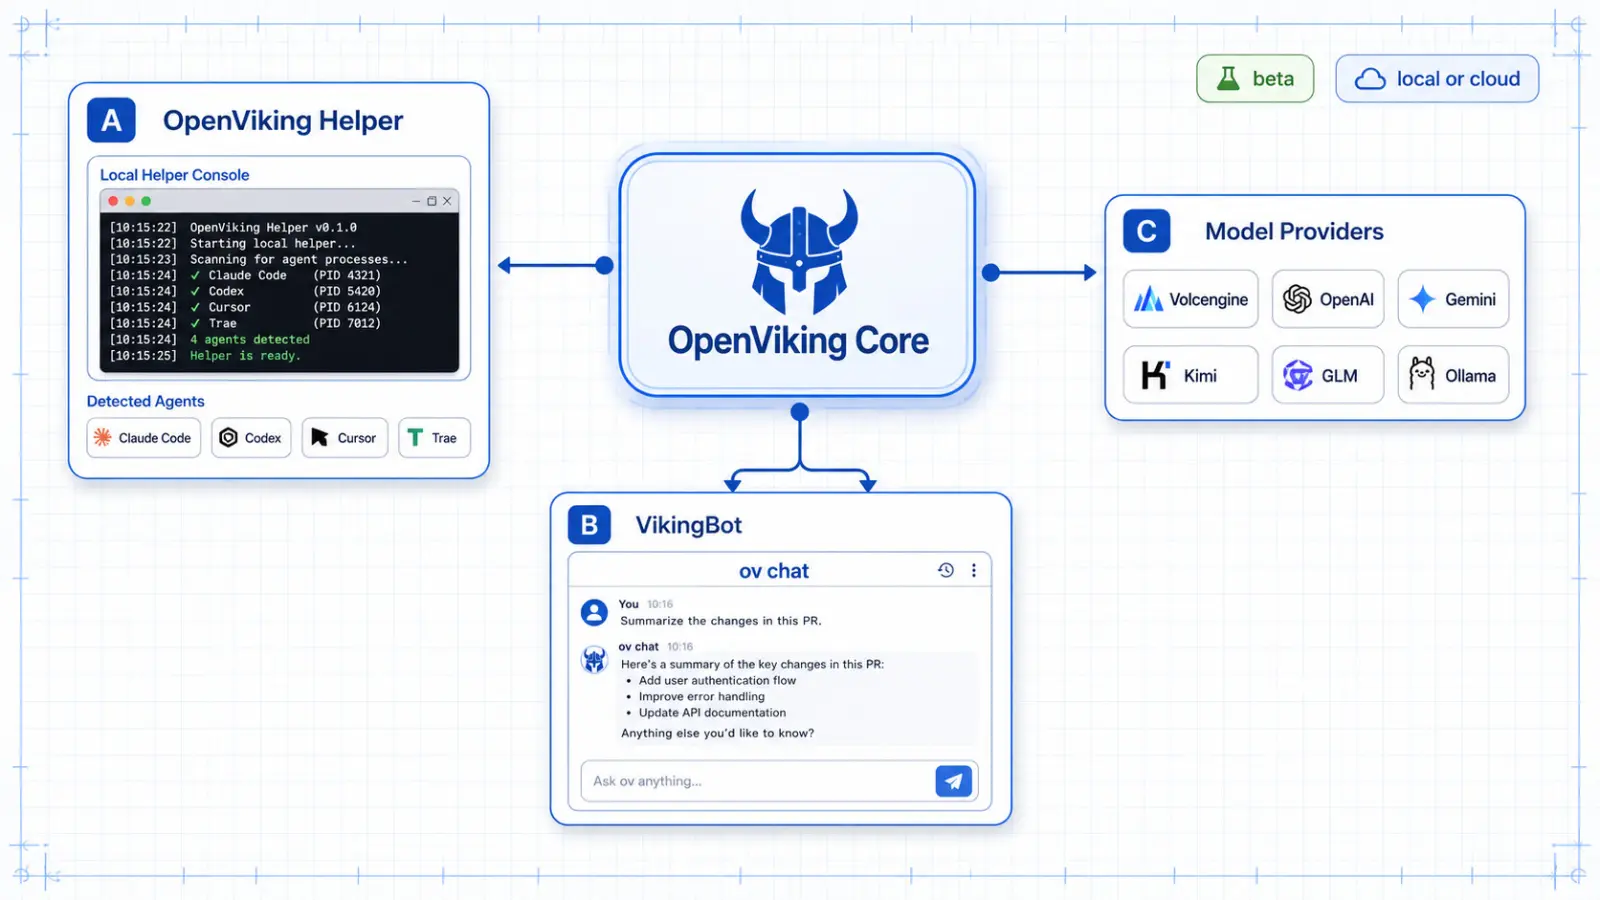
它需要两类模型能力:一个做内容理解(含图像场景),一个做 Embedding。模型侧比较开放,火山豆包、OpenAI、Gemini、Kimi、GLM,以及 Ollama 本地模型都在文档支持范围内。
第一次建议走交互式初始化,并做健康检查:
openviking-server init
openviking-server doctor
doctor 会检查配置、Python 版本、模型连通性和磁盘空间等前置条件。也可以使用火山引擎托管的 OpenViking 服务;自建和托管的取舍看你是否要数据完全落本地。
常用命令:像文件系统一样操作上下文
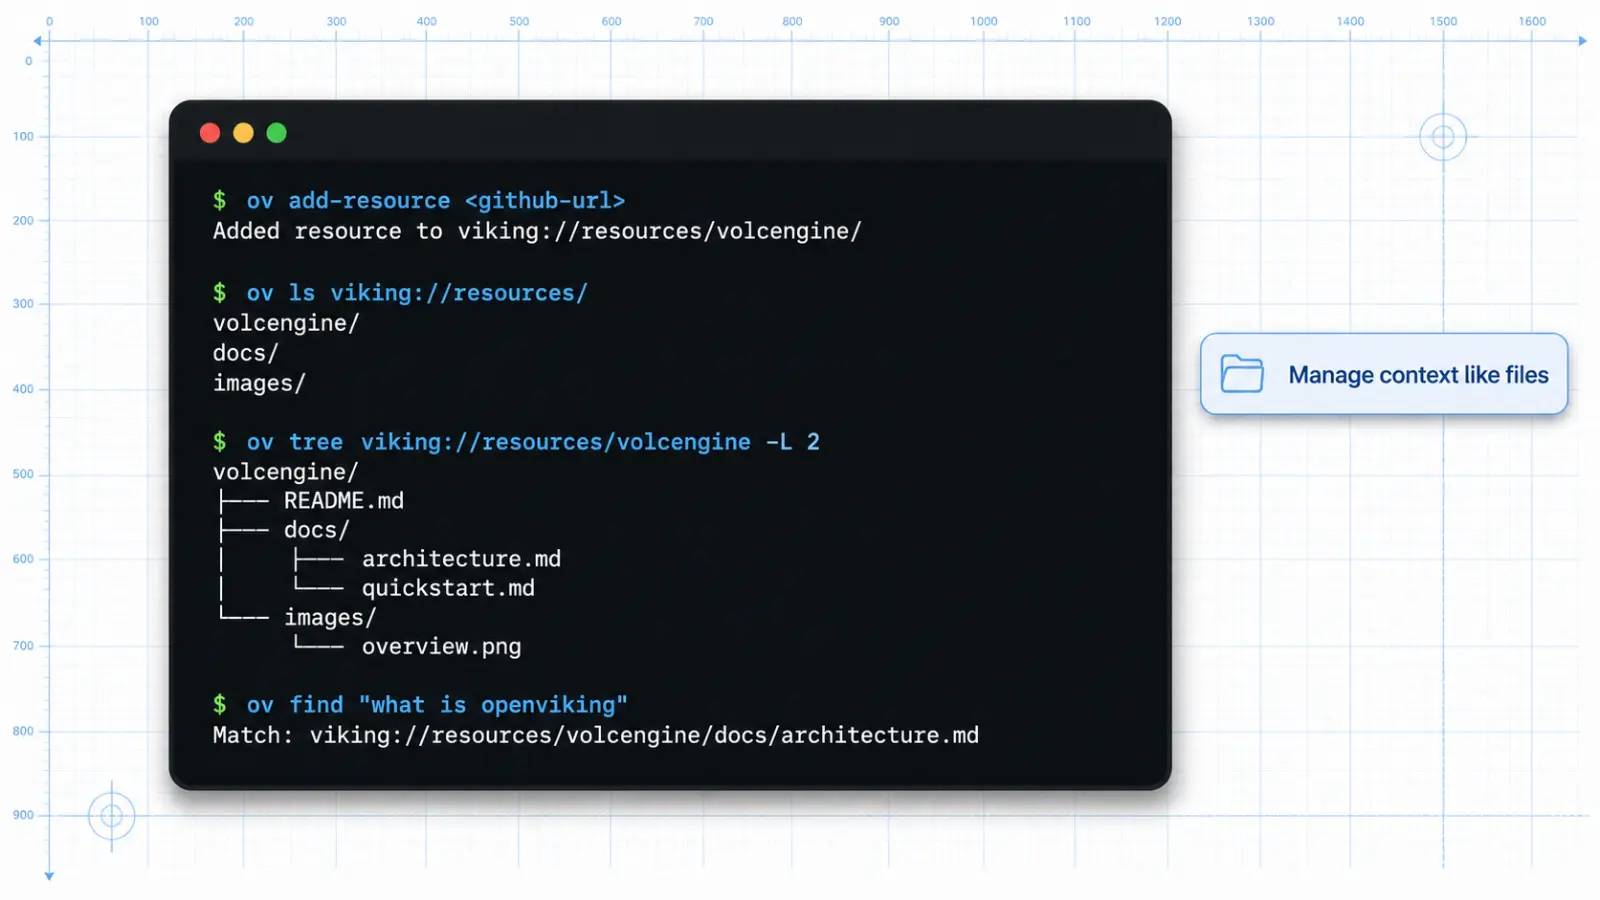
服务跑起来之后,ov CLI 的操作风格接近日常文件命令:
把 add-resource 返回的 task_id 代入下一行的 TASK_ID,查到 completed 再继续:
openviking-server
ov status
ov add-resource https://github.com/volcengine/OpenViking
ov task status TASK_ID
ov ls viking://resources/
ov tree viking://resources/volcengine -L 2
ov find "what is openviking"
ov grep "openviking" --uri viking://resources/volcengine/OpenViking/docs/en
add-resource 可以直接吃 GitHub 仓库链接,把仓库做成可导航的上下文,对代码类 Agent 很方便。
配套:Helper 桌面端和 VikingBot
除了核心库,仓库还提到两个配套方向。
OpenViking Helper 是桌面控制台(macOS / Windows),用来看本地 Agent 配置、会话轨迹、记忆和技能;文档说明它能探测 Claude Code、Codex、Cursor、Trae、OpenCode 等,并把本地 SKILL.md 与记忆同步进 OpenViking(当时标注为 beta)。
VikingBot 是建在 OpenViking 之上的 Agent 框架。装上 bot 额外依赖后,可以用 ov chat 开一个带完整上下文能力的对话 Agent:
在一个终端启动带 bot 的服务,再开另一个终端进入对话:
pip install "openviking[bot]"
openviking-server --with-bot
ov chat
适合什么场景,什么时候不必上
适合:需要长期记忆的 Agent;知识库检索经常不准、想要能调试的检索链;跨多文档、多轮对话攒上下文的任务。分层加载和目录检索在这些场景里更有发挥空间。
不必强上:只做简单 FAQ,传统向量 RAG 通常就够;也不想在上下文管理上投入配置和目录建模成本时,先别把它当默认答案。
另外它是大厂开源项目,文档和版本迭代都活跃,但 AGPL-3.0 对二次分发有更强约束,商用嵌入前先让法务看过协议。
小结
RAG 和 Agent 记忆这两年方案很多,但不少仍在切块 + 向量的框架里打转。OpenViking 用文件系统重新组织上下文,把黑盒检索变成能看、能调的目录操作。如果你正在搭 Agent、被上下文管理拖慢,值得把仓库和官方文档认真过一遍。
需要把模型接到统一的 API 入口时,也可以在 AIGoCode 上选用合适的分组,再把 Agent 侧的上下文层交给 OpenViking 这类组件。
参考链接
- GitHub:https://github.com/volcengine/OpenViking
- 官网 / Studio:https://openviking.ai