2026 年 11 月 16 日,腾讯混元发布了最新的语言模型 Hy4 flash。距离 11 月 4 日的旗舰 Hy4 发布不到两周,这次的主角是一款主打速度和成本的轻量模型。
按腾讯官方的说法,Hy4 flash 是"迄今为止最高性价比的 Hy 模型":总参数 224B(其中 64B 是 Engram 参数),每个 token 只激活 12B,支持多模态输入和 1M 上下文;API 价格为每百万 tokens 输入 0.5 元、输出 2 元,命中缓存时只要 0.02 元,比 Hy4 低了一个数量级。
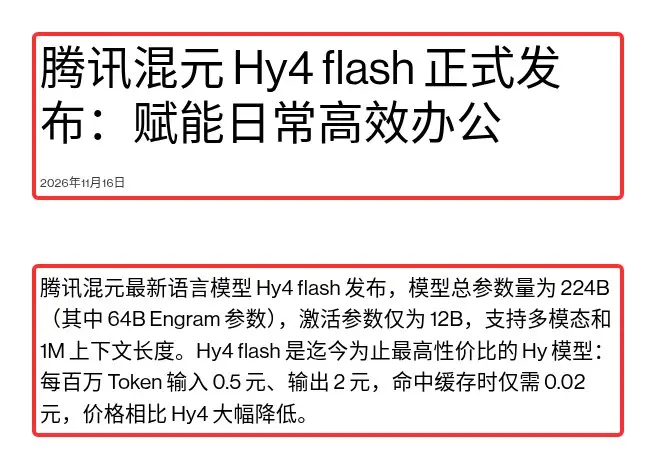 图 1:腾讯官网新闻《腾讯混元 Hy4 flash 正式发布:赋能日常高效办公》。上方红框是标题和发布日期 2026 年 11 月 16 日;下方红框是核心参数和价格:总参数 224B(含 64B Engram 参数)、激活 12B、1M 上下文,每百万 Token 输入 0.5 元、输出 2 元、缓存命中 0.02 元。
一、Hy4 flash 是什么定位
混元团队对 Hy4 系列的分工说得很直接:
| 模型 | 官方推荐的用途 |
|---|---|
| Hy4 flash | 大部分日常任务:深度搜索、文档处理、PowerPoint 生成、简单的前端展示、Computer Use(电脑操作)等 |
| Hy4 | 智能上限更高,适合长程软件工程这类复杂任务 |
腾讯云 TokenHub 的模型页对 Hy4 flash 的介绍是:参数量约为旗舰的四分之一,定价更便宜,在日常任务上达到旗舰开源模型的水平,适合编程辅助、Agent 工作流、文档与图表理解、日常办公等高频、规模化的场景。
换句话说,Hy4 flash 不是用来冲击榜单上限的,它要解决的是"每天大量跑的任务,怎样又快又便宜地做好"。
二、官方怎么把成本降下来
官方发布文从预训练、后训练、评估、推理四个阶段介绍了 Hy4 flash 的做法:
- 预训练:加入混合注意力、LatentMoE、Engram 等架构特性。KV cache 大小只有 Hy3 的 1/24、Hy4 的 1/6,并通过大量 scaling ladder 实验确认效果符合预期。
- 后训练:先通过自蒸馏 Hy4 获得较强的综合能力,再用强化学习把端到端任务的输出长度降低 50%。
- 评估:基于 WorkBuddy 的典型任务构建内部评测集 WorkIndex,并结合人工评测,关注日常工作的产物效果、单轮输出长度和端到端用时,而不是远离日常工作的公开榜单分数。
- 推理:结合 megakernel、4bit 量化、DFly 等手段做优化,解码速度超过 150 tokens/秒,可以大规模、低成本地部署。
其中"输出长度降低 50%"和"KV cache 缩小"这两点直接影响实际花费:输出 token 少了,单次任务的费用和等待时间都会下降;KV cache 小了,长上下文的部署成本也更低。
三、官方公布的评测和成本数据
以下数据均来自腾讯官方发布文,为官方自测结果。
和前代模型比
官方称,Hy4 flash 的综合效果略优于参数更大的 Hy4 preview(总参数 770B、激活 49B),但成本显著降低。按 WorkIndex 综合测算,Hy4 flash 的单任务成本只有 Hy4 preview 的 1/13、Hy4 的 1/20,以及 DeepSeek-V4.1-Flash-1017(Max 档位、忙时价格)的 1/8。
WorkIndex 包含 8 个内部评测集:PowerPoint 制作、PowerPoint 修改、PowerPoint 人机双写、Markdown 人机双写、文档编辑、表格修复、音视频处理和视觉理解。
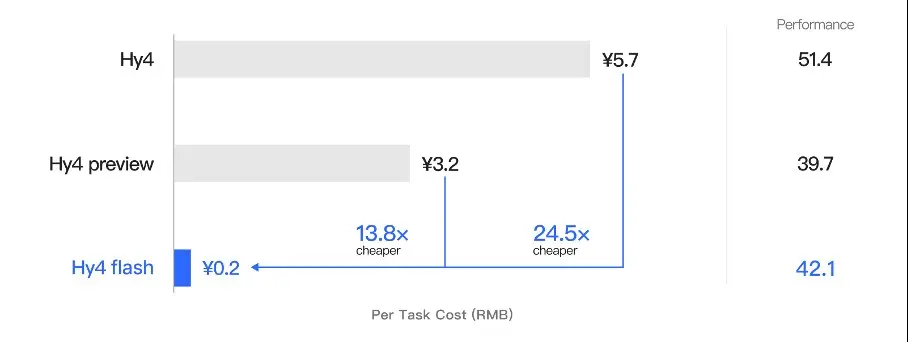 图 2:腾讯官方发布文中的 WorkIndex 成本对比。Hy4 flash 单任务成本约 0.2 元、得分 42.1;Hy4 preview 约 3.2 元、得分 39.7;Hy4 约 5.7 元、得分 51.4。图中标注 Hy4 flash 比 Hy4 preview 便宜 13.8 倍、比 Hy4 便宜 24.5 倍。
内部评测和公开 Agent 评测的成本—效果分布
官方还给出了一张对比图:左边是内部的 WorkIndex,右边是 7 个公开 Agent 评测集(DeepSWE、ProgramBench、Terminal-Bench 4.0、APEX-Agents、AutomationBench、HLE、OSWorld 2.1)的综合结果,横轴是单任务成本(人民币,对数刻度),纵轴是得分。
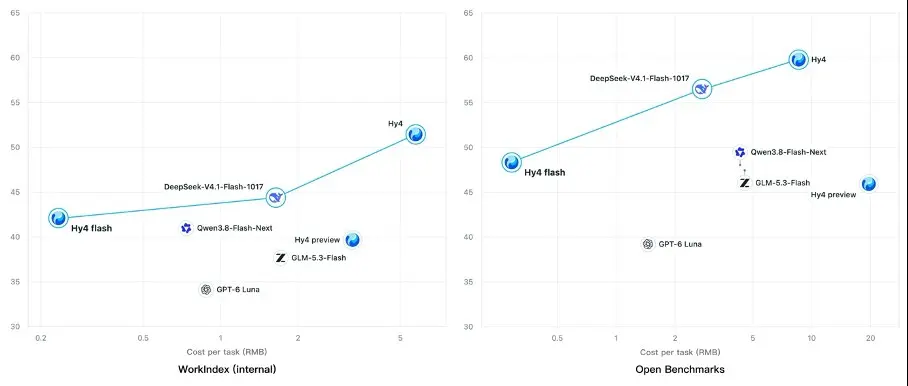 图 3:腾讯官方发布文中的"内外部任务上的性能和成本"。在两组评测里,Hy4 flash 都位于成本最低的一端;公开 Agent 评测上,得分最高的是 Hy4,Hy4 flash 的单任务成本明显低于 DeepSeek-V4.1-Flash-1017、Qwen3.8-Flash-Next、GLM-5.3-Flash 和 GPT-6 Luna。
从图上看,在公开 Agent 评测里 Hy4 flash 的得分低于 Hy4 和 DeepSeek-V4.1-Flash-1017,这也和官方"复杂的长程软件工程任务用 Hy4"的建议一致。
用户盲测
腾讯邀请内部 85 位 WorkBuddy 用户,在 27 类、共 259 个任务上做了盲测。官方结论是:Hy4 flash 的用户满意度接近 Claude Haiku 5.5,单任务成本显著低于其他所有参测模型,任务时长也最短。
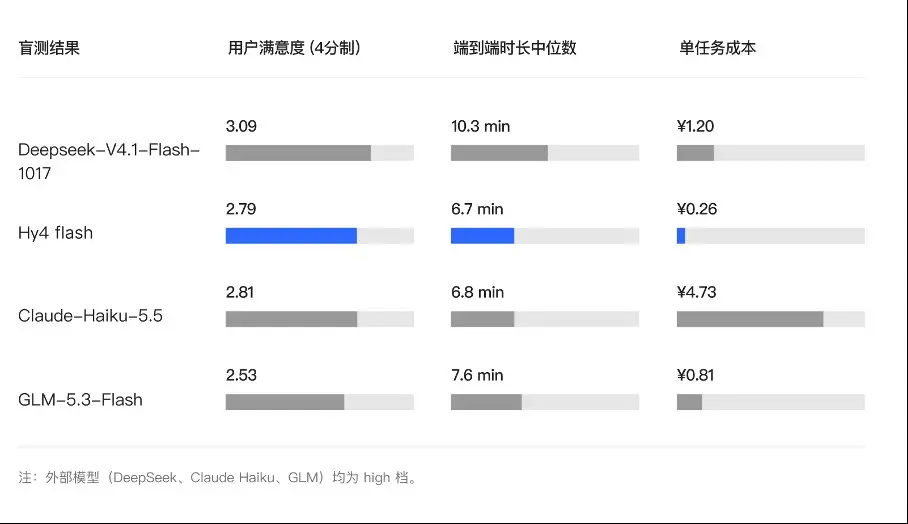 图 4:腾讯官方发布文中的盲测结果(4 分制满意度、端到端时长中位数、单任务成本)。Hy4 flash 满意度 2.79、时长 6.7 分钟、单任务成本 0.26 元;Claude Haiku 5.5 分别为 2.81、6.8 分钟、4.73 元;DeepSeek-V4.1-Flash-1017 为 3.09、10.3 分钟、1.20 元;GLM-5.3-Flash 为 2.53、7.6 分钟、0.81 元。注:外部模型均为 high 档。
四、价格
Hy4 flash 的标准价格如下(每百万 tokens):
| 计费项 | 人民币 | 美元(官方英文版) |
|---|---|---|
| 输入 | 0.5 元 | 约 $0.070 |
| 输出 | 2 元 | 约 $0.281 |
| 缓存命中 | 0.02 元 | 约 $0.003 |
和 Hy4 比,三项价格分别是 Hy4 的 1/12(输入)、1/9(输出)和 1/15(缓存命中)。
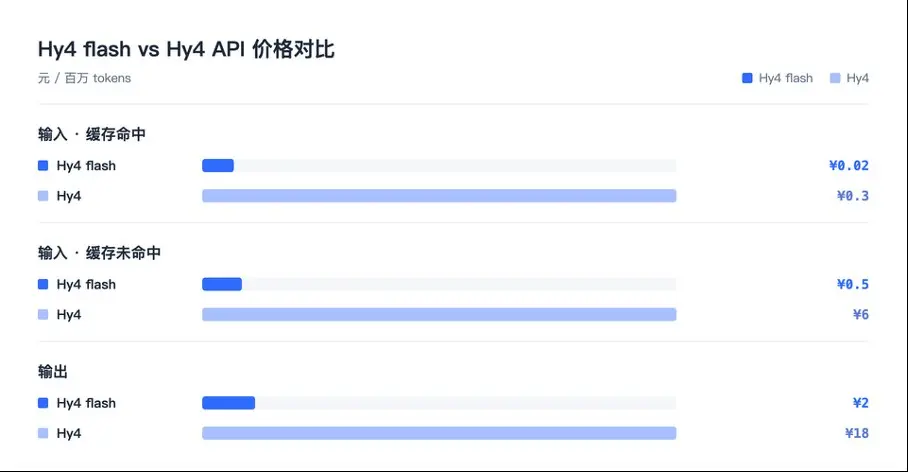 图 5:腾讯官方发布文中的"Hy4 flash vs Hy4 API 价格对比"(元/百万 tokens):缓存命中 0.02 元 对 0.3 元,缓存未命中输入 0.5 元 对 6 元,输出 2 元 对 18 元。
限时优惠:11 月 30 日前,WorkBuddy 用户可以限时免费使用 Hy4 flash;腾讯云 TokenHub API 限时 5 折,折后为输入 0.25 元、输出 1 元、缓存命中 0.01 元(每百万 tokens)。
五、规格和接口
腾讯云 TokenHub 模型页公布的规格:
| 项目 | 官方数值 |
|---|---|
| 模型 ID | hy4-flash |
| 输入类型 | 文本、图片 |
| 输出类型 | 文本 |
| 上下文窗口 | 1024K |
| 最大输入 | 960K tokens |
| 最大输出 | 64K tokens |
| 速率上限 | TPM 10,000,000,RPM 300 |
| 模型能力 | 深度思考、Function Calling、结构化输出、缓存 |
| 调用协议 | Chat Completions、Responses、Anthropic Messages |
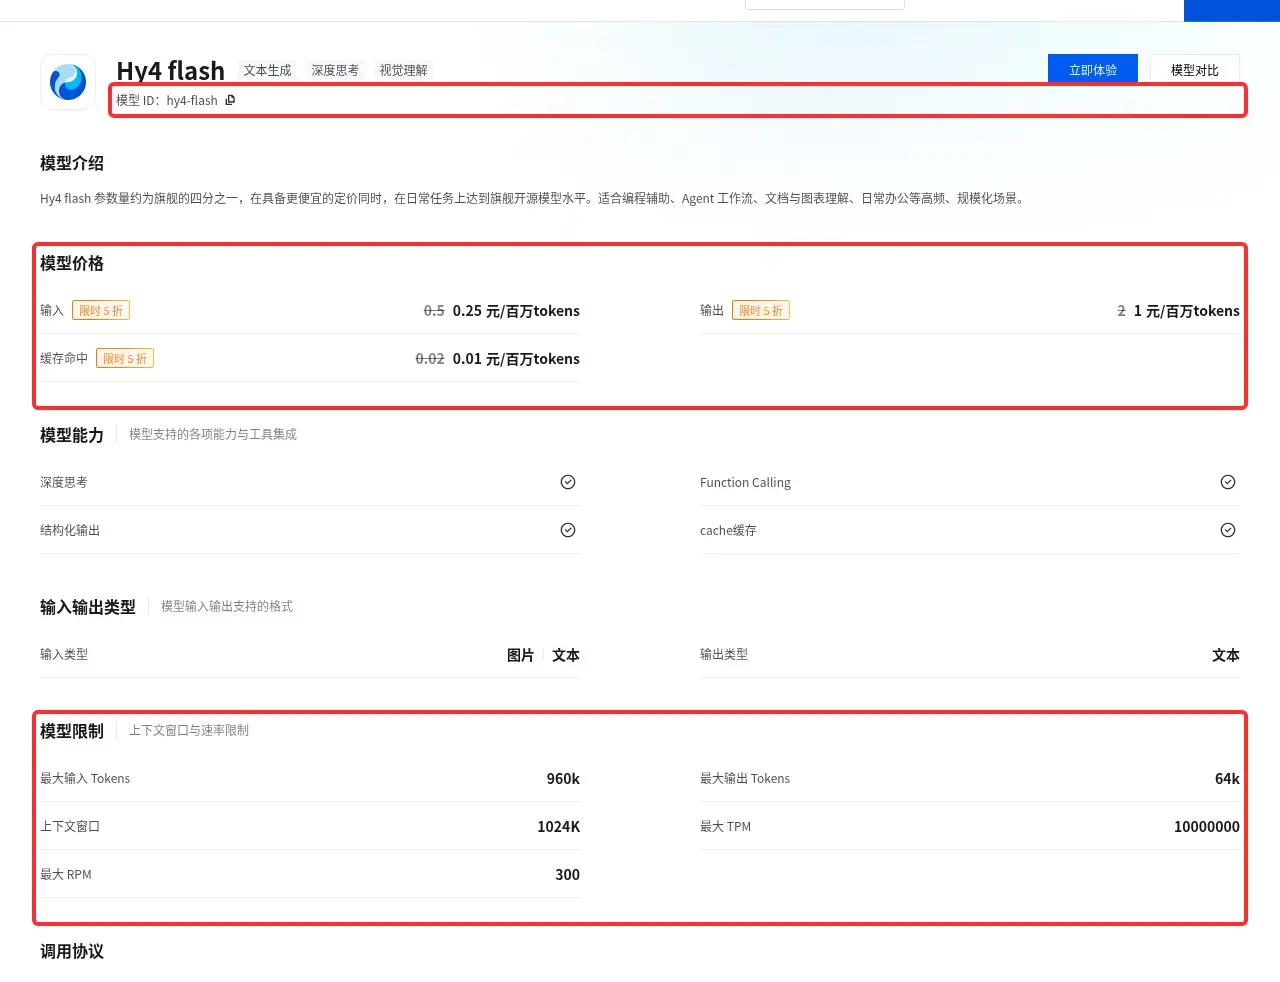 图 6:腾讯云 TokenHub 的 Hy4 flash 模型页。第一个红框是模型 ID
hy4-flash;第二个红框是模型价格(限时 5 折:输入 0.25 元、输出 1 元、缓存命中 0.01 元/百万 tokens,原价 0.5 元、2 元、0.02 元);第三个红框是模型限制:最大输入 960k、最大输出 64k、上下文窗口 1024K、最大 TPM 10000000、最大 RPM 300。
六、在哪里可以用
官方公布的上线范围:
- 腾讯云 TokenHub:API 调用,支持上面三种协议;
- 腾讯自家产品:WorkBuddy、元宝、企业微信、QQ、ima、Marvis;
- OpenRouter:官方称即将接入。
另外,混元团队表示计划开源 Hy4 flash,并会高频迭代。
七、怎么选
按官方的定位,可以这样理解 Hy4 系列的两款模型:
- 调用量大、对成本和速度敏感的日常任务,例如文档处理、PPT 生成、深度搜索、电脑操作和 Agent 工作流里的常规步骤:优先考虑 Hy4 flash。
- 长程软件工程等复杂任务:用智能上限更高的 Hy4。
如果你此前关注过 11 月 4 日发布的 Hy4,可以把 Hy4 flash 看作同一代的"高性价比版本":它通过自蒸馏继承了 Hy4 的能力,价格降到 Hy4 的十分之一左右,代价是在复杂任务上的上限低一些。