2026 年 11 月 16 日,阿里正式发布了 Qwen4-Max。官方称它是千问家族迄今能力最强的模型,也是 Qwen4 这一代的第一款模型:总参数 2.4 万亿(2.4T),原生支持视觉理解,提供 100 万 tokens 的上下文窗口,擅长工作、创作和科研中的复杂任务。
五天前(11 月 11 日),千问先开放了限时预览版 Qwen4-Max-Preview,当时只能通过 Token Plan 使用,官方也没有公布参数量和评测。这次正式版把这些信息都补上了,并开放了按量计费的 API。
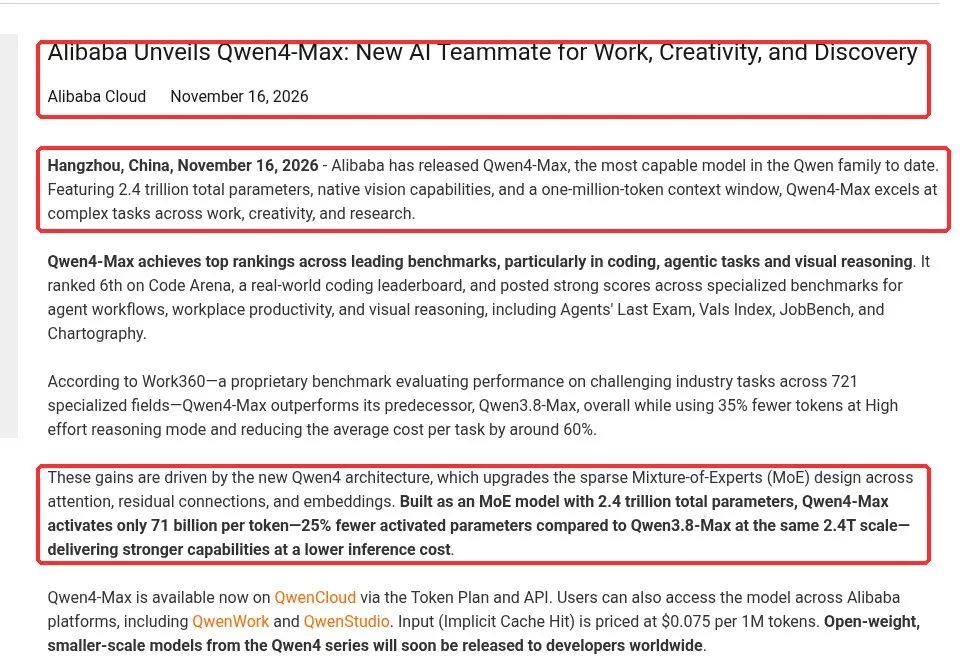 图 1:阿里云新闻稿《Alibaba Unveils Qwen4-Max》。第一个红框是标题和发布日期 2026 年 11 月 16 日;第二个红框:Qwen4-Max 是千问家族迄今最强的模型,总参数 2.4 万亿、原生视觉能力、100 万 tokens 上下文;第三个红框:新的 Qwen4 架构在注意力、残差连接和嵌入层上升级了稀疏 MoE 设计,总参 2.4T、每 token 只激活 71B,比同为 2.4T 的 Qwen3.8-Max 少 25%。
一、新架构:同样 2.4T,激活参数少了四分之一
官方把这一代的提升主要归功于新的 Qwen4 架构:在注意力机制、残差连接和嵌入层三个地方升级了稀疏混合专家(MoE)设计。
具体数字是:
- 总参数 2.4T,和上一代 Qwen3.8-Max 相同;
- 每 token 激活 71B,比 Qwen3.8-Max 少 25%;
- 输入支持文本、图像和视频,输出为文本。
激活参数变少,意味着每次推理要算的量更少。官方的说法是"以更低的推理成本带来更强的能力",这一点也反映在下面的价格上。
二、官方公布的评测
以下内容都来自阿里官方新闻稿,为官方自测或官方引用的第三方榜单。
Code Arena 第 6 名
在真实编程场景的排行榜 Code Arena(WebDev)上,Qwen4-Max(xHigh)排在第 6 位。新闻稿还提到,它在 Agents' Last Exam、Vals Index、JobBench、Chartography 等面向 Agent 工作流、职场生产力和视觉推理的评测上也有不错的成绩。
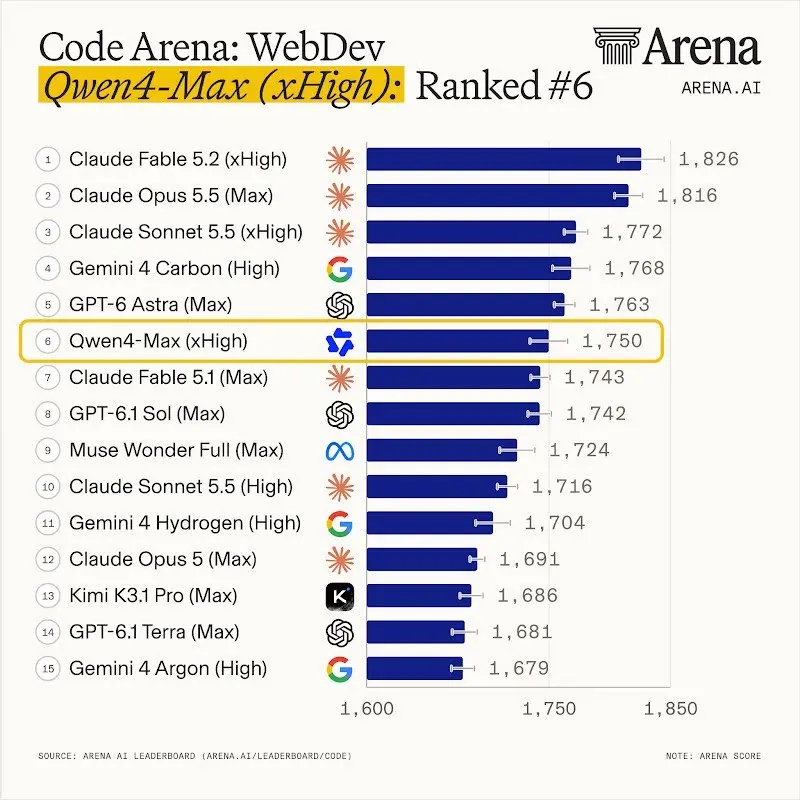 图 2:阿里官方新闻稿中引用的 Code Arena: WebDev 榜单(来源 arena.ai),黄框是 Qwen4-Max(xHigh),Arena 分数 1,750,排名第 6。
Work360:比上一代更强,也更省
Work360 是阿里自建的评测,覆盖 721 个专业领域里有挑战性的行业任务。官方称,在这个评测上 Qwen4-Max 整体超过 Qwen3.8-Max,同时在 High 推理档位下少用 35% 的 tokens,平均单任务成本降低约 60%。
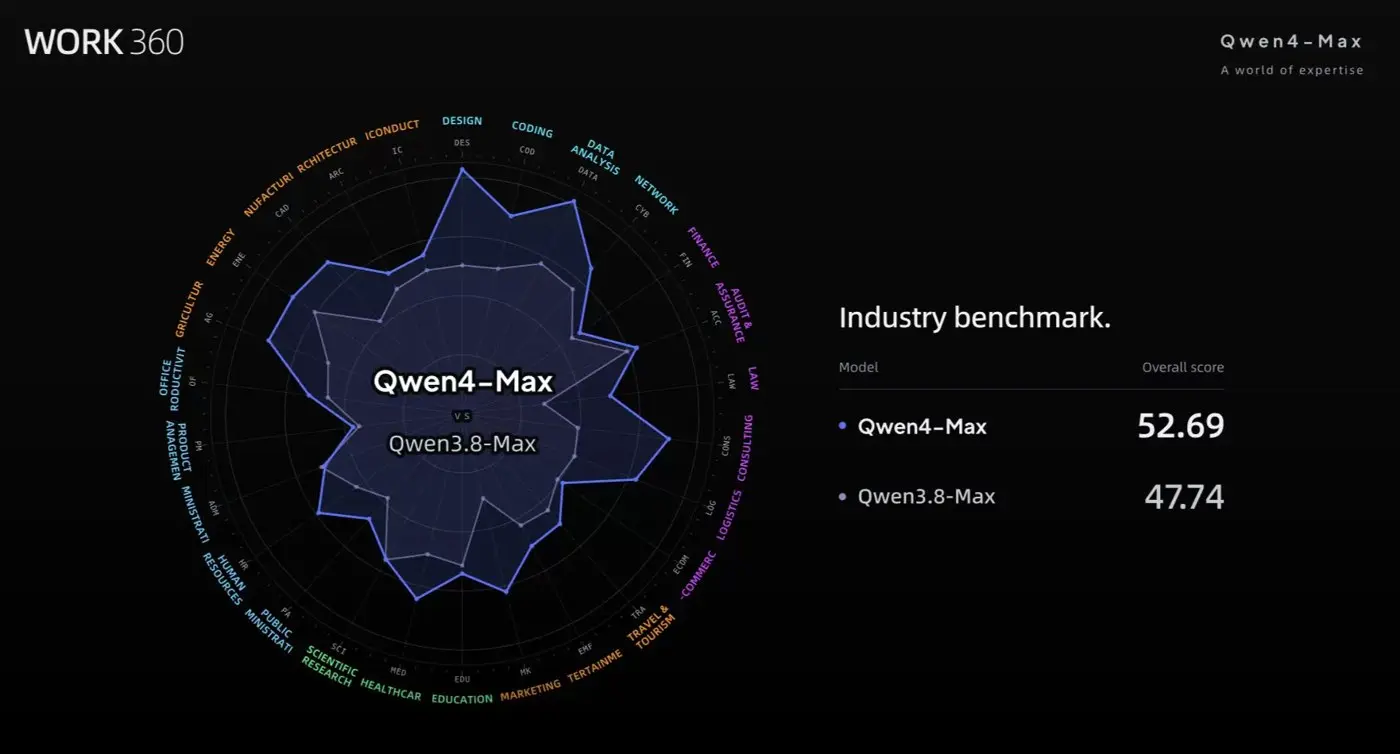 图 3:阿里官方新闻稿中的 Work360 行业评测,总分 Qwen4-Max 52.69,Qwen3.8-Max 47.74。
三、官方展示的应用场景
新闻稿还列举了几类实际场景:
- 云资源调度:在云基础设施里闭环优化自己的调度流程。官方测试中,数据标注类模型调用成本平均降低 9%,离线 CPU 重调度速度提升 14 倍以上。
- 专业工作流和创作:支持 3D 建模、游戏开发和 Agent 视频创作。在汽车制造的演示里,它覆盖产线规划、零件设计和加工验证,通过基于反馈的迭代,在加工前发现过切和余量不足,把人工编写工件程序的时间从约 475 分钟缩短到 24 分钟(减少 95%)。
- 长时间运行的科研 Agent:在芯片散热冷却液研究中,Qwen4 连续运行 48 小时,完成 4 轮"分子设计、合成测试、主动学习"的闭环,找到一种经实验验证的冷却液分子;在阿尔茨海默病研究实验中,它自主完成 454 次工具调用和 3,239 次指标评估,设计并优化了 24 个候选分子。
安全方面,官方提到软件工程训练中加入了代码安全检查,减少注入、内存安全和访问控制失效这类漏洞;网络安全方向按任务意图过滤训练数据,保留漏洞检测与修复类的防御材料、去掉攻击性内容;并用专门的安全数据和后训练加强对化学、生物、放射和核(CBRN)风险的防护。
四、规格
QwenCloud 模型页和阿里云百炼帮助文档公布的规格如下:
| 项目 | 官方数值 |
|---|---|
| 模型 ID | qwen4-max |
| 上下文长度 | 1,000,000 tokens |
| 最大输入 | 991,808 tokens(思考模式下 983,616) |
| 最大输出 | 131,072 tokens(思考模式下 262,144) |
| 最大思维链长度 | 262,144 tokens |
| 输入 / 输出模态 | 文本、图像、视频 / 文本 |
| 主要能力 | 深度思考、并行工具调用、Function Calling、联网搜索、前缀补全、结构化输出(JSON Object / JSON Schema)、显式和隐式缓存、思维链摘要与加密 |
| 兼容接口 | OpenAI Chat Completions、OpenAI Responses、Anthropic Messages、DashScope |
思考强度:可选 low、high、xhigh,默认是 high。其他取值会自动映射,例如 medium 映射为 high,max 映射为 xhigh。
部署地域方面,百炼文档列出了华北 2(北京,中国内地)、新加坡(国际),以及德国(法兰克福)、美国(弗吉尼亚)、日本(东京)、中国香港(全球部署范围)。
五、价格
正式版支持 Token Plan 和按量计费 API 两种方式。按量计费的价格如下(每百万 tokens,思考与非思考模式同价,整个 1M 上下文内不分档):
| 计费项 | 国际(新加坡,QwenCloud) | 中国内地(北京,百炼) |
|---|---|---|
| 输入 | $1.50 | 10 元 |
| 输出 | $4.50 | 30 元 |
| 隐式缓存命中 | $0.075 | — |
QwenCloud 上还列出了显式缓存的价格:5 分钟显式缓存创建 $1.875、1 小时显式缓存创建 $3、显式缓存读取 $0.075(每百万 tokens)。
作为参照,QwenCloud 价格页上上一代 Qwen3.8-Max 的国际价格是输入 $2、输出 $6,Qwen4-Max 的单价比它低 25%。
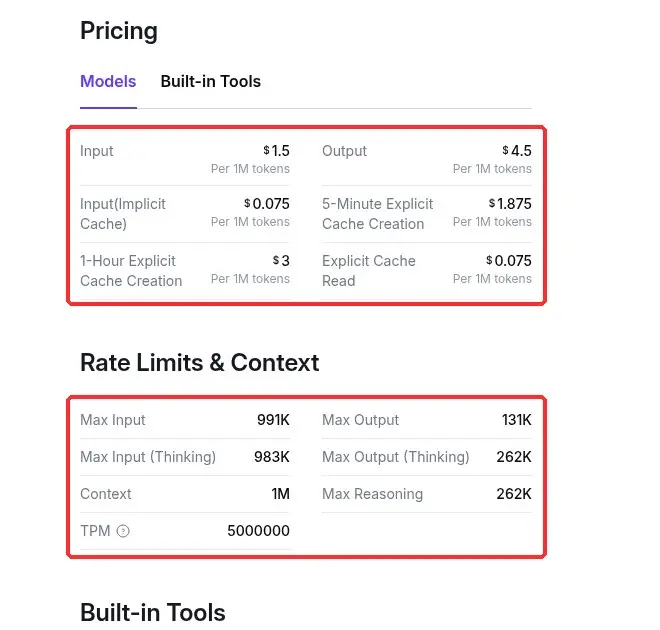 图 4:QwenCloud 的 Qwen4-Max 模型页。上方红框是价格:输入 $1.5、输出 $4.5、隐式缓存 $0.075、5 分钟显式缓存创建 $1.875、1 小时显式缓存创建 $3、显式缓存读取 $0.075(每百万 tokens);下方红框是限流与上下文:最大输入 991K、最大输出 131K、思考模式下最大输入 983K / 最大输出 262K、上下文 1M、最大思维链 262K、TPM 5,000,000。
六、和预览版有什么不同
11 月 11 日开放的 Qwen4-Max-Preview 和这次的正式版,主要区别如下:
| 对比项 | Qwen4-Max-Preview(11 月 11 日) | Qwen4-Max 正式版(11 月 16 日) |
|---|---|---|
| 模型 ID | qwen4-max-preview | qwen4-max |
| 计费方式 | 仅 Token Plan,不支持按量 | Token Plan 和按量 API |
| 参数和评测 | 未公布 | 公布 2.4T 总参 / 71B 激活,以及 Code Arena、Work360 等评测 |
| 默认思考强度 | xhigh(可选 low / medium / xhigh) | high(可选 low / high / xhigh) |
| 最大输出 | 393,216 tokens,思考与回答共享 | 非思考 131,072;思考模式 262,144,思维链最长 262,144 |
如果之前用预览版做过测试,换到正式版时要注意两点:一是模型 ID 改为 qwen4-max;二是默认思考强度从 xhigh 变成了 high,需要最深推理时要显式设置为 xhigh。
七、在哪里可以用
- QwenCloud / 阿里云百炼:通过 Token Plan 或 API 调用;
- 阿里自家平台:QwenWork(千问办公)、Qwen Studio;
- 开源计划:官方表示,Qwen4 系列中较小尺寸的开放权重模型将很快面向全球开发者发布,Qwen4-Max 本身没有开源权重。
参考来源
- 阿里云新闻稿:Alibaba Unveils Qwen4-Max: New AI Teammate for Work, Creativity, and Discovery
- QwenCloud 模型页:Qwen4-Max
- QwenCloud 文档:Model releases、Model pricing
- 阿里云百炼帮助文档:qwen4-max