2026 年 11 月 18 日,Google 发布了 Gemini 4 Neon。按官方的说法,它要把前沿水平的智能,用更快的端到端速度,用在复杂的软件工程、知识工作和科学流程上。
Gemini 4 家族里,Carbon 负责最难、最长程的项目,Hydrogen 负责日常编程和 Agent 的快速执行。Neon 处在两者之间:既要有足够的推理深度,又要更省、更快地做完高频的复杂任务。
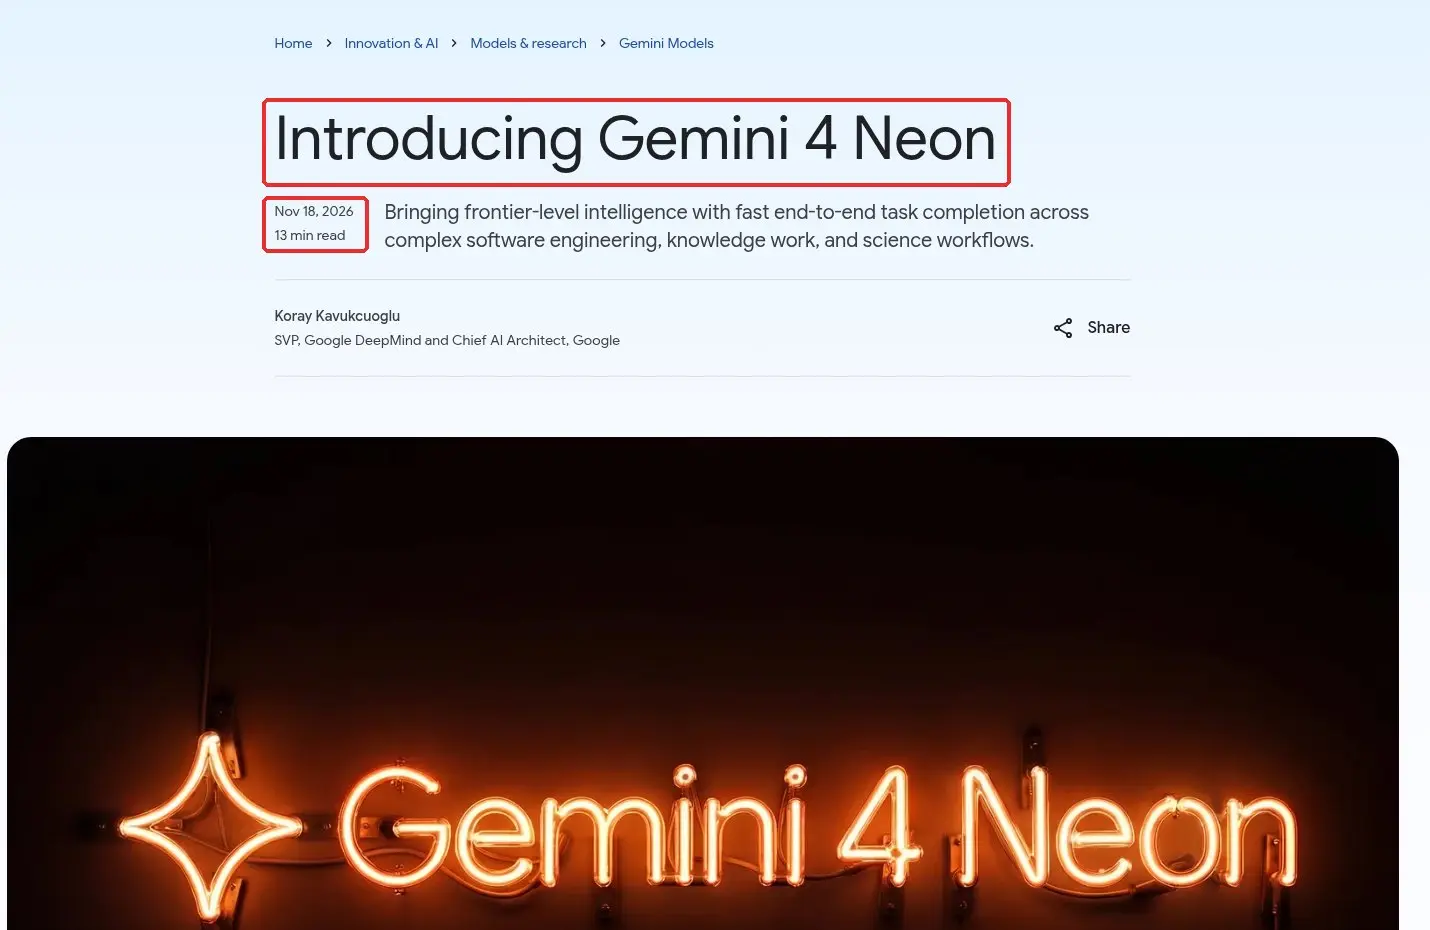 图 1:Google 官方博客《Introducing Gemini 4 Neon》,上方红框是标题,下方红框是发布日期 Nov 18, 2026(2026 年 11 月 18 日)。
一、Neon 在 Gemini 4 家族里是什么定位
官方把这三款模型这样区分:
| 模型 | 模型 ID | 官方定位 |
|---|---|---|
| Gemini 4 Carbon | gemini-4-carbon | 最难、最长程的项目和深度研究 |
| Gemini 4 Neon | gemini-4-neon | 在软件工程、知识工作和科学场景里做深度推理,同时追求更快、更省地做完任务 |
| Gemini 4 Hydrogen | gemini-4-hydrogen | 日常编程和 Agent 工作流里的速度与效率 |
官方文档的建议是:需要前沿能力、又希望更快完成的复杂编程、知识工作和科学任务,用 Neon;架构、疑难调试、科研和安全这类最难的问题,继续用 Carbon;日常编程和 Agent 工作流,默认仍用 Hydrogen。
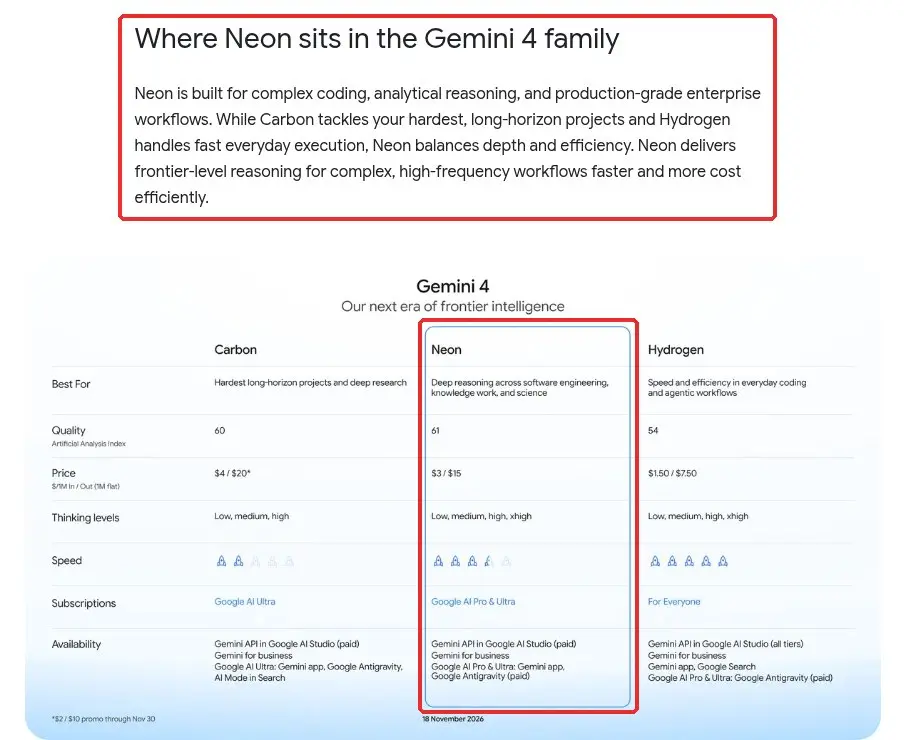 图 2:Google 官方博客《Where Neon sits in the Gemini 4 family》。上方红框是官方对 Neon 的定位说明;下方红框是家族对比表中的 Neon 一列,包括适用场景、Artificial Analysis Index、价格、思考档位和可用范围。脚注说明 Carbon 的 $2 / $10 促销价有效期至 11 月 30 日。
官方对比表里的质量分数来自 Artificial Analysis Index:Carbon 60、Neon 61、Hydrogen 54。发布页开头另外写明,Neon 的 61 分是在 xhigh 思考档位下取得的,总榜第 3,排在更大、更慢的模型后面。价格方面,三款都是整个 1M 上下文统一定价:Carbon 为每百万 tokens 输入 $4 / 输出 $20(11 月 30 日前促销 $2 / $10),Neon 为 $3 / $15,Hydrogen 为 $1.50 / $7.50。
二、官方公布的能力和评测
以下数据都来自 Google 官方博客,均为官方自测或官方引用的第三方榜单。
官方称,Neon 在默认的 high 思考档位下,完成任务的成本比 Carbon 低 32%;在 Vals Index 和 Agent Arena 上处于 Pareto 前沿,完成任务的成本大约比当时领先的竞品前沿模型低 50% 到 80%。xhigh 档会把推理加深,官方称这时它的智能分数最高,完成任务的成本仍比竞品在最高档位下低 36% 以上。
发布页上的对比表把 Neon 和 Claude Opus 5.5、GPT-6.2 Sol 放在一起,部分数字如下:
| 评测 | Gemini 4 Neon | Claude Opus 5.5 | GPT-6.2 Sol |
|---|---|---|---|
| Artificial Analysis Index v5.0.1 | 61 | 59 | 57 |
| Vals Index v2.2 | 70.9% | 70.1% | 66.1% |
| CursorBench 4.1 | 65.4% | 58.1% | — |
| Terminal-Bench 4.1(已按作弊调整) | 65.2% | 65.8% | 61.5% |
| FrontierCode 2.0 | 46.2% | 47.3% | 43.8% |
| SWE-sweep(Provider harness) | 39.0% | 10.1% | 8.3% |
| SWE-sweep(mini-SWE harness) | 12.8% | 3.6% | 11.6% |
| AutomationBench | 56.3% | 42.5% | 41.3% |
| Agents' Last Exam v1.1 | 75.8% | 71.6% | 73.0% |
| RiemannBench | 84.0% | 80.0% | 80.0% |
| Terminal-Bench-Science 0.1 | 70.5% | 63.3% | 68.0% |
| HLE-Diamond | 71.3% | 67.9% | 64.0% |
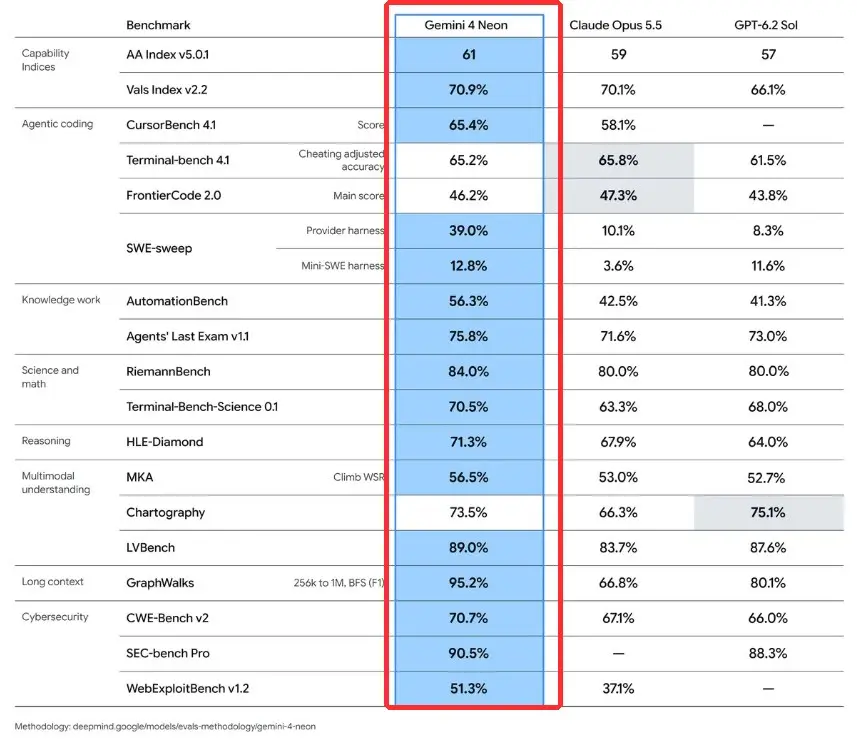 图 3:Google 官方博客中的评测表,红框内是 Gemini 4 Neon 一列。评测方法说明见官方页面 deepmind.google/models/evals-methodology/gemini-4-neon。
官方还提到另外几项结果:Vals Index 总榜第 2,Legal Research Bench 和 Tax Agent Bench 第 1;Agent Arena Index 第 2(1336 分,基于 4200 多场真实 Agent 会话),在新榜的可操控性(steerability)上也是第 2;Zapier 的 AutomationBench 和 Andon Labs 的 Vending-Bench 2 均为第 1;Chartography 73.5%。在 Google Antigravity 的内部测试里,官方称 Neon 的编造率是目前最低的。
编程方面,官方把它写成适合长程、工具调用很多的 Agent 工作流:会减少重复读文件,在长会话里更稳定地压缩上下文,也能作为编排者,调度并行的 Hydrogen 子 Agent。Artificial Analysis Coding Agent Index 上,官方给出的成绩是总分第 1(58.6)。SWE-sweep 在 mini-SWE harness 上是 12.8%,在 Google Antigravity 里上升到 39.0%,官方用这个对比来说明 harness 对成绩的影响。
三、四档思考强度
Neon 支持四个思考档位:low、medium、high(默认)和 xhigh。这和 Hydrogen 一样,和 Carbon、Argon 不同——后两款默认是 medium,最高到 high,没有 xhigh。
Gemini API 文档给出的选择建议如下:
| 档位 | token 用量 | 适合的场景 |
|---|---|---|
low | 最少,延迟最低 | 对成本和延迟敏感的任务,例如快速聊天、高吞吐处理 |
medium | 较少,响应更快 | 交互式编程、实时 UI 原型、对延迟敏感的工具调用 |
high(默认) | 智能和速度平衡 | 大多数任务的推荐默认值,包括复杂编程、Agent 执行、工具调用和多模态知识工作 |
xhigh | 最多,推理最深 | 留给 high 解决不了的多步工程、分析和科学难题,代价是更高的延迟和 token 用量 |
官方建议大多数复杂任务先用 high,xhigh 只在 high 不够时再用。用 xhigh 会增加延迟和 token 用量。评估四个档位时,要把 max_output_tokens 设得足够高,避免答案被长度上限截断,然后再选能达到质量要求的最低档位。
四、上下文和输出长度
- 统一 1M 上下文:输入、思考和输出 tokens 共用一个 1,048,576 tokens 的窗口。
- 单次同步输出默认最多 65,536 tokens:流式和非流式请求都一样。
- 长输出:需要超过 64K 的输出时,可以把
max_output_tokens设到 65,536 以上(上限为 1,048,576 减去输入 tokens),并使用后台执行或客户端续写。Gemini 4 系列把这种超出 64K 的生成叫做 long decode。
输入模态按官方文档是文本、图像、音频、视频和 PDF。
五、价格
Gemini 4 Neon 不在 Gemini API 的免费层提供。付费层在整个 1M 上下文内统一定价,不按上下文长度分档:
| 计费项 | 免费层 | 付费层(每百万 tokens) |
|---|---|---|
| 输入 | 不可用 | $3.00 |
| 输出(含思考 tokens) | 不可用 | $15.00 |
| 缓存输入 | 不可用 | $0.15(仅隐式缓存,不支持显式缓存) |
官方特别说明,模型处理的每个 token 都计费,包括思考 tokens,以及使用 Grounding 时内部的工具系统指令和函数声明。Google 搜索 Grounding 仍按查询次数单独计费:Gemini 3 及更新模型共享每月 5,000 次免费额度,超出后每 1,000 次 $14,每天最多 1,500 次。隐式缓存的最低输入长度是 4,096 tokens。
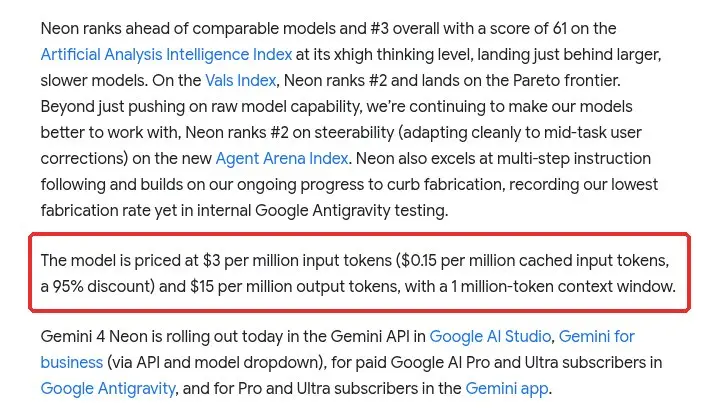 图 4:Google 官方博客原文。红框内:Neon 的价格为每百万 tokens 输入 $3、缓存输入 $0.15(95% 折扣)、输出 $15,上下文窗口为 100 万 tokens。
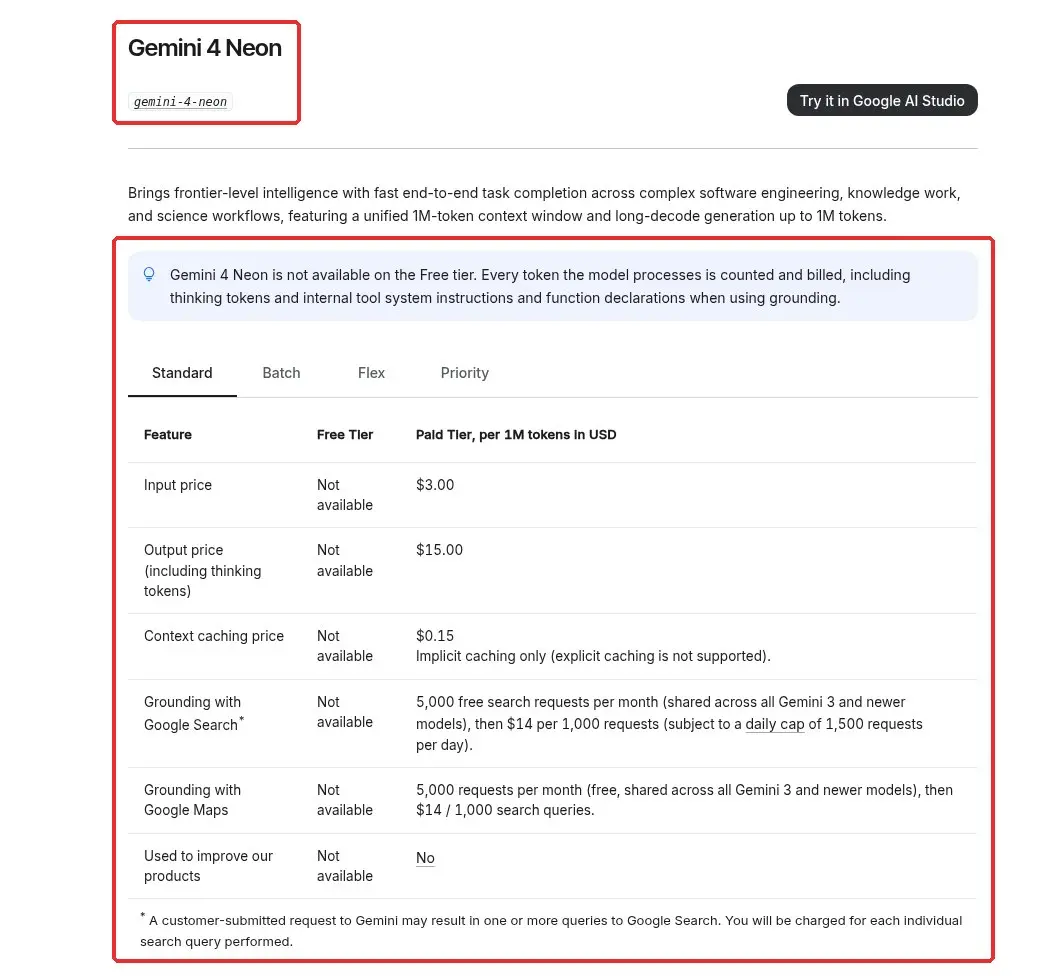 图 5:Gemini API 文档价格页的 Gemini 4 Neon 一节。上方红框是模型名称和模型 ID
gemini-4-neon;下方红框是免费层不可用的说明,以及 Standard 档的价目表(免费层均为 Not available,付费层输入 $3.00、输出 $15.00、上下文缓存 $0.15)和表下脚注。
六、在哪里可以用
官方公布的上线范围:
- 开发者:Gemini API 的付费层(
generateContent和 Interactions API 都支持),以及 Google AI Studio、Android Studio;Google AI Pro 和 Ultra 付费订阅用户可以在 Google Antigravity 里使用,所有 Pro 和 Ultra 订阅用户也可以在 AI Studio 里试用。 - 企业:Gemini for business(通过 API 或模型下拉菜单)和 Google Antigravity。
- 普通用户:Google AI Pro 或 Ultra 订阅用户可以在 Gemini 应用的模型下拉菜单里选择 Gemini 4 Neon。
- 网络安全防务:符合条件的 Fairwind Program 成员会在随后几天陆续获得 Neon for cyber 的访问权限。
Gemini API 的 Managed Agents 里,Antigravity agent 也支持 gemini-4-neon,可以单独使用,也可以和 Hydrogen 搭配做多模型工作流。
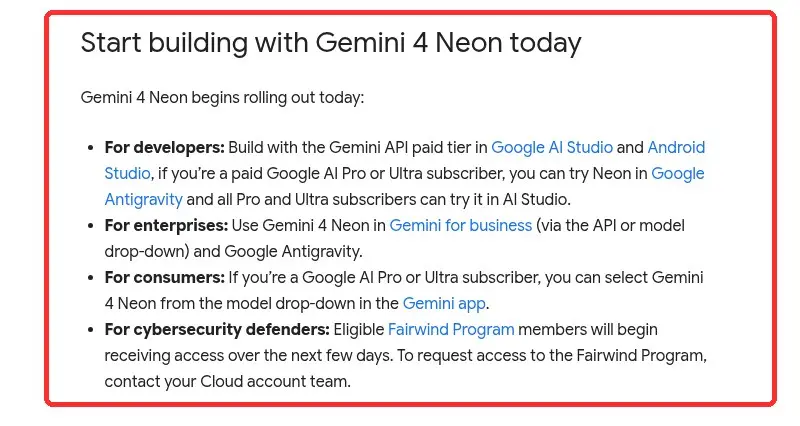 图 6:Google 官方博客《Start building with Gemini 4 Neon today》,红框内是面向开发者、企业、普通用户和网络安全防务人员的上线说明。
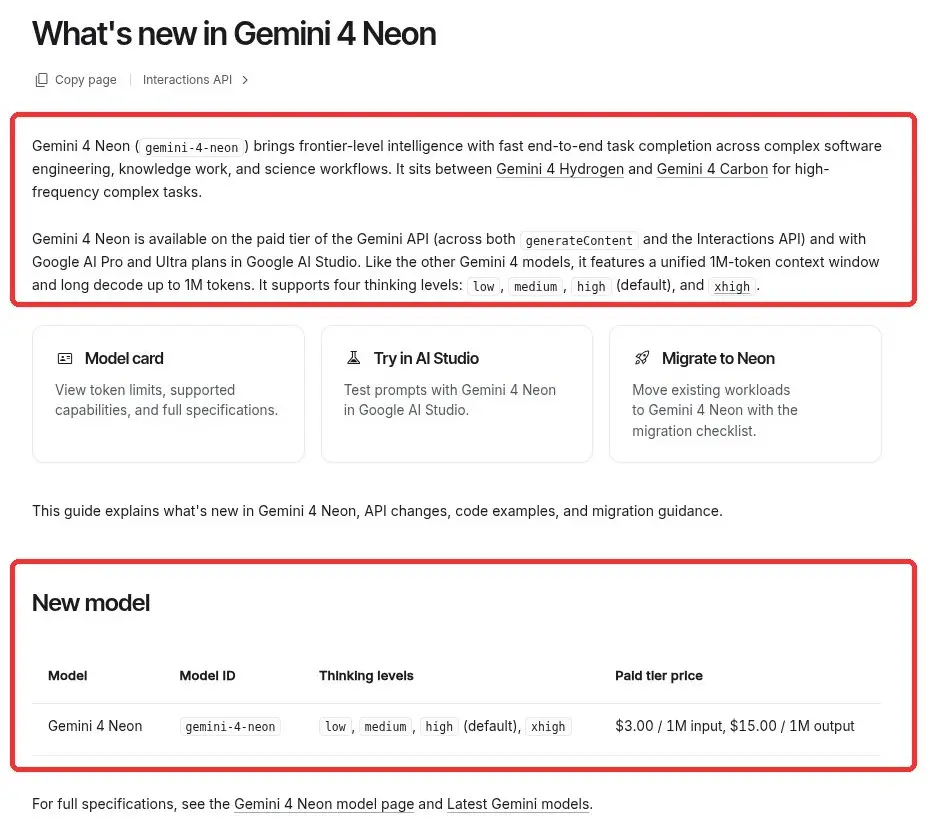 图 7:Gemini API 文档《What's new in Gemini 4 Neon》。上方红框:模型 ID
gemini-4-neon、付费层可用、1M 统一上下文、四个思考档位;下方红框:New model 表中的模型 ID、思考档位和付费层价格 $3.00 / $15.00。
用 Python SDK 调用的官方示例如下,默认就是 high 思考档位:
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-4-neon",
    input="Build an interactive single-file HTML token bucket rate-limiter simulator with live sliders for burst size and request traffic."
)

print(interaction.output_text)
已经在用 gemini-4-carbon 或 gemini-4-hydrogen 的项目,切换到 Neon 不需要改请求结构,把 model 换成 gemini-4-neon 即可;需要 medium 或 xhigh 时,再显式设置 thinking_level。
七、安全和网络防务
官方称,Neon 沿用了 Gemini 4 的安全和安保能力:对严重滥用和间接提示注入的防护与 Carbon 相当,并在对齐和 Agent 行为上继续改进。因为 Neon 把前沿能力放到了更快、更便宜的模型上,官方给它配备了与 Carbon 相当的实时防护,同时减少对合法任务的误拒,例如在 Terminal-Bench 4.0 上拒绝 1.98% 的任务,在 Terminal-Bench-Science 上拒绝 0%。
在 Google 给出的内部评估里,Neon 在 Terminal-Bench 4.0 上的作弊率为 0.0%,与 Carbon 相同;在编码作弊评估上走捷径的比例是 2.45%,是 Gemini 4 各模型里最低的。官方还提到,开启最高思考档位并配合实时防护时,Neon 在 Gray Swan 的间接提示注入评测中攻击成功率为 0.0%。
面向网络防务的 Gemini 4 Neon for cyber 会通过 Fairwind Program 向受信任的防务人员开放。官方给出的几项成绩包括:AutoBaxBench 困难档 76%,WebExploitBench v1.2 为 51.26%,SEC-bench Pro 90.5%,CWE-bench v2 70.7%。更完整的安全说明见官方模型卡。