美国时间 2026 年 11 月 17 日(北京时间 11 月 18 日凌晨),OpenAI 发布了 GPT-6.2 的两款模型:
- GPT-6.2 Astra(API 模型 ID
gpt-6.2-astra):新的旗舰模型,官方定位是"为你最难的项目而生"; - GPT-6.2 Sol(API 模型 ID
gpt-6.2-sol):高效、通用的日常主力模型。
官方的核心说法是:两款模型在高难度任务上效果更好,同时输出 tokens 更少,所以在同样的套餐额度里能做更多事;对企业和开发者来说,就是用更合理的成本拿到前沿水平的能力。
 图 1:OpenAI 官方发布页《Introducing GPT-6.2 Astra and Sol》的头图,副标题是"A new standard for professional work"(专业工作的新标准)。
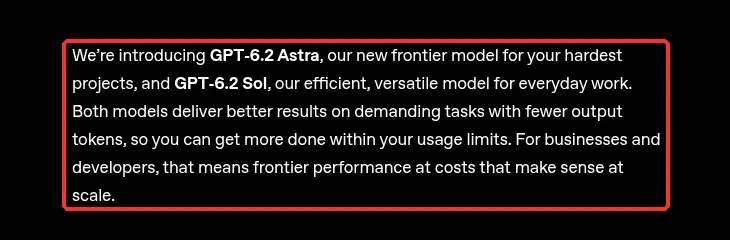 图 2:发布页开头一段(红框):GPT-6.2 Astra 是面向最难项目的新前沿模型,GPT-6.2 Sol 是高效、通用的日常模型;两者都用更少的输出 tokens 在高难度任务上拿到更好的结果。
一、两款模型怎么分工
| GPT-6.2 Astra | GPT-6.2 Sol | |
|---|---|---|
| API 模型 ID | gpt-6.2-astra | gpt-6.2-sol |
| 官方定位 | 最强模型,面向从头到尾的高难度项目 | 日常主力,从写代码到大规模运行 Agent |
| 上一代对照 | GPT-6 Astra | GPT-6.1 Sol |
| 官方建议的用法 | 跨服务排查并修复 bug、把研究资料做成符合模板的演示文稿等高难度工作 | 改代码、写报告、把项目笔记整理成计划等日常任务 |
OpenAI 在 Codex 文档里的推荐是:跨代码、应用或研究的高难度工作选 Astra;日常编程、写作和多来源整合选 Sol,Sol 在标准速度下每 token 消耗的额度比 Astra 少。
二、GPT-6.2 Astra:专业文档、代码和科研
官方把 Astra 的提升集中在几类专业工作上:
- 幻灯片、表格和文档:生成的内容"更不像 AI 写的",更贴合用户提供的模板和行业惯例。官方称它是目前做幻灯片、套用模板最好的模型,给原文件甚至一张截图,就能对齐版式、配色和字号,并沿用模板的写作风格。
- 代码:在现有代码库里实现和测试复杂改动的能力更强,早期测试者反馈代码风格更干净、测试更聚焦、返工轮次更少。前端方面,网站、游戏和 3D 设计做得更好看、也更好用。
- 电脑操作和 3D:电脑操作更精确,能在 CAD 和仿真工具里细到单个零件和连接。
- 科研:官方称 GPT-6.2 Astra 是"给科学家用的世界上最好的模型"。
官方公布的主要评测结果如下(均为 OpenAI 官方发布页数据):
- Agents' Last Exam(多步骤专业工作):比 GPT-6 Astra 高 5.2 分,成本不到其三分之一;比 Claude Fable 5.2 高 5.5 分,成本只有其 5%。
- Terminal-Bench-Science 0.1(在终端里完成科研工作):比 GPT-6 Astra 高 9 个百分点,成本不到其三分之一。
- GDPval v2(OpenAI 内部,长周期知识工作):比 GPT-6 Astra 高 6.2 个百分点,输出 tokens 少 22%。
- Harvey LAB-AA v1.1(法律任务):通过率是 Claude Fable 5.2 的两倍多,成本约六分之一。
- AA-AnalystAgent(基于真实表格和报告的分析任务):在 5 次独立尝试中全部答对的题目占 62.5%,为新高。
- AA-3D(人类盲评 3D 交互作品):GPT-6.2 Astra 以 1,318 Elo 排第一,Claude Fable 5.2 为 1,271,GPT-6.2 Sol 为 1,259。
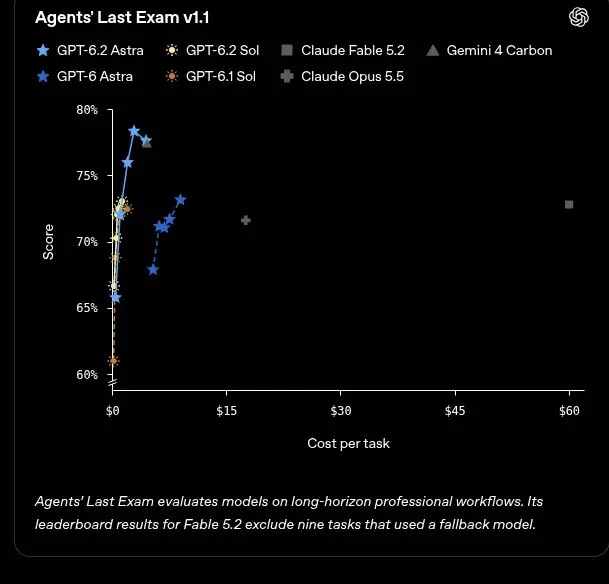 图 3:官方发布页的 Agents' Last Exam v1.1 图表,纵轴是得分、横轴是单任务成本。浅蓝色实线是 GPT-6.2 Astra,最高点约 78%,单任务成本在几美元内;深蓝虚线是 GPT-6 Astra。
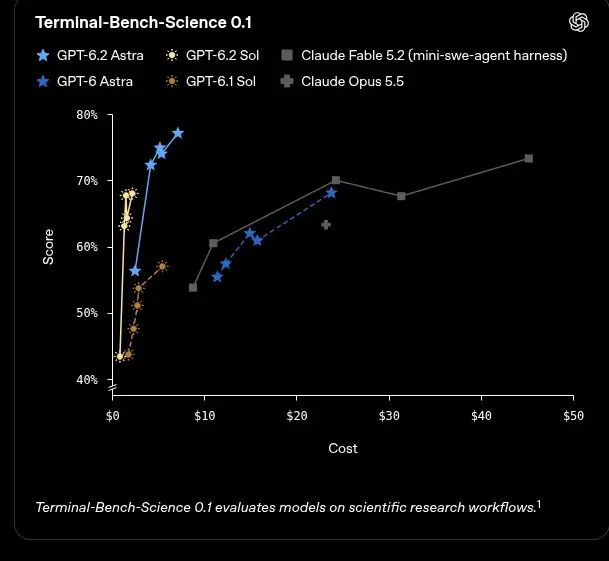 图 4:官方发布页的 Terminal-Bench-Science 0.1 图表。GPT-6.2 Astra(浅蓝实线)最高约 77%,GPT-6 Astra(深蓝虚线)最高约 68%。图注说明 Claude Fable 5.2 的成绩来自 Artificial Analysis 在 mini-swe-agent 框架下的测试。
三、GPT-6.2 Sol:更聪明,也更省
对 Sol,官方的说法是:比 GPT-6.1 Sol 更聪明、更高效,同样的付费套餐能完成更多任务;能顺畅跑完多步骤的 Agent 工作流,写作更自然。OpenAI 内部很多员工把它当作技术和非技术任务的默认模型。
几项官方数据:
- FrontierCode 2.0(评估对真实代码库的改动是否达到维护者的合并标准):GPT-6.2 Sol 与 GPT-6.2 Astra 只差 0.5 分,成本约为后者的五分之一(两者都在最高推理档位下测试)。
- LifeVal(OpenAI 新发布的日常任务评测):GPT-6.2 Sol 的得分超过 GPT-6 Astra,成本约为后者的七分之一。
- GDPval v2:比 GPT-6.1 Sol 高 5.3 个百分点。
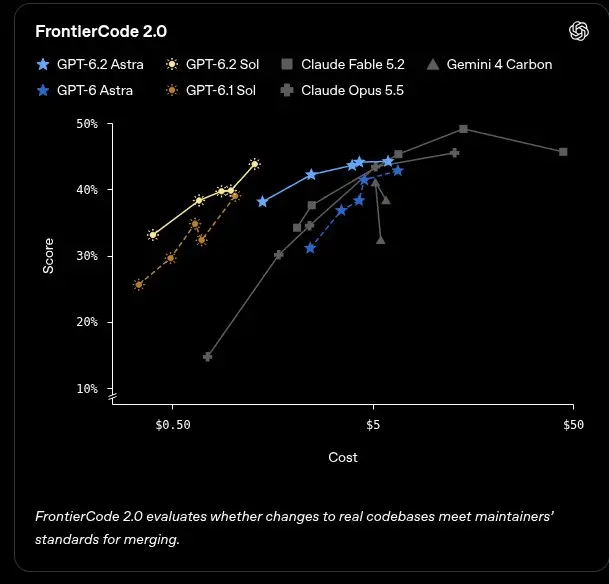 图 5:官方发布页的 FrontierCode 2.0 图表,横轴是成本(对数刻度)。浅黄色实线是 GPT-6.2 Sol,最高约 44%,与 GPT-6.2 Astra(浅蓝实线)的最高点接近,但成本低得多。
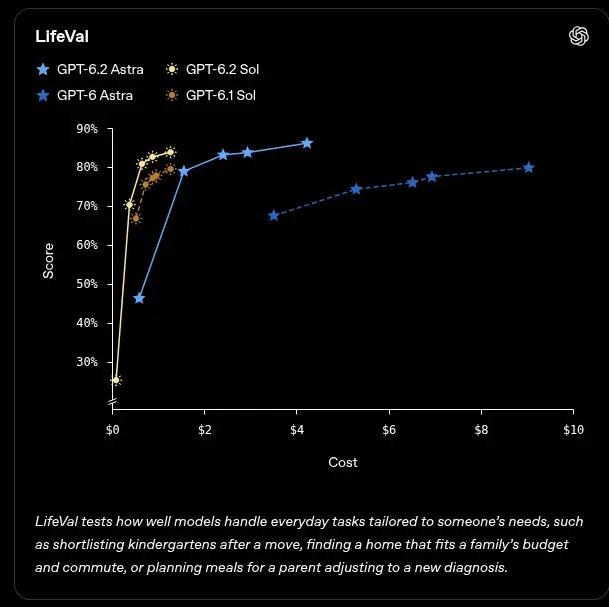 图 6:官方发布页的 LifeVal 图表。GPT-6.2 Sol(浅黄实线)最高约 84%,成本在 $1.5 以内;GPT-6 Astra(深蓝虚线)最高约 80%,成本约 $9。
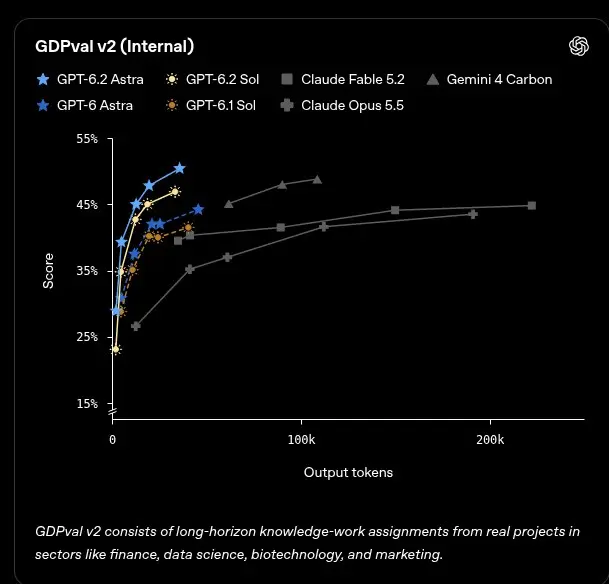 图 7:官方发布页的 GDPval v2(内部评测)图表,横轴是输出 tokens。GPT-6.2 Astra(浅蓝)和 GPT-6.2 Sol(浅黄)都在更少的输出 tokens 下拿到了更高的分数。
四、规格
两款模型在 OpenAI API 文档里的规格基本一致,差别在知识截止日期:
| 项目 | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| 模型 ID | gpt-6.2-astra | gpt-6.2-sol |
| 上下文窗口 | 1,050,000 tokens | 1,050,000 tokens |
| 最大输入 | 922,000 tokens | 922,000 tokens |
| 最大输出 | 128,000 tokens | 128,000 tokens |
| 知识截止 | 2026 年 5 月 18 日 | 2026 年 6 月 1 日 |
| 输入 / 输出 | 文本、图像 / 文本 | 文本、图像 / 文本 |
| 推理 | 支持推理 tokens;不接受 none 推理强度 | 同左 |
| 接口 | Chat Completions、Responses、Batch | 同左 |
Responses API 下两者都支持网页搜索、文件搜索、图像生成、代码解释器、托管 Shell、apply_patch、Skills、电脑操作、MCP 和工具搜索等工具,并可用 Multi-agent beta 把任务分给子 Agent。
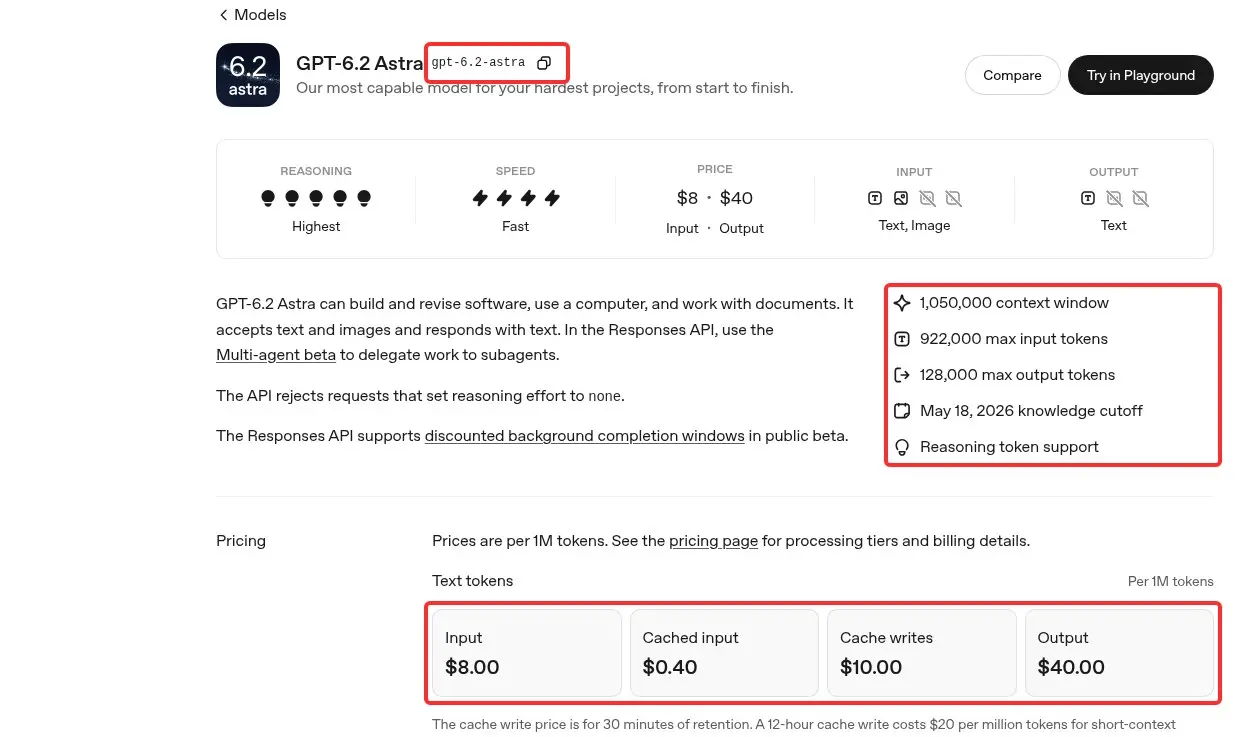 图 8:OpenAI API 文档的 GPT-6.2 Astra 模型页。红框依次是:模型 ID
gpt-6.2-astra;规格(1,050,000 上下文、922,000 最大输入、128,000 最大输出、2026-05-18 知识截止、支持推理 tokens);文本价格(输入 $8.00、缓存输入 $0.40、缓存写入 $10.00、输出 $40.00,每百万 tokens)。
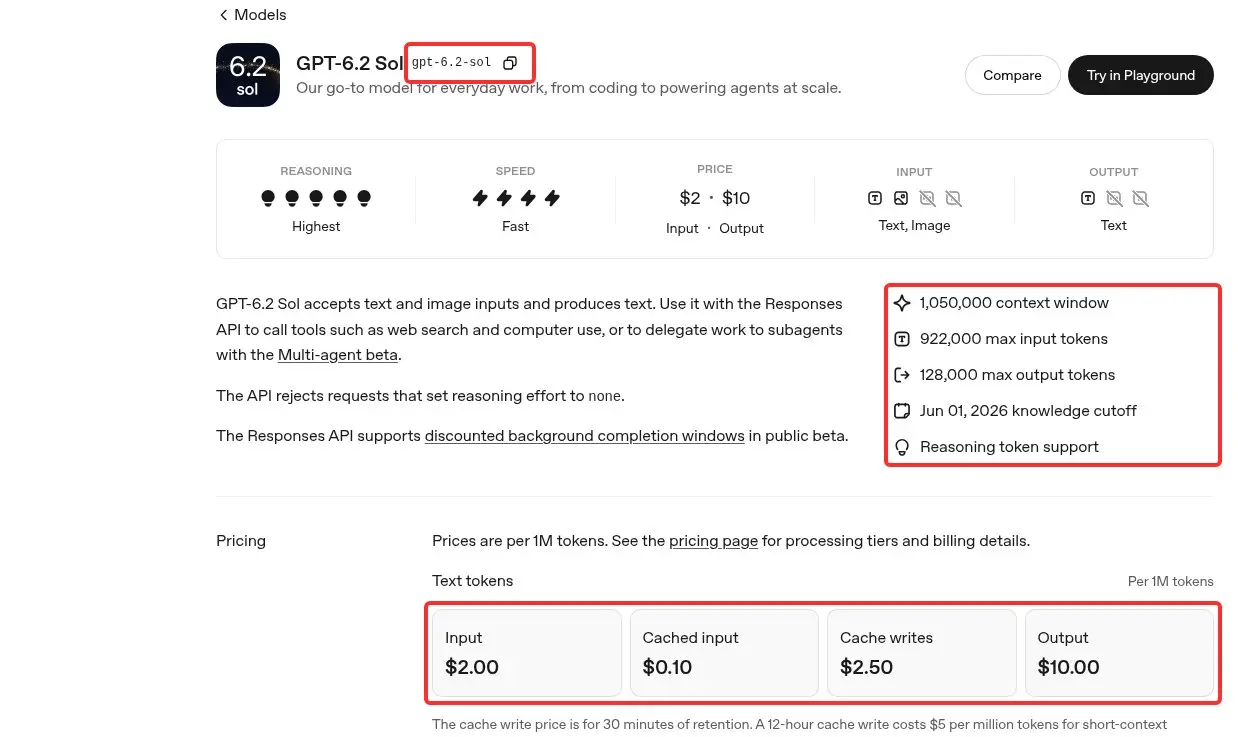 图 9:OpenAI API 文档的 GPT-6.2 Sol 模型页。红框依次是:模型 ID
gpt-6.2-sol;规格(1,050,000 上下文、922,000 最大输入、128,000 最大输出、2026-06-01 知识截止、支持推理 tokens);文本价格(输入 $2.00、缓存输入 $0.10、缓存写入 $2.50、输出 $10.00,每百万 tokens)。
五、价格
标准价格(每百万 tokens):
| 计费项 | GPT-6.2 Astra | GPT-6 Astra(对照) | GPT-6.2 Sol | GPT-6.1 Sol(对照) |
|---|---|---|---|---|
| 输入 | $8 | $10 | $2 | $2 |
| 缓存输入 | $0.40 | $1 | $0.10 | $0.10 |
| 缓存写入(30 分钟) | $10 | $12.5 | $2.50 | $2.50 |
| 输出 | $40 | $50 | $10 | $10 |
也就是说,Astra 的输入和输出单价比 GPT-6 Astra 低 20%,缓存输入低 60%;Sol 沿用 GPT-6.1 Sol 的价格。
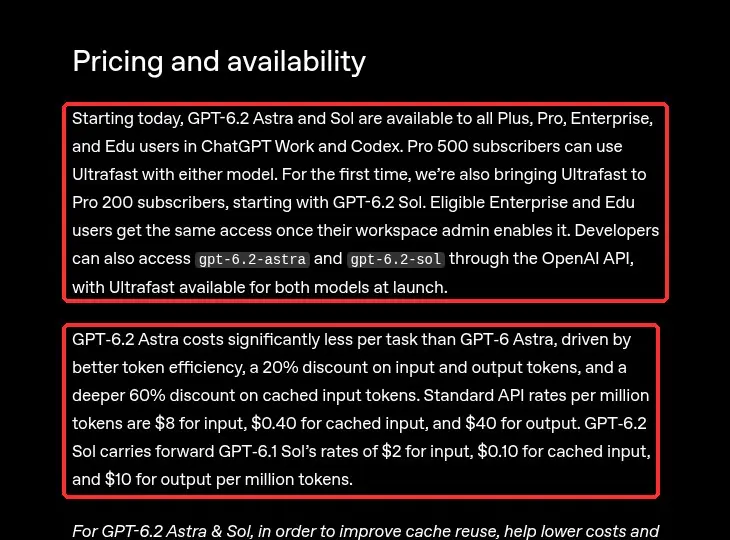 图 10:发布页「Pricing and availability」一节。第一个红框:即日起向 ChatGPT Work 和 Codex 的 Plus、Pro、Enterprise、Edu 用户开放,开发者可通过 API 使用
gpt-6.2-astra 和 gpt-6.2-sol;第二个红框:GPT-6.2 Astra 的 API 标准价为输入 $8、缓存输入 $0.40、输出 $40,GPT-6.2 Sol 沿用 GPT-6.1 Sol 的 $2、$0.10、$10(每百万 tokens)。
模型页还列出了几条计费细则:
- 长上下文:单次请求输入超过 272K tokens 时,整个请求的输入和缓存按 2 倍计价、输出按 1.5 倍计价;
- 缓存写入:上表价格对应 30 分钟保留;12 小时缓存写入(短上下文、标准价)Astra 为 $20、Sol 为 $5 每百万 tokens;
- 处理档位:Batch 为标准价的 50%;Fast 模式为 2 倍;Ultrafast 在 2027 年 2 月 28 日前为 3 倍,2027 年 3 月 1 日起为 6 倍(太平洋时间);
- 后台完成窗口:Responses API 公测的后台完成窗口可选 2 小时或 8 小时,token 单价分别比标准价低 30% 和 40%。
六、在 ChatGPT Work 和 Codex 里的可用范围
- ChatGPT Work 和 Codex:即日起向 Plus、Pro、Enterprise、Edu 用户开放;Enterprise 和 Edu 需要工作区管理员启用。
- Ultrafast:Pro 500 订阅可以在两款模型上使用 Ultrafast;Pro 200 订阅首次获得 Ultrafast,先从 GPT-6.2 Sol 开始。
- Codex 默认上下文:GPT-6.2 Astra 为 272,000 tokens,GPT-6.2 Sol 为 500,000 tokens;Codex App 和 CLI 都可用。
- ChatGPT Work 默认:新开的 Work 对话默认使用 GPT-6.2 Sol(支持的个人套餐为 Light 档,已启用的 Enterprise 工作区为 Medium 档),可以在 Power 滑块里调整,或在 Advanced 里手动指定模型。
在 Codex CLI 里,官方文档给出的切换方式是启动时加 --model 参数,例如:
codex --model gpt-6.2-sol
非交互运行同样可以用 -m 指定模型,例如 codex exec -m gpt-6.2-sol "Review the current changes"。
七、API 迁移要注意的几点
OpenAI 的《Using GPT-6.2》迁移指南列了这些要点:
- 推理强度:新集成建议从
medium开始;原来用none或minimal的改为low(API 会拒绝none)。Responses API 用reasoning.effort,Chat Completions 用reasoning_effort。 - 工具调用:两款模型都支持 Chat Completions,但工具调用需要走 Responses API。
- 不再支持的参数:Chat Completions 请求里去掉
temperature、top_p、logprobs、top_logprobs;Responses 请求去掉temperature、top_p、top_logprobs。 - 保持提示前缀不变:从 GPT-6.2 开始,如果在对话中途改动历史内容(前缀)、降级模型、更换终端用户或组织,API 会丢弃之前的推理内容,可能导致回答质量下降、token 用量增加。官方建议保持前缀不变,把新指令追加到对话末尾,这样也更容易命中缓存。
- 提示缓存:从 GPT-5.5 或更早版本迁移时,把
prompt_cache_retention换成prompt_cache_options.ttl,取值"30m"。 - 数据驻留:两款模型都支持美国和欧盟数据驻留(Standard、Fast、Batch),Ultrafast 仅支持美国。
八、安全方面
- 在 OpenAI 的 Preparedness Framework 下,两款模型的网络安全能力都达到 Critical 级别,生物和化学能力达到 High 级别;GPT-6.2 Astra 还是 OpenAI 第一款达到"AI 自我改进" High 级别的对外发布模型。
- 因此两款模型上线时对高风险网络安全请求加了更严格的防护,官方也承认这会限制一部分正当的漏洞研究和安全测试;需要这类能力的防守方可以通过 OpenAI Daybreak 使用专门的模型,官方表示之后会把 GPT-6.2 带到 Daybreak。
- 对齐评测中,两款模型在两项测试里更容易不主动说明阻碍工作的问题(例如文件缺失、搜索工具不可用)。OpenAI 已在 Codex 中加入指令大幅减少这类情况,并在继续研究。
参考来源
- OpenAI 发布页:Introducing GPT-6.2 Astra and Sol
- OpenAI API 模型页:GPT-6.2 Astra、GPT-6.2 Sol
- OpenAI API 文档:Using GPT-6.2、Changelog
- Codex 文档:Models