2026 年 3 月到 4 月中旬,不少开发者觉得 Claude Code 变笨了:改代码前不怎么读代码,会话里忘记自己刚做过什么,工具选得莫名其妙,配额还掉得特别快。社区里有人拿日志做了分析,也有人觉得「我没感觉变差」,争论了一个多月。
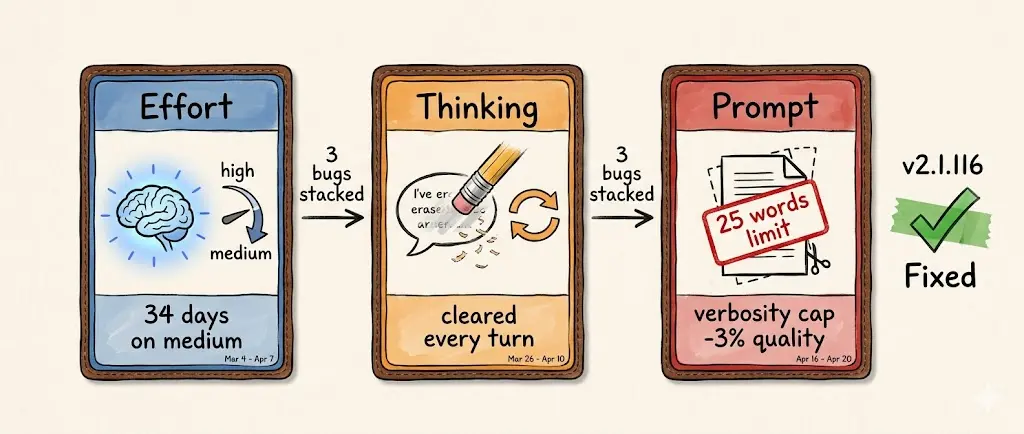
4 月 23 日,Anthropic 发了一篇事后复盘(postmortem),确认这段时间 Claude Code 的质量问题来自三个互不相关的改动,三个问题都已在 4 月 20 日的 v2.1.116 修复,并为所有订阅用户重置了用量额度。
这篇适合关心 Claude Code 变笨原因、想知道现在该怎么检查和设置的开发者。下面按时间顺序讲三个问题各是什么、为什么叠在一起会让人觉得「时好时坏」、Anthropic 后续的改进,以及你现在可以做的几项自查。
问题一:默认推理强度从 high 改成 medium
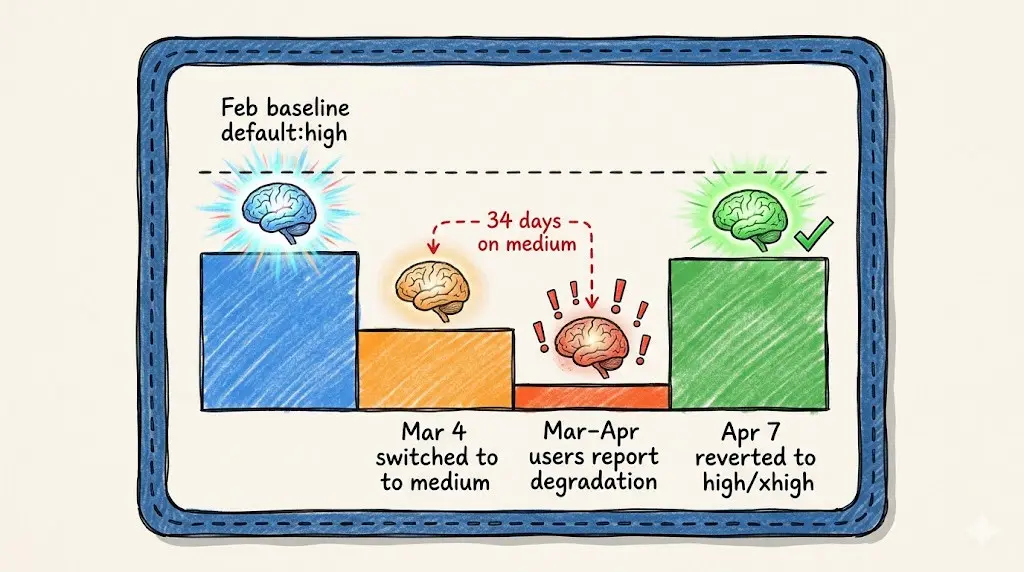
3 月 4 日,Anthropic 把 Claude Code 的默认推理强度(effort)从 high 改成了 medium。原因是有用户反馈 Opus 4.6 在 high 模式下偶尔思考太久,界面看起来像卡住了,延迟和 token 消耗也偏高。
内部评测的结论是:medium 智能略低,但大多数任务延迟明显更低,也更省配额。于是改了默认值,并在产品里弹窗说明了理由。
改完后用户开始反馈 Claude Code「变笨了」。Anthropic 先加了启动提示、内联的 effort 选择器,并恢复了 ultrathink,但大多数用户并不会去改默认设置。4 月 7 日,他们把这个决定撤回了,官方在复盘里也承认这是一个错误的取舍。这个问题影响 Sonnet 4.6 和 Opus 4.6。
社区数据怎么说
原文提到,GitHub Issue #42796 里有用户统计,thinking 长度从 2 月下旬开始明显下降,平均从约 2200 字符降到约 720 字符,时间上和这次改动对得上。社区认为这个跌幅比 high 换成 medium 一档能解释的更大,官方复盘没有直接回应这个数据差异。以上是社区数据,未经官方确认。
问题二:缓存优化的 bug 让 thinking 持续丢失
这是三个问题里技术上最复杂、影响也最大的一个。
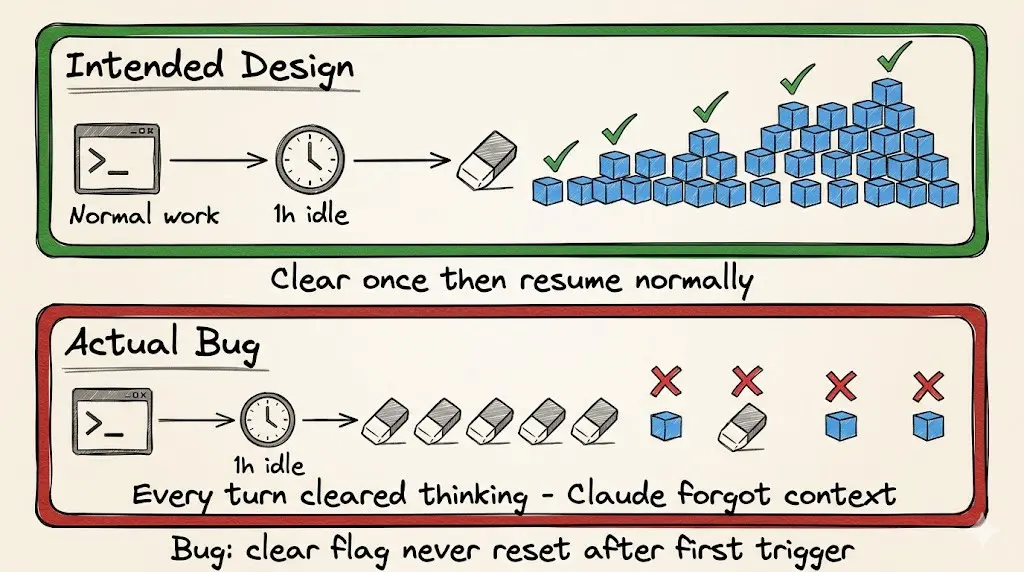
Claude 在推理时,推理内容通常会保留在对话历史里,后续每一轮它都能看到自己为什么做了那些编辑和工具调用。3 月 26 日,Anthropic 上线了一个优化:如果一个会话空闲超过 1 小时,恢复时清掉旧的 thinking,反正这一轮也会缓存未命中,少发一些未缓存的 token 可以降低成本。实现上用的是 clear_thinking_20251015 API header 加 keep:1。
设计本身没问题,但代码有 bug:清除本该只执行一次,实际上在会话之后的每一轮都执行了。会话一旦越过空闲阈值,之后每个请求都只保留最近一段推理。更糟的是,如果你在 Claude 执行工具调用的过程中发了新消息,新的一轮同样带着这个错误标记,连当前这一轮的推理也会被丢掉。
结果就是 Claude 还在继续干活,但越来越不记得自己为什么要这么做,表现为健忘、重复和奇怪的工具选择。
配额掉得快也和它有关
因为后续请求不断丢掉 thinking,请求内容一直在变,也就一直缓存未命中。Anthropic 在复盘里说,他们认为这正是同期「用量上限消耗比预期快」反馈的原因。缓存未命中为什么这么费配额、怎么用 /usage 和 /context 排查,可以看 Claude Code 配额为什么消耗这么快。
为什么一周多才定位到
官方给出的原因是两个不相关的实验干扰了复现:一个是仅内部的服务端消息队列实验,另一个是 thinking 显示方式的改动,后者在大多数 CLI 会话里把这个 bug 的表现压住了,所以内部测试外部版本时也没触发。
这个改动通过了多轮人工和自动代码审查、单元测试、端到端测试、自动验证和内部试用。加上只在空闲会话这种边角场景出现,Anthropic 花了一周多才找到并确认根因,4 月 10 日在 v2.1.101 修复。
问题三:系统 prompt 里的字数限制
4 月 16 日,随 Opus 4.7 一起上线的系统 prompt 里加了一行:
Length limits: keep text between tool calls to ≤25 words. Keep final responses to ≤100 words unless the task requires more detail.
目的是压一压 Opus 4.7 话多的问题。这行改动经过了几周内部测试,当时跑的评测没发现退步。后来在调查中用更广的评测集做消融测试(逐行去掉系统 prompt 看影响),其中一项评测显示 Opus 4.6 和 4.7 都下降了 3%,于是在 4 月 20 日的版本里撤回。这个问题影响 Sonnet 4.6、Opus 4.6 和 Opus 4.7。
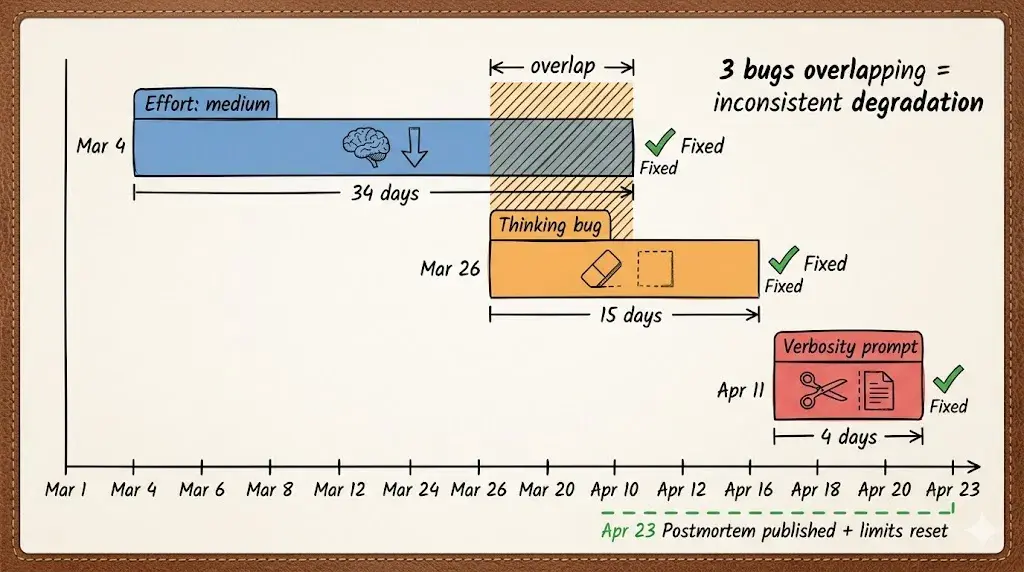
三个问题叠在一起,为什么像「时好时坏」
单看每个问题都不算灾难,但它们影响的用户群不同、生效时间也不同。有人没触发空闲阈值、手动切回了 high,几乎没受影响;有人三个问题全中。合在一起,看起来就是 Claude Code 在广泛地、而且不一致地变差。
这也解释了社区里「明明变差了」和「我没感觉」的争论:双方都没说错,只是碰上的问题组合不一样。官方也提到,这三项改动影响的是 Claude Code、Claude Agent SDK 和 Claude Cowork,API 和推理层本身没有受影响。
Anthropic 说以后怎么改
- 让更多内部员工用和公开版完全一致的 Claude Code,而不是带新功能测试的内部版本。
- 系统 prompt 的每次改动都要针对每个模型跑更广的评测,继续做逐行消融,并为可能影响智能的改动加入观察期、更广的评测和逐步放量。
- 改进内部使用的 Code Review 工具,并把改进版提供给用户。官方回测发现,在给足仓库上下文时,Opus 4.7 能在有问题的 PR 里找出这个 bug,Opus 4.6 找不到。想在自己的项目里用官方的代码审查插件,可以参考 Claude Code 官方插件使用教程。
- 新开了 X 账号 @ClaudeDevs 用来解释产品决策,同样的更新也会在 GitHub 上集中发布。
现在该怎么自查和设置
三个问题都已修复,下面几项检查可以确认你没有停在受影响的状态:
- 确认版本:运行
claude --version,确保不低于 v2.1.116。现在的版本早已高出很多,日常保持更新即可。 - 检查推理强度:用
/effort查看和调整。按 2026 年 10 月的官方文档,Opus 4.7 默认xhigh;Opus 5.5、Sonnet 5.5、Haiku 5.5 默认medium;其他支持 effort 的模型默认high。如果你在 3 月手动改过默认值,或者现在用的是默认 medium 的新模型、又觉得复杂任务不够深入,可以按任务手动调高。 - 长会话不用刻意断开:thinking 被反复清除的 bug 已修复,空闲后恢复会话不会再一直丢推理历史。
- 遇到质量问题就反馈:官方在复盘里特别提到,用
/feedback提交问题、或在网上贴出可复现例子的用户,最终帮他们定位并修复了这些问题。
总结
这次 Claude Code 变笨不是错觉,而是三个独立改动在不同时间、对不同用户叠加的结果:默认 effort 下调、空闲会话清除 thinking 的 bug、限制输出字数的系统 prompt。官方已在 v2.1.116 全部修复,并重置了订阅用户的用量。
对日常使用来说,比较实际的做法是保持版本更新、知道自己当前用的 effort 档位、遇到异常及时用 /feedback 反馈。
想按自己的节奏使用 Claude Code,可以在 AIGoCode 上直接使用 Claude Code 和 Codex。
参考链接
- Anthropic 事后复盘:An update on recent Claude Code quality reports:https://www.anthropic.com/engineering/april-23-postmortem
- Claude Code 文档:Model configuration(effort 档位与默认值):https://code.claude.com/docs/en/model-config
- 社区数据分析 Issue #42796:https://github.com/anthropics/claude-code/issues/42796